Gecen ay Github Copilot icin 173 dolar ödeme yapmisim. Sürekli Claude Opus 4.6 kullandim. Yazilan kod 5 kisilik senior bir ekibin belki 2 ayda cikacagi türdendi. Bir senior yazilimcinin tüm giderleri ile maliyeti 200K TL civarinda. Bu durumda 2 milyon TL gider karsisinda 173 dolar duruyor. Bir girisimci icin bundan daha güzel bir gider azaltma kalemi , ama bir yazilimci icin bundan daha hüzünlü bir tablo olamaz, cünkü 5 kisilik bir senior ekibin calisma dinamigi, ruhu, pratigi ve eglencesinin parcasi olmanin karsiligini para ile ölcmek imkansiz.
Yeni düzen bu. Ne yapacagiz? Alisacagiz.
Kategori arşivi: Yapay Zeka
Prompt Engineering
Herkes prompt yazarken sade ve detayli bir dilin yeterli oldugunu düsünüyor. Prompt yazarken kullanilan dil ilk etapta cok önemli degil, yani gramatiksel kusursuz cümlelerin yazilmasi gerekmiyor. Daha önemli olan sey baglam yani context. Context yapilacak is hakkinda plain text haricinde resim, url, kod, video, teknik terimler vs gibi yapilacak ise isaret eden yapilar ihtiya etmek zorunda.
LLM’i karanlik odada duran bir cisim gibi düsünün. Size dogru sonuclar verebilmesi icin o odayi aydinlatmaniz gerekiyor. Bu sadece context üzerinden ve onun nasil yapilandirildigi ile ilgili bir durum. Ona siir okuyarak nereye varabilecegimiz asikar. Ama devrik cümlelerle bile yarim yamalak teknik cerceveyi tanimlamak yeterli olabilir.
Bu yüzden prompt engineering denilen seyi en iyi yine yazilimcilar yaparlar, cünkü yapilan isi teknik olarak en iyi onlar ifade edebilirler. Vibe coding yapanlari üzdügüm icin tekrar kusuruma bakmasinlar. Yazilimci kimligine bürünemeden ürün cikarmaya calismak abesle istigaldir.
Tuvaldeki Uygulama
Degerli arkadaslar,
yapay zeka ile yazilimin nereye dogru gittigini size resmetmeye calisacagim. Kendim, biraz sonra okuyacaklarinizi intensif bir sekilde son günlerde yasiyorum, yani dogrudan tecrübelerimle sabit.
Ben sadece 3 gün icinde bir device management sistemi gelistirdim. Bu cihaz tarafinda go ile bir agent, sunucu tarafinda bir spring boot + angular uygulamasi. Iki taraf icinde hic kod yazmadim. Sistem düsündügümden cok daha iyi tasarlandi ve su anda calisiyor.
Önümüzdeki zamanlarda yazilim artik asagida anlatmaya calisacagim sekilde yapiliyor olacak. Size düsen yazilimci olarak bu isin neresinde oldugunuzu düsünmeniz.
Simdi beyaz bu tuval hayal edin. Bir ressam hayal ettigi seylere bu tuval üzerinde hayat verir.
Bizler de yazilimci olarak buna benzer birsey yapiyoruz. Aramizdaki tek fark, bizlerin müsterilerimizin istekleri dogrultusunda o tuvali sekillendirmemiz.
Simdi bu tuvali bir yazilimci perspektifinden bos bir web sayfasi, mobil ya da desktop uygulama ekrani olarak düsünün.
Simdi tekrar ressama geri dönelim. Ressam her fircasi ile tuval üzerinde hayal ettigi resmi olusturmaya baslar. Ayni seyi bir uygulama yaptirmak isteyen herhangi bir sahis icin gözümüzde canlandiralim. Bu noktadan itibaren anlatacaklarim, gelecekte yazilim ürünlerinin nasil gelistirilecegini gösteriyor olacak.
Sahis bos ekranin karsisinda oturuyor ve yapay zekaya sesli olarak su komutlari veriyor:
=== Sahis ===
Sol tarafta bir sidenav menü istiyorum. Icindeki söyle söyle menü elementleri mevcut.
=== Yapay Zeka ===
Calismaya basliyor ve menüyü olusturdugunu söylüyor. Müsteri menüyü aninda o bos ekranda görüyor.
=== Sahis ===
Simdi orta bölümde müsteri listesini görmek istiyorum. Ayrica müsterileri sana verecegim kriteler dogrultusunda filtreleyebilmeliyim.
=== Yapay Zeka ===
Gerekli tüm customer entity, repository, service, controller, liquibase script, angular component ve diger yapilari olustuyor ve sahis talep ettigi müsteri listesinde ekranda görmeye basliyor.
Müsteri taleplerini arka arkaya siraliyor ve bir ressamin tuval üzerinde resim yaparcasina uygulama yavas yavas ekranda belirmeye basliyor. Bu sadece bir mock, mvp ya da prototip degil, tam tesekküllü bir uygulama.
Benim son üc günüm hemen hemen bu anlattigim sekilde gecti. Claude opus 4.5 kullaniyorum. Su an bu benim isimi mükemmel bir sekilde gören bir LLM. Daha ileri versiyonlari programcilara ihtiyac duyulmadan benim resmetmeye calistigim sekilde calisiyor olacak. Herhangi bir uygulamaya ihtiyaci olan birisi ekran basina oturacak ve ne istedigini sadece söyleyecek ve gerisi bir sihibazin isiymis gibi ekranda belirmeye baslayacak.
Yapay Zeka Ile Deklaratif Programlama Cagi
Promptlar ile kod yazdirmak deklaratif programlama tarzidir. Nasil degil ne yapilacagini beyan etmemiz yeterlidir.
Deklaratif apiler araciligiyla neyin nasil yapildigini bilmeden zaten yillardir deklaratif programliyorduk. Simdi nasil kismini LLMlerin üstlenmis olmasi bizim calisma ve düsünme tarzimizda birsey degistirmez.
Bugünün programciligi ehliyeti olan herkesin istedigi marka bir araci sürebiliyor olmasi ile ayni seydir. Ehliyetim var ama 3 silindirli ya da icten yanmali bir motoru süremem demek ile yapay zekanin yazdigi koda güvenmiyorum demek ayni seylerdir.
Programcilikta müsterinin istekleri esastir. Yapay zeka devrimi ile tamamen buna odaklanabilecegiz büyük bir firsat elimize gecmis bulunuyor. Programciligin gelecegi bundan sonra cok daha parlak ve cok daha eglenceli.
Yazay Zeka ile Otomasyon Cilginligi
Artik nereye bakarsaniz claude code ya da türevleri ile yazilim projelerinde her seyi otomatize etmeye calisanlari göreceksiniz. Kesinlikle bir satir kod yazma niyetleri olmadigi gibi gereksinim analizinden dogan artefaktlari yapay zekanin alabilecegi bir yerde (örng. backlog) tutup, gerisini full otomatize etmeyen calisan tiplerden bahsediyorum. Genelde bu tipler “aksamdan bir dügmeye bastim, sabah kalktigimda tüm uygulama hazirdi” minvalinde söylemler paylasirlar.
Iste bunlar vide coding yapan sahislar arkadaslar. Gercek anlamda yazilim ile ugrasan birisinin izleyebilecegi bir yol degil anlatilanlar. Yazilim gercekten tecrübe gerektiren birsey ve bahsedildigi sekilde otomatize edilmesi mümkün degil. Bunun icin gereksinim analizlerinin %100 gercekleri yansitiyor ve en kücük birimlerine kadar parcalanmis olmasi gerekiyor. Bu size birsey hatirlatti mi? Evet waterfall!
Evet, ben tüm kodu artik yapay zekaya yazdiriyorum, ama bir prompt ve dolayli olarak bir gereksinim adam akilli tanimlanmamis olsun! Bu durumda kesinlikle kabul edebilecegim bir sonuc ortaya cikmiyor. Kodu silip, prompt refactoring yaparak sifirdan almam gerekiyor.
Kod yazma derdinden kurtulduk diyelim, ama bu bizim baska bir alanda cok daha iyi olmamizi gerektiriyor: gereksinim analizi, onun makul parcalara bölünmesi (user story), onay/kabul kriterlerinin tanimlanmasi, yapay zekanin promptlar araciligi ile yönlendirilmesi ve isini bitirdikten sonra review.
Test Yazmaya Gerek Kalmadi
Artik kodu yapay zeka yaziyor, bunu kabul ettik. Peki biz yazilimci olarak isin neresindeyiz? Bunu burada uzun uzun anlatmak istemiyorum. Yazilimci olarak isimiz baska alanlara kaymis durumda, ama artik kod yazmayacagiz.
Artik en önemli görevlerimizden birisi test yazmak / yazdirmak ve yapay zekanin olusturdugu kodun yani olusturmak istedigimiz ürünün davranislarini test etmek. Ama test kodunu da tamamen yapay zekaya birakmak, onun calip, onun oynadigi bizim ise sadece seyredici oldugumuz bir ortam dogurur. Bu da istedigimiz bir durum olamaz. Bizim girdileri ve ciktilari kontrol edebilecegimiz yeni bir soyutluk seviyesine ihtiyacimiz var.
Cogumuz “yapay zekaya testleri de yazdirabiliriz, hem de bunu bizden daha genis kapsamli yapar” diyecektir. Burada bazi problemler görüyorum:
- Kodu degistiren yapay zekanin testleri de adapte etmesi tehlikeli ve bu kontrol edilemez sonuclar dogurabilir (kendi calip, kendisi oynar metaforu)
- Statik test kodu sürekli kirilmaya müsait oldugundan, bakimi cok zordur. Yine burada “bunu yapay zeka halleder” demek uygun degil, cünkü elimizde tutmak istedigimiz bir kontrol mekanizmasina ihtiyacimiz var
- Test etmek istiyoruz lakin kod yazmak, bakimini yapmak ve adapte gibi detaylar ile ugrasiyoruz. Bunun yerine nasil yerine ne sorusunu sormamiz gerekmektedir. Neyi test ediyoruz sorusu test etmek istedigimiz isletme mantigina odaklanmamizi saglayacaktir. Burada imperatif düsünce yerine neyin test edildigini tayin ettigimiz deklaratif düsünce tarzina gecmis oluyoruz.
Ne yapabiliriz?
Artik düsüncelerimizi belli kaliplara sokarak bilgisayar ile calisma zorunlulugumuz ortadan kalkmis durumda. Biz yapay zeka ile kendi dilimizde iletisim kuruyoruz. Ciktilari kontrol etmek icin kullanacagimiz yeni soyutluk seviyesi de bu.
Bir uygulamanin feature olarak tanimladigimiz ve implemente ettigimiz degisik türde davranislari olabilir. Bu davranislarin uygulama tarafindan sergilenebilmesi icin kullanicilar tarafindan tetiklenmeleri gerekir. Tanimli bir input gerekli davranis bicimi uygulandiktan sonra tanimli bir output doguracaktir. Programci olarak bu girdi ve ciktilari kendi dilimizde tanimlayabilir ve yapay zeka ya da test catisi tarafindan uygulamaya karsi kosturulmalarini saglayabiliriz.
Kendimden bir örnek vereyim. Ben testleri artik bir yml dosyasinda su sekilde specler olarak tanimliyorum:
name: 'Clean Start Test'
description: 'When SQLite-Database deleted, then app starts in default setup mode'

tags:
  - clean

setup:
  - 'Delete database'
tests:
  - name: 'App starts with setup screen'
    steps:
      - 'Start the app'
      - 'Wait 2 secs '
      - 'Expect that "Lütfen cihaz türünü seciniz" is visible'
Sonnet’e bu specleri okuyup (parse, analyse), teste dönüstürüp (generation), kosturabilen (execution) ufak capli bir framework yazdirdim.
Bu specler tanimlamis oldugum onay/kabul kriterlerini ihtiva ediyor. Bir nevi BDD (behaviour driven development) yapiyorum, ama onun ismi artik BDD degil, BDC (behaviour driven check). Testleri bu sekilde tanimladiktan sonra, kosturuyorum. Sonnet’in olusturdugu test framework testleri kosturmadan önce spec dosyalarini yapisal analiz yapiyor ve akabinde test kodunu olusturarak, bunlari kosturuyor.
Ben bir flutter uygulamasini test etmek icin bu yöntemi sectim. Bir web uygulamasini bu sekilde tamamen yapay zeka yardimi ile test etmek cok daha kolay. Playwright isminde bir MCP server mevcut. Onun yardimi ile Sonnet gibi bir LLM spec dosyasi icinde bulunan test adimlarini MCP araciligi ile bir web tarayicisina baglanarak kosturabilir.
Kisaca özetleyecek olursak:
- Artik test kodu yazmiyorum ya da bakmini yapmiyorum.
- Testlerim kirilmiyor.
- Uygulamanin davranislarina odaklaniyorum ve neyin test edilmesini gerektigini tayin ediyorum.
- Yapay zekanin sadece kodu adapte etmesine izin veriyorum, test kodunu (specler) degil. Bu sekilde neyin test edilecegi hakimiyeti bende kaliyor.
- Yapay zekadan destek alarak genis kapsamli specler olusturabiliyorum.
Bu speclerin olusturulma adimini da su sekilde otomatize edecegim. Jira bünyesinde yeni bir feature tanimlarken onay/kabul kriterlerinin de tanimlanmasi gerekiyor. Ben bir kodlama ajanina bu feature i implemente etmesini söyledigimde, ajan ilk adim olarak gerekli test spec dosyalarini. olusturacak. Ajan isini tamamladiktan sonra test icin olusturdugu spec dosyalarini derleyerek, kosturuyor olacak. Bir hata ile karsilasmasi durumunda implementasyonun istenen seviyede olmadigini anlayarak, gerekli adaptasyonlari yapmaya baslayacak. Böyle bir döngü ile aslinda hic insan interaksiyonu olmadan bir uygulamayi feature by feature implemente ettirmek mümkün.
Test ekibine hos geldin yapay zeka :)
LLM’ler Cagimizin Yeni Derleyicileri
Su anda LLM ler turing complete degil. Er ya da gec LLM ler derleyicilerde oldugu gibi deterministik sonuclar üretmeyi ögrenecekler.
Assembly kodunun elden yazildigi günler bunun icin güzel bir örnek. Yüksek dil derleyicileri assembly kodu / microcode üretmeye basladiklarinda, assembly programcilari bu ciktilara cok güvenmez ve ciktiklari elden kontrol ederlermis. Bunu artik kimse yapmiyor, cünkü derleyicilerin %100 dogru calistiklarindan eminiz. Hata derleyici de degil, yazilimcinin yazdigi koddadir.
LLM ler cagimizin yeni derleyicileri ve ciktilari kisa bir zaman sonra kimse kontrol etmeyecek ve oldugu gibi dogru olarak kabul edilecek. Ciktinin calismiyor olmasinin tek sorumlusu yine o cikti icin gerekli olan bilgiyi (prompt, spec, context) yanlis tanimlayan programcisi olacak.
Kim Code Review Yapar?
Copilot / Sonet 4.5 sadece fkir olarak tanimladigim uygulama icin genis kapsamli feature listesi olusturup, bunlari 45 dakika icinde 6.319 satir kod ve 46 Dart dosyasi olarak implemente etti. Ayni zaman zarfinde uygulamanin ihtiyac duydugu backend API de olustu.
Bu ufak capli bir uygulama idi. Genis capli bir uygulamada kod satir adedi 100K ya ulasabilir.
Soru su: hangi zaman diliminde kac programci bu kadar kodu review edebilir?
Olusan darbogaz görülüyor mu? Bu sadece code review kismi. Bunun gibi kurumsal projelerde asilmasi gereken bircok teknik ve bürokratik engel mevcut.
Artik yazilimci ekipleri günler icinde olusan milyonlarca satir yeni kod ile bogusuyor olacaklar.
Isin altindan kalkmanin tek yolu, olusan kodu oldugu gibi kabullenip, onay/kabul testleri ile uygulama davranislarini test etmekten geciyor. Uygulama istenilen davranis bicimini sergiledigi sürece kodun nasil implemente edildigini önemli degil. Uygulama ve dolayli olarak yapay zekanin olusturdugu kod blackbox mahiyetinde ve her daim degistirilebilir olma statüsünü tasimaktadir.
Junior Yazilimcilar ve Vide Coding
“Vibe coding” terimi mevcut durumu tanimlamak icin artik yetersizdir.
Genc yazilimcilar artik vibe coding yapmiyorlar, usta cirak iliskisi icinde gerekli tüm temel ve üst bilgiyi hocalarindan (AI) ögreniyorlar.
Bizim dönemimizde eksik olan usta-cirak iliskisi artik olusmus durumda. Genc yazilimcilari bu nimetten faydalanmalari yerine uyarmak anlamsiz. Yaptiklari vibe coding degil, yeni düzenin ögrenme süreci ve bu sürecin sonunda kendilerini iyi yetistirmis olacaklar.
Neden bu kadar genc yazilimcilara güveniyorum? Cünkü bir yazilimci meraklidir. Merakli olmayan birisi yazilimci olamaz. Bu merak onlari yapay zeka tarafindan olusturulan kodun nasil calistigini anlamaya istecek ve bu sekilde ögrenecekler. Imtihan icin kopya hazirlayan ögrencileri düsünün. Onlarin kopya cekme tesebbüsleri zaten gereken seyleri ögrenmelerini sagladi.
Bu sürece yeni bir isim konmasi gerekiyor. Genc yazilimcilara sadece vibe coding yapiyorlar demek artik dogru degil.
Peki vibe coding nedir? Hicbir yazilimci egitimi ve altyapisi olmayan ve daha önce kod yazmamis birisinin yapay zekaya kod yazdirip, programci oldugunu düsünmeye baslamasidir. Burada kisa vadece prototip ve mvp tarzi ürünler cikabilir lakin sürdürülebilirligi yoktur, cünkü yazilim sadece kod yazmaktan ibaret degildir ve ustalik gerektirir.
Sizce junior programcilar icin vibe coding yerine hangi terimi kullanabiliriz? Önerilerinizi bekliyorum.
Analog Yazilimdan Dijital Yazilima Gecis
Yazilim camiasindaki güncel gelismeler Alice harikarlar diyarinda gibi hissettiriyor.
Artik iki dünya olustu: analog yazilim, dijital yazilim.
Benim gibi uzun yillardan beri yazilim yapanlar analog yazilim dünyasinda yetistiler.
Bugün yazilima yeni basliyanlar, dijital yazilim dünyasinin parcasi olarak yetisecekler. Onlarin mevcut yapilara adapte olmalari cok daha kolay.
Birkac ay öncesine kadar “vibe coding” in yeni baslayanlar icin uygun bir yöntem olmadigi fikrine sahiptim. Bu fikrim son günlerde degismis durumda!
Genc arkadaslar: hic vakit kaybetmeyin ve vibe coding yapmaya baslayin. Sizler dijital native olarak bu yeni yazilim dünyasina dogdunuz ve orada yetiseceksiniz. Yaninizda artik tam tesekküllü ve dünyanin en donanimli yazilimci ustasi oturuyor. Size yazilimin nasil yapilacagini en kisa sürede ögretecek. Sürekli ona kod yazdirin ve anlamadiginiz yerleri sorun. Bizim yillar boyu calisarak ögrendigimiz konulari siz isik hizinda ögreniyor olacaksiniz.
5 yil icinde cok daha iyi programcilarin yetistigini görecegiz.
Bir girisimci olarak yazilim ekibimde yapay zeka ile calisma süreclerine hakim junior yazilimcilara öncelik verecegim. Onlarin yetistirilmesi ve konuya hakimiyetleri cok daha kolay olacak.
Senior programcilar analog yazilimdan dijital yazilima gecis sürecinde avantajli konumdalar eger bu degisimi kabul edip, yeni süreclere adapta olabilirlerse.
1990 yilinda kod yazmaya baslamis ve son 30 yildir profesyonel yazilimci olarak calisan birisi olarak sunun altini cizerek söylemek isterim:
“Yazilim konusunda ben bundan daha heyecanli bir gelisme yasamadim”
Mindshift
Benim 20 sene imperatif program kod yazdiktan sonra fonksiyonel proglamaya gecisim cok zor olmustu. Beynimin en son hücresi bile imperatif düsünmeyi yeglerken, artik bunu baska türlü yapiyoruz demek yeterli olmuyor. Insanin bu kemiklesmis düsünce sablonlarini asmasi cok zor.
Yapay zeka baglaminda günümüzde senior (10+ yil tecrübe) olan programcilarin da buna benzer bir problem ile karsi karsiya olduklarini düsünüyorum.
Vibe coding yapan ama yapay zeka araclarini kullanmayi ögrenmis junior programcilarin bahsi gecen eski dönem programcilarini solladiklarini görebiliriz.
Bu sebeple degisime karsi koymadan hizli bir sekilde adapte olmak gerekiyor. Aksi taktirde programciliktan ekmek yemek artik mümkün olmayabilir. Bunun ilk ibareleri uzun yillar programcilik yapmis senior programcilarin sektör degistirme ya da yönetim kademesine gecmeleri ile kendisini gösterecektir.
Code Generation ve Generative AI
Code generation konusunda nereden nereye geldik…
- Üniversite yillarinda CASE araclari ile UML modelleri hazirlar ve tüm interface, dto ve entity gibi siniflarin otomatik olarak olusturulmasini saglardik.
- Corba ve IDL ile servis arayüzlerini (interface) tanimlardik, ORB üzerinden remote object ile iletisim icin gerekli lokal proxy stub kodu otomatik olusturulurdu.
- 2000 öncesi EJB döneminde local ya da remote interface siniflari olustururduk, implementasyonlarini EJB compiler/container kendisi yazip, kostururdu.
- AOP (Aspect Oriented Programming) ile aspektler yazardik, gerekli baglantilari olusturmak icin aop derleyicisi kod olusturdu ve derledi.
- Spring ile tüm konfigürasyonu xml dosyalarinda olustururduk, proxy implementasyonlarini ve enjeksiyonu Spring IOC container yapardi. Daha sonra anotasyonlar kullanmaya basladik, arka planda gerekli kod yine build ya da runtime icinde olusturulurdu.
- Mapstruct ile entity – dto mapping icin gerekli kodu yazmaya gerek kalmadi.
- Lombok ile tüm get/set metotlarindan kurtulduk.
Kodu generate ettirmek icin kod yazarken, simdilerde kod yazmadan gen ai ile tüm kodun olusmasini seyrediyoruz.
Bundan sonra ne gelecek?
Makina kodu yazmanin ne kadar zor oldugunu hatirlayalim. Assembly ile programcilikta büyük bir sicrama yasandi. Bu da yetmedi ve Fortran, C ve Java gibi diller ile daha yüksek bir soyutluk seviyesine cikildi.
Böyle bir sürecin aynisi yapay zeka kullanimi icin yasanabilir. Artik yapay zekanin ürettigi koda hakim olamayan programcilar icin yeni araclar gelistirilecek. Onlar yardimi ile yapay zeka kullanimi daha da soyutlanacak ve kontrol edilebilir hale gelecek.
Sistemsel olarak imperatif programlama ile yapay zekaya kodu nasil yazilacagini söylemek ayni seyler. Bu detaylarda kaybolmak anlamina geliyor. Oysaki deklaratif tarzda ne yapilacagini söylememiz yeterli. Gerisini kullandigimiz programlama dili, arac ya da yapay zeka halletmeli. Gelecekte daha cok imperatif araclar kullanarak kod yaziyor olacagiz.
Yazilimcilar Icin Yapay Zeka Kullanma Klavuzu
Ben günlük islerimde IntelliJ / Android Studio ve Copilot Claude Sonnet 4.5 yapay zeka modelini kullaniyorum.
Zaman icinde kendim icin yapay zeka öncesinden cok farkli bir calisma modeli gelistirdim. Bu bir nevi yapay zeka kullanim klavuzu. Yapay zeka araclari gelistirildi lakin bunlarla nasil programci olarak calismamiz gerektigine dair bize bir kullanim klavuzu verilmedi. Herkes kendi basina bunlari kesfetmek zorunda. Bu konuya katki amaciyla kendi tecrübelerimi paylasmak istedim. Hep birlikte belki genel kapsamli bir calisma ve kullanim klavuvuzu gelistirebiliriz. Bu yazim benim icin bir nevi “programming best practices with ai” görevini görecek.
Yeni Soyutluk Seviyesi:
Eskiden programci olarak mimari, nesneye yönelik programlama, tasarim sablonlari gibi konularla istigal ederek, program gelistirirdik. Simdilerde daha yüksek bir soyutluk seviyesinde, yapay zeka ile gelen prompt engineering, context, mcp, token ve agent gibi yeni terminoloji, yöntem ve araclari kullanarak program yaziyoruz. Bu ister istemez program yazma tekniklerimizi, aliskanliklarimizi ve soyutlama yetimizi dogrudan etkiliyor. Burada atabilecegimiz en dogru adim soguk suya atlamak yani biran önce bu yeniliklere adapte olup, gerektigi sekilde hareket edebilmek olacaktir.
Dogru Model:
Ben gpt 5 ve türevleri ile cok saglikli sonuc alamadim. Gemini türü modelleri de denedim. Lakin Claude Sonnet 4.5 ile en iyi sonuclari aldim. Bu konuda herkesin LLM secimi yapilan isin baglamina göre degisecektir. Dogru modelin calisma verimliligini artirir, yanlis model ile calismak günün sonunda hicbir sey basaramamislik hissi birakabilir.
Copilot Ayarlari:
Copilot icin proje workspace icinde copilot-instructions.md isimli dosyada yapay zekanin islem yapmadan önce dikkate almasi gereken hususlari listeledim. Burada metotlarin nasil yapilandirilmasi gerektiginden, UI tasarimi, kullanilacak catilar, kod stili ve testlere kadar bircok konuda yapay zekaya yardim edici bilgiler vermek mümkün. Buradaki amac ciktinin daha deterministik ve belli bir yapida olmasini saglamak.
Prompt Mühendisligi:
Bir yazilim mühendisi artik bir prompt mühendisine dönüsmek zorunda. Ben bu tabiri cok hos bulmuyorum, lakin programcinin artik kendi anadilinde, gelistirilmesini istedigi uygulamanin nasil olmasi gerektigine dair en ince detaya kadar bunu net bir sekilde ifade edebilir ve kagida dökebilir hale gelmesi gerektigi zorunlulugunun oldugunu düsünüyorum. Yapay zeka ile interaksiyonda destan yazmaya gerek yok. Prompt ne kadar sade ise, o oranda ciktinin beklentileri karsiladigini gördüm. Buradaki en önemli nokta context olarak ifade edilen kapsama alaninin iyi tanimlanmis ve dogru verilerle doldurulmus olmasidir. Ben örnegin copilot ile calisirken her prompt icin gerekli siniflari, görselleri ve belgeleri context icinde tanimliyorum. Bu sekilde copilot ve dolayli olarak Claude Sonnet benim prompt icinde ifade ettiklerimi workspace icinde yer alan icerikle daha iyi eslestirip, yapilmasi gerekenleri tespit ettikten sonra, hayata gecirebiliyor.
Kisaca ne kadar prompt, o kadar köfte!
Prompt History:
Ben workspace icinde prompt.md isminde bir dosyada, kullandigim tüm promptlari tutuyorum. Aslinda güncel prompt icin aklima gelen ilk düsünceleri bu dosyaya eklemeye basliyorum. Ilk düzeltmelerden sonra promptu en güncel hali ile copilota veriyorum. Zaman icinde bu bir nevi dokümentasyona dönüsüyor ve günler sonra tekrar yazdiklarima göz atarak, nasil buraya geldigime dair saglam bir fikre sahip olabiliyorum. Bazen copilot ile olusan kodu revert / rollback yapiyorum. Bu gibi durumlarda da ayni promptu history dosyasinda lokalize ederek, yeniden kullanma sansim oluyor.
Architecture First:
Hicbir ön hazirlik yapmadan copilota kod yazdirmanin ismi vide coding. Bunun nereye varacagi malum. Bu sebeple yeni bir uygulamaya basladigimda kesinlikle yapay zeka araci kullanmiyorum. Uygulamanin temellerini kendi bilgi, tecrübem ve düsüncelerim dogrultunda elimle atmam gerekiyor. Bu sekilde ilk mimari ve katmansal yapi ortaya cikiyor. Akabinde yapay zeka olusan yapiyi kendi isinde kopyalarak, gerekli kod parcalarini olusturmasi daha kolay hale geliyor.
Building Blocks & Subprompting:
Ben bir uygulama özelligini (feature) yapay zekaya bir prompt ile yaptirmaya calismiyorum. Bu cok iyi sonuclar veren bir yöntem olmadi benim icin. Bunun yerine uygulama özelligini kücük parcaciklara bölerek, her parca icin bir prompt yaziyorum. Burada öncelik her zaman uygulama özelliginin temelini olusturan domain siniflari, veri tabani yapisi, repository ve servis siniflari gibi yapilari ortaya cikartacak temel promptlar araciligi ile uygulama özelliginin temellerini atabilmek. Temeller insa edildikten sonra yeni promplar ile kat cikilmasi yani istenilen türde bir uygulama özelliginin programlanmasi kolaylasiyor.
Gereksiz Muhabbet:
Copilot ile gereksiz yere “iyi yaptin aferin” yada “tesekkür ederim” gibi seyler yazarak sohbet etmiyorum. Bu tür geri bildirimlerin programci olarak size hicbir faydasi yok. Yapay zeka bu sebeple gereksiz yere enerji sarf eder ve siz de en kötüsü faydasiz bir islem icin token harcamis olursunuz.
Sürekli Commit:
LLM ile calismak klasik programlama mantigina aykiri bir durum. Programcilik mantik geregi deterministik ve yer yer idempotent olmak zorunda. Lakin ben ayni promptun ayni sonucu verdigine hic sahit olmadim. LLM’ler deterministik yapilar degil, istatistiksel yapilar, yani cikan sonuclar da ne yazik ki istatistiksel olabilirlik hesaplamalarina dayaniyor yani deterministik olamiyorlar.
Bunu bildigim icin her prompt öncesinde son yapilanlari korumak amaciyla git commit ile tüm degisiklikleri saglama aliyorum. Prompt sonrasinda olusan program parcalari hosuma gitmiyorsa, rollback ile cikis noktama geri dönüyorum ve promptu yeniden sekillendirip, devam ediyorum. Sonuc hosuma gittigi taktirde code review yaparak tekrar bir commit aliyorum ve bir sonraki prompta geciyorum.
Olmadiysa Rollback:
Biraz önce bahsettigim gibi LLM ciktilari deterministik degil. Bunun yani sira prompt ve context yetersiz kaldigi icin cikti istenilen türde olmayabilir. Bu durumda kodu degistirmek yerine rollback yaparak, sifirdan basliyorum. Kodu degistirmek ve calistirmaya calismak cok zaman kaybina sebep olabilir. Bu yüzden sifirdan baslayabilek her daim daha iyi bir opsiyondur.
Regresion Testing:
Eger promptlar ile test yazmiyorsaniz ya da yazdirmiyorsaniz, gecmis olsun. Er ya da gec kullandiginiz LLM daha önce yaptigi degisiklikleri ezecek ve calisir durumda olan program parcalari calismaz hale gelecektir. Buna programcilar arasinda regresyon – geriye gitme denir. Bunun icin özel bir test kategorisi bile vardir: regresyon testleri.
Ne kadar yapay zeka da dense, LLM bir yapay zeka olmakdan isik yili kadar uzak. Bu yüzden genis kapsamli degisikliklerde uygulamanin bazi bölümlerinde istenmeyen degisiklikler vücut bulmus olabilir. Bunlari tespit etmenin tek yolu, otomatik calisan testlerdir.
LLM’i sürekli refactoring yapan bir makina gibi görmek gerekiyor. Her prompt potansiyel bir refactoring. LLM istedigi sekilde kodu yogurur. Bunun mutlaka ve mutlaka yan etkileri olacaktir. Bunlari tespit etmenin tek yolu test yapmaktir.
Saglam bir test seti olmayan programcinin promptlar ile gelistiridigi bir uygulama canliya alindiginda en iyi ihtimalle deterministik olmayan davranislar sergileyebilirken, en kötü ihtimalle calismaz hale gelebilir. Bu sebeple her prompt mutlaka gerekli test setinin olusmasini mecbur kilmalidir.
Continuous Review:
LLM ciktisi bir kodun programci tarafindan iki sebeple gözden gecirilmesi yani code review yapilmasi gerekmektedir.
Ilk sebep kodun ne kadar gecerli oldugunun kontrolüdür. Kod genel gecerli kurallara uymadigi icin yeniden yapilandirilabilir. Bunun icin mutlaka bir code review yapilmasi zorunludur.
Ikinci sebep benim icin daha önemli bir sebep. Ben LLM ciktisi kodu okuyarak cok sey ögreniyorum. LLM tarafindan olusturulan kodun, bu gezegen üstünde yayasan tüm programcilarin acik kaynak olarak github ve co üzerinde tuttuklari kodlarin damitilmis hali oldugunu düsünecek olursak, her ciktidan cok sey ögrenmenin ne kadar enfes olacagi asikardir.
Her dönemi kendine has (bknz. Kant – Zeitgeist) bir ruhu, yasam ve calisma sekli var. Programcilar olarak yeni bir döneme girdik. Hizli adapte olanlar ayakta kalirken, digerlerine ne olacak bilinmez.
Özcan Acar
EOF (End Of Fun)
Bindikleri Dalı Kesiyorlar
Kendi bindikleri dalı kestiklerini anladıkları için çark etmeye başladılar.
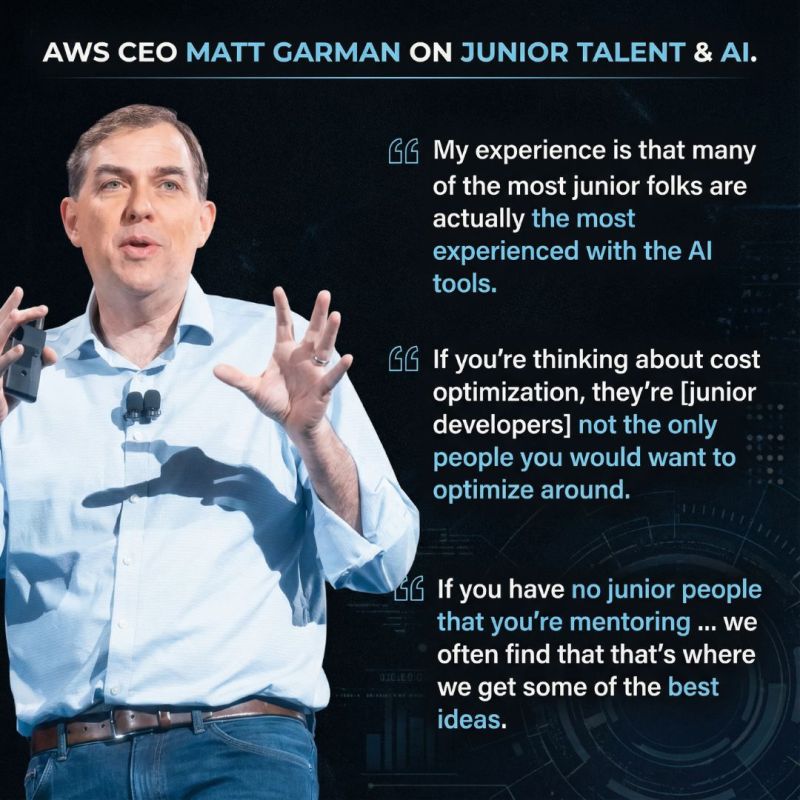
Yapay zeka yazılımcıyı ortadan kaldıramaz. Yazımcılar yapay zeka araçlarını çok iyi kullanır hale gelecekler. Senior olanlar junior olanların gelişimine odaklanarak usta pozisyonuna geçecekler. Çırak olan junior yazılımcılar ustalarından ve yapay zekadan bu işin nasıl yapıldığını öğrenip, kendileri de zamanı geldiğinde usta konumuna yükselecekler. Bu şekilde şimdiye kadar var olmayan usta-çırak ilişkisi oluşturulmuş olacak.
Yazılımcılar İçin Yeni Dönem Başlıyor
Sadece mevcut bilgi ve tecrübe seviyesini ölçmeye yönelik yazılımcı mülakatları sona erecek.
Artık adaylardan copilot gibi yapay zeka araçları ile sunulan bir fikir için çok hızlı ve çalışır bir protip (MVP) oluşturmaları istenecek. Birkaç saatlik bir zaman diliminde fikirden, çalışan ürüne kadar tüm yazılım yelpazesi ve adayın bu süreçte nelere hakim olduğu kontrol edilecek.
Böylece usta-çırak ilişkisi ile yetiştirilmeyen yazılımcılar için bunun önü açılmış oluyor.
Nasıl bir kalp cerrahi asistan doktor olarak yıllarca bir kalp operasyonunun pratik ve teorik eğitimini ustalarından alıyorsa, yazılımcıların da böyle bir ilişki içinde yetkinlik kazanmaları gerekir hale gelecek. Bunun olmadığı bir ortamda yetişen tüm yazılımcılar vibecoding ile mülakatta istenenleri yapabilir anca ne yaptıklarını açıklayamayacak halde olacaklar.
Artan yazılım talebi ile yazılımcılar bu işin kendi kendilerine öğrenmeye bırakılamayacak kadar kritik unsur haline geliyorlar. Yazılım bir zanaattır ve ustası tarafından öğretilmek zorunda.
Bknz: https://kurumsaljava.com/2012/05/08/programcilik-sanat-mi-zanaat-mi/
Yapay Zeka İle Çevik Olma
Yazılımda çevik olmanın tek yöntemi test yazmaktır. Yazılım projelerinin zaman içinde yeniden yapılandırılamayarak telef olmalarının tek sebebi test eksikliğidir.
Bknz: https://kurumsaljava.com/2012/04/05/cevikligin-boylesi/
Artık test yazmamak için hiçbir mazuriyet kalmamıştır. Claude Sonet 4.5 yeni bir API için 20 ye yakın entegrasyon testini 5 dakikanın altında olusurdu. O testleri yazmak günler ya da haftalar alabilir.
Test yazmamanın ana sebebi yani maliyetli olması nedeni artık ortadan kalkmıştır.
Çevik süreçlerinin oturamamasının da ana sebebi refactoring yapma kabiliyetinin geliştirilememesi idi.
Bu taktirde XP gibi çevik süreçlerin tekrar bir rönesans yaşaması söz konusu.
Statükocu Zihniyet
Yazılımcı olarak bazı gerçeklerle yüzleşmemiz gerekiyor.
Copilotu sadece bir sefer Claude Sonet 4.5 ya da türevleri ile deneyimleyen bir yazılımcı, anti yapay zeka savlarının birçoğunun gerçek dışı olduğunu görecektir. Nedir bu anti yapay zeka savları?
- Vibecoding iyi netice vermez,
- Senior programcı vazgeçilmezdir,
- Yapay zeka yazılımcı mesleğini ortadan kaldıramaz,
- ve türevleri…
Yapay zekanın tecrübeli bir yazılımcıyı ortadan kaldırma ihtimalinin olmadığını düşünenlerdenim. Aynı şekilde vibecoding hızlı MVP tarzı prototipleme için kullanılabilecek bir yöntemdir. Ancak yazılıma yeni başlayanlar için vibecoding bir zehirdir. Adapte olabilen senior vazgeçilmez olacaktır.
Bunlara değindikten sonra, asıl anlatmak istediğim mevcuza gelmek istiyorum.
Statükocu zihniyet…
Bence çok hızlı bir şekilde bu statükoyu korumacı zihniyetten vazgeçmek gerekiyor. Kendimize asıl sormamız gereken soru şu:
Biz yazılımcılar için çalışma tarzı nasıl değişecek ve biz buna nasıl adapte olabiliriz?
Bugün modern bir araba fabrikasında insanlar sadece gözlemci durumda. Tamamen karanlıkta faaliyet gösteren fabrikalar var. Bir senior seviyesinde gelmiş programcının teknik olarak yapay zeka ile rekabet etmesi imkansız. Senior pogramcılar ilerde yapay zeka işini yaparken gözlemci ve kontrolcü konumunda kalabilir.
Benim yanımda örneğin benim kadar, belki de daha yetkin birisi oturuyor artık: LLM. Ben ona hergün iş yaptırıyorum ve zamandan tasarruf ediyorum. İşi bilen birisinin ona ne yapması gerektiğini anlatması işin küçük bir bölümü artık. Kısa bir zaman sonra yazılımcılar olarak çok farklı bir ortamda çalışıyor olacağız. Buna ne kadar hazırız?
Kod yazmak işin çok küçük bir kısmı. Biz yazılımcılar bu dar alanda yapay zeka ile rekabet etmek zorunda değiliz. Bırakalım angaryayı onlar yapsın. Bizi ayrıcalıklı kılacak olan hardskilller değil, softskillerdir. Onlara odaklanarak her an artan yazılım talebini rahatlıkla karşılayabiliriz.
Yapmamız gereken tek şey değişimi kabul edip, onunla yaşama yetisi geliştirmektir.
Özcan Acar
EOF (End Of Fun)