Kategori arşivi: İleri Java

Java 9 ile Modül Bazlı Yazılım

Bir yazılım sisteminde karmaşaya, bağımlılıklara ve kodun bakım ve geliştirilmesi sürecine hakim olabilmenin bir yolu da komponent ya da modül bazlı yazılım yapmaktan geçmektedir. İdeal şartlarda bir modül tek bir görevi yerine getirir ve tek sorumluluk prensibi göz önünde bulundurularak implemente edilmiştir. Modül iç dünyasını gizli tutar ve kullanımını modül API (application programming interface) olarak isimlendirilen tanımlı giriş, çıkış kanalları ya da başka bir deyişle kullanım arayüzü aracılığı ile sağlar. Kullanım arayüzleri modülün hangi işlemleri gerçekleştirdiğini soyut olarak tanımlarken, bu işlemlerin nasıl gerçekleştirildikleri modül içinde yer alan implementasyonlarda yer almaktadırlar. Kısaca bir modül kullanıcısı için bir kara kutudur. Bu şekilde kullanıcısını etkilemeden, iç implementasyonu değiştirmek mümkündür, çünkü kullanıcı iç implementasyona değil, kullanıcı arayüzüne bağımlıdır. Kullanıcı arayüzleri sahip oldukları yapıyı koruyabildikleri sürece, modül üzerinde yapılan değişiklikler kullanıcıyı etkilemez. Bu şekilde tanımlı kullanıcı arayüzleri aracılığıyla esnek olarak birbirine bağlı olan uygulama parçaları geliştirmek ve bu parçalar üzerinde uygulamanın genelini etkilemeden gerekli değişiklikleri yapmak mümkündür.

Java 9 öncesinde modül bazlı yazılımın nasıl yapıldığını ya da benim bu konuda nasıl çalıştığımı ve karşılaştığım sorunları bir örnek üzerinde göstermek istiyorum. Vereceğim örnekte loglama işlemini gerçekleşiren bir modül yer almaktadır. Bu modülün kullanım arayüzü (API) Logger.java isimli sınıfta tanımlıdır.

[source language=”java”]

package com.kurumsaljava.logger;

public interface Logger {

void log(LogLevel level, String log);

}
[/source]

Logger bir interface sınıftır ve modülün yaptığı işlemi tek bir soyut metot olarak ihtiva etmektedir. Bu yapı bize genel olarak modülün hangi tür bir işlemden sorumlu olduğunu tanımlama imkanı sağlamaktadır. Bunu yaparken herhangi bir implementasyon detayı kullanma zorunluluğumuz bulunmamaktadır. Bu şekilde tamamen soyut bir tanımlama yapmış olmaktayız. Oluşturduğunuz API ne sorusuna cevap verirken, nasıl sorunun cevabını iç implementasyona bırakmaktadır.

Loglama işleminin nasıl gercekleştirildiği bir implementasyon detayıdır ve modül dışında yer alanları ilgilendirmez/ilgilendirmemeldir. Modülün ana görevlerinden birisi, bu implementasyon detayını gizlemek olmalıdır. Bu ona implementasyon üzerinde istediği şekilde değişiklik yapma imkanını sunarken, modül kullanıcılarının bu değişikliklerden doğrudan etkilenmelerinin önüne geçen bir unsur olacaktır.

Modülün sorumlu olduğu işlemi su şekilde implemente edebiliriz:

[source language=”java”]
package com.kurumsaljava.logger;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.Logger;

class StdoutLoggerImpl implements Logger {

@Override
public void log(LogLevel level, String log) {
System.out.println(level.name() + " – " + log);
}
}
[/source]

Burada dikkatinizi sınıfın tanımlandığı satıra çekmek istiyorum. Sınıfı public olarak tanımlamadım, çünkü modül dışındaki dünyanın bu sınıfa erişimini engellemek istiyorum. Modülün kara bir kutu olabilmesi için bu gerekli bir adım. Bana kalmış olsa bu sınıfı private olarak tanımlardım. Ama bu ne yazık ki mümkün değil, çünkü bir interface sınıfın tüm metotları ya public ya da package private olmak zorundadır yani implementasyon sınıfı private kullanarak metotların görünürlüğünü daha da daraltamaz. Bu yüzden yukarıda yer alan implementasyon sınıfını en az package private olarak tanımlayabilmekteyim. Bu StdoutLoggerImpl sınıfının sadece aynı paket içinde yer alan sınıflar tarafından erişilebilir olduğu anlamına gelmektedir. Ama reflection kullanarak, bu sorunu aşabiliriz yani sadece paket içinde kullanılabilir olan bir sınıfın reflection aracılığı ile başka bir paket içinde yer alan bir sınıf tarafından kullanılabilir olmasını sağlayabiliriz.

[source language=”java”]
package com.kurumsaljava.application;

import java.lang.reflect.Constructor;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.Logger;

public class Main {

public static void main(String[] args) throws Exception {

Class<Logger> c = (Class<Logger>)Class.forName("com.kurumsaljava.logger.StdoutLoggerImpl");

Constructor<?> constructor = c.getDeclaredConstructor();
constructor.setAccessible(true);
Logger logger = (Logger)constructor.newInstance();
logger.log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Görüldüğü gibi başka bir paket içinde yer alan Main sınıfı aslında modülün iç dünyasının bir parçası olan ve dış dünyanın görmemesi gereken bir implementasyon sınıfını kullanabilmektedir. Buna ne derleyici ne de yorumlayıcı engel olabilmiştir. Bu durum modüler bir yapı oluşturmamıza engel olmakta ve modüllerin birer kara kutu olmaları gerektiği prensibini çiğmemektedir. Modül bir kara kutu olduğunu düşünerek hareket ettiğinde, örneğin StdoutLoggerImpl yerine başka bir sınıf oluşturulduğunda, Main sınıfı çalışmaz hale gelecektir. Oysaki bizim istediğimiz modül kullanım yapısı şu şekilde olmalıdır:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) throws Exception {

LoggerFactory.instance().log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Main sınıfı logger modülene ve sunduğu hizmete erişebilmek için LoggerFactory sınıfını kullanmaktadır. LoggerFactory şu yapıya sahiptir ve iç implementasyonu API aracılığı ile kullanılabilir hale getirmektedir:

[source language=”java”]
package com.kurumsaljava.logger;

public class LoggerFactory {

public static Logger instance() {
return new StdoutLoggerImpl();
}
}
[/source]

LoggerFactory sınıfı StdoutLoggerImpl sınıfı ile aynı paket içinde bulundugundan, LoggerFactory bu sınıfı kullabilmektedir. İç implementasyonu kullanılabilir hale getirmek için API’nin bir parçası olan böyle bir sınıfı oluşturmamız gerekmektektedir. Bu durumda modülün kullanım arayüzünü oluşturan sınıflar Logger, LogLevel ve LoggerFactory sınıflarıdır yani modül kullanıcıları modülün sunduğu hizmeti sadece bu üç sınıf aracılığı ile kullanabilirler. Ama reflection örneğinde gördüğümüz gibi iç implementasyona erişmek her zaman mümkündür yani Java dilinde gerçek modüller oluşturmak aslında mümkün değildir.

StdoutLoggerImpl sınıfı gizleme imkanımız gerçekten yok mu? Bir de şöyle denesek:

[source language=”java”]
package com.kurumsaljava.logger;

public class LoggerFactory {

public static Logger instance() {
return new StdoutLoggerImpl();
}

private static class StdoutLoggerImpl implements Logger {

@Override
public void log(LogLevel level, String log) {
System.out.println(level.name() + " – " + log);
}
}
}
[/source]

Java’da bir sınıf bünyesinde başka bir sınıf tanımlamak (inner class) ve sınıfı private olarak deklare etmek mümkün. Modülü yine şu şekilde kullanabiliriz:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) throws Exception {

LoggerFactory.instance().log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Peki reflection? Ne yazık ki bu şekilde bile reflection ile iç sınıflara erişim mümkündür:

[source language=”java”]
public static void main(String[] args) throws Exception {

Class<Logger> c = (Class<Logger>)Class.forName("com.kurumsaljava.logger.LoggerFactory$StdoutLoggerImpl");

Constructor<?> constructor = c.getDeclaredConstructor();
constructor.setAccessible(true);
Logger logger = (Logger)constructor.newInstance();
logger.log(LogLevel.DEBUG, "Hello World");
}
[/source]

Sonuç? Java 9 öncesi dilin sahip oldugu özellikleri kullanarak kara kutu gibi çalışan modüller oluşturmak mümkün değil. Biz ne kadar paket bazında sınıf erişimini engellemeye çalışsak da, classpath içinde yer alan her sınıfa erişim bir şekilde mümkündür. Bize burada ne jar dosya yapısı, ne public/private direktifleri ne de tüm sınıfların yer aldığı classpath destek vermektedir. Peki Java dilinde modül nasıl oluşturabiliriz? Bu OSGI (Open Services Gateway initiative) ile mümkün, ama Java 9 ile daha da kolay, çünkü modüller için gerekli yapılar dilin ve derleyicinin bir parçası haline geldi.

Java 9 sürümünün getirdiği yeniliklerin başında yeni modül sistemi geliyor. Şimdi logger modülünün gerçek bir modül olarak Java 9 ile nasıl implemente edilebileceğini yakından inceleyelim.

Öncelikle bir takım sınıfların bir modül teşkil ettiğini tanımlamamız gerekiyor. Bu amaçla modül tanımlayıcısı (module descriptor) olarak isimlendirilen bir sınıf oluşturmamız gerekiyor. Logger modülü için bu sınıfı şu şekilde tanımlayabiliriz:

[source language=”java”]
module logger {
}
[/source]

Modül tanımlayıcı sınıfının ismi module-info.java ismini taşımaktadır. Yukarıdaki örnekte logger isminde bir modül tanımladık. Modülün yer alacağı dizin yapısı şu şekildedir:

[source language=”java”]
src
|__logger
|__module-info.java
|__com
|_kurumsaljava
|__logger
|__Logger.java
|__LoggerFactory.java
|__LogLevel.java
|__StdoutLoggerImpl.java
[/source]

Modüle ait tüm parçalar src/logger dizininde yer almaktadır. Modülü tanımlamak için src/logger/module-info.java sınıfını oluşturduk. Modül implementasyonu /src/logger/com/kurumsaljava/logger dizininde yer almaktadır. Şimdi logger modülünü kullanan yeni bir modül oluşturulım. Application ismini taşıyan bu modül, logger modülünde yer alan loglama servisini kullanmaktadır.

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__Logger.java
| |__LoggerFactory.java
| |__LogLevel.java
| |__StdoutLoggerImpl.java
|__application
|__module-info.java
|__com
|_kurumsaljava
|__application
|__Main.java
[/source]

Uygulamamız iki modülden oluşmaktadır ve şu şekilde (windows powershell ile) derlenmektedir:

[source language=”java”]

javac -d classes –module-source-path src $(dir src -r -i "*.java")

[/source]

Birinci parametre (-d) ile derlenen sınıfların hangi dizinde yer aldığını, ikinci parametre ile (–module-source-path) derlemek istediğimiz modül kodlarının hangi dizinde yer aldığını tanımladık. Bu işlemin ardından ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> javac -d classes –module-source-path src $(dir src -r -i "*.java")
C:\Users\acar\eclipse-workspace-java9\modules\src\application\com\kurumsaljava\application\Main.java:3: error: package com.kurumsaljava.com.logger is not visible
import com.kurumsaljava.com.logger.LogLevel;
^
(package com.kurumsaljava.com.logger is declared in module logger, but module application does not read it)
C:\Users\acar\eclipse-workspace-java9\modules\src\application\com\kurumsaljava\application\Main.java:4: error: package com.kurumsaljava.com.logger is not visible
import com.kurumsaljava.com.logger.LoggerFactory;
^
(package com.kurumsaljava.com.logger is declared in module logger, but module application does not read it)
2 errors
[/source]

Hatanın ne olduğunu daha iyi anlayabilmek için tekrar Main sınıfına bir göz atalım:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) {
LoggerFactory.instance().log(LogLevel.INFO, "Hello World");
}

}
[/source]

Main sınıfı LogLevel ve LoggerFactory sınıflarını kullanmaktadır. Bunlar logger modülünün kullanım arayüzünü oluşturan sınıflardır. Lakin derleyici bu sınıflar için “not visible” yani görülmeyen sınıflar hatasını vermektedir. Derleyici bu sınıfları bulamamaktadır, çünkü logger modülü tanımlayıcısında (module-info.java) bu sınıflar kullanıma açılmamıştır yani logger modülü bu hali ile tam bir kara kutudur ve kullanımı imkansızdır. Logger modülünü kullanılabilir hale getirmek için kullanım arayüzünü oluşturan sınıfları diğer modüllerin erişebileceği şekilde tanımlamamız gerekmektedir. Bu işlemi şu şekilde gerçekleştirebiliriz:

[source language=”java”]
— logger/module-info.java

module logger {
exports com.kurumsaljava.logger;
}
[/source]

Bu tanımlama ile com.kurumsaljava.logger paketinde yer alan sınıfların hepsini diğer modüller tarafından kullanılabilir hale getirmiş olduk. Logger modülünü kullanmak isteyen her modülün şu şekilde bu isteği dile getirmesi gerekmektedir:

[source language=”java”]
— application/module-info.java

module application {
requires logger;
}
[/source]

Derleme işlemi tamamlandıktan sonra, uygulamayı oluşturan Main sınıfını şu şekilde koşturabiliriz:

[source language=”java”]

java –module-path classes -m application/com.kurumsaljava.application.Main

[/source]

Bu hali ile bir modülün sahip olması gerektiği yapıya çok yaklaşmış olduk. Modülün iç dünyasını paket bazında kullanıma sunabildigimiz için logger modülünün yapısını aşağıdaki şekilde değiştirmek faydalı olacaktır, aksi taktirde bu konfigürasyon ile application/Main sınıfı doğrudan StdoutLoggerImpl sınıfına erişebilmektedir. Bu dogal olarak modülün bir kara kutu gibi işlev görmesinin önünde bir engel oluşturmaktadır.

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__impl
| | |__StdoutLoggerImpl.java
| |__api
| |__Logger.java
| |__LoggerFactory.java
| |__LogLevel.java

— logger/module-info.java

module logger {
exports com.kurumsaljava.logger.api;
}
[/source]

Modüler uygulamamızı koştururken –module-path parametresi dikkatinizi çekmiş olabilir. Aynı şekilde modülleri derlerken –module-source-path parametresini kullanmıştık. Java’nın yeni modül sistemi classpath yerine modülü oluşturan sınıfları yüklemek için module-path dizin yapısını kullanmaktadır. Module path bir ya da daha fazla ve derlenen modülleri ihtiva eden dizinlerden oluşmaktadır. Derleme işlemi esnasında modüle ait sınıflar module-source-path ile tanımlanmatadır. Modüler bir uygulama koşturulduğunda, modülün module-path içinde bulunan ilk sürümü kullanılmakta ve diğerleri göz ardı edilmektedir. Module-path ve classpath birlikte kullanılabilmektedir.

Oluşturulan modülleri jar dosyalarında tutmak münkün. Lakin her modül için ayrı bir jar dosyası oluşturulması gerekmektedir. Modüler uygulamamiz için aşağidaki şekilde modül jar dosyaları oluşturabilir ve bu jar dosyaları aracılığı ile uygulamamızı koşturabiliriz.

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –create –file module/application.jar –main-class com.kurumsaljava.application.Main -C classes/application .
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –create –file module/logger.jar -C classes/logger .
PS C:\Users\acar\eclipse-workspace-java9\modules> java –module-path module -m application/com.kurumsaljava.application.Main
INFO – Hello World
[/source]

Oluşturdugumuz modüller arasındaki bağımlılıkları şu şekilde kontrol edebiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jdeps –module-path modules module/*.jar
application
[file:///C:/Users/acar/eclipse-workspace-java9/modules/module/application.jar]
requires mandated java.base (@9.0.4)
requires logger
application -> java.base
application -> logger
com.kurumsaljava.application -> com.kurumsaljava.logger logger
com.kurumsaljava.application -> java.lang java.base
logger
[file:///C:/Users/acar/eclipse-workspace-java9/modules/module/logger.jar]
requires mandated java.base (@9.0.4)
logger -> java.base
com.kurumsaljava.logger -> java.io java.base
com.kurumsaljava.logger -> java.lang java.base
com.kurumsaljava.logger -> java.lang.invoke java.base
PS C:\Users\acar\eclipse-workspace-java9\modules>
[/source]

Görüldügü gibi application.jar dosyasında yer alan modül logger modülü yanı sıra java.base modülüne bağımlıdır. Aynı şekilde logger modülü de java.base modülüne bağımlıdır. Burada Java bünyesinde yer alan sınıfların da artık modüler bir yapıda olduğunu görmekteyiz. Sadece ihtiyaç duyulan sınıfların yer aldığı modülleri kullanarak, Java uygulamalarını daha az hafıza ihtiyacı duyan Java ortamlarında koşturmak mümkün hale gelmiştir. Tüm java modüllerine şu sekilde erişebiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> java –list-modules
java.activation@9.0.4
java.base@9.0.4
java.compiler@9.0.4
java.corba@9.0.4
java.datatransfer@9.0.4
java.desktop@9.0.4
java.instrument@9.0.4
java.logging@9.0.4
java.management@9.0.4
java.management.rmi@9.0.4
java.naming@9.0.4
java.prefs@9.0.4
java.rmi@9.0.4
java.scripting@9.0.4
java.se@9.0.4
java.se.ee@9.0.4
java.security.jgss@9.0.4
java.security.sasl@9.0.4
java.smartcardio@9.0.4
java.sql@9.0.4
java.sql.rowset@9.0.4
java.transaction@9.0.4
java.xml@9.0.4
java.xml.bind@9.0.4
java.xml.crypto@9.0.4
java.xml.ws@9.0.4
java.xml.ws.annotation@9.0.4
jdk.accessibility@9.0.4
jdk.attach@9.0.4
jdk.charsets@9.0.4
jdk.compiler@9.0.4
jdk.crypto.cryptoki@9.0.4
jdk.crypto.ec@9.0.4
jdk.crypto.mscapi@9.0.4
jdk.dynalink@9.0.4
jdk.editpad@9.0.4
jdk.hotspot.agent@9.0.4
jdk.httpserver@9.0.4
jdk.incubator.httpclient@9.0.4
jdk.internal.ed@9.0.4
jdk.internal.jvmstat@9.0.4
jdk.internal.le@9.0.4
jdk.internal.opt@9.0.4
jdk.internal.vm.ci@9.0.4
jdk.jartool@9.0.4
jdk.javadoc@9.0.4
jdk.jcmd@9.0.4
jdk.jconsole@9.0.4
jdk.jdeps@9.0.4
jdk.jdi@9.0.4
jdk.jdwp.agent@9.0.4
jdk.jlink@9.0.4
jdk.jshell@9.0.4
jdk.jsobject@9.0.4
jdk.jstatd@9.0.4
jdk.localedata@9.0.4
jdk.management@9.0.4
jdk.management.agent@9.0.4
jdk.naming.dns@9.0.4
jdk.naming.rmi@9.0.4
jdk.net@9.0.4
jdk.pack@9.0.4
jdk.policytool@9.0.4
jdk.rmic@9.0.4
jdk.scripting.nashorn@9.0.4
jdk.scripting.nashorn.shell@9.0.4
jdk.sctp@9.0.4
jdk.security.auth@9.0.4
jdk.security.jgss@9.0.4
jdk.unsupported@9.0.4
jdk.xml.bind@9.0.4
jdk.xml.dom@9.0.4
jdk.xml.ws@9.0.4
jdk.zipfs@9.0.4
[/source]

Aşağıdaki şekilde sadece uygulamamızı ve ihtiyaç duyduğumuz Java modüllerini ihtiva eden bir Java sürümü oluşturabiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jlink –module-path "%JAVA_HOME%/jmods;module" –add-modules application –output distribution
PS C:\Users\acar\eclipse-workspace-java9\modules> .\distribution\bin\java -m application
INFO – Hello World
[/source]

Jlink ile oluşturduğumuz Java sürümü sadcee 35MB büyüklügünde olup, uygulamamızı ihtiva etmekle birlikte, onu koşturmak için gerekli tüm yeteneklere sahiptir. Bunu 300MB büyüklügünde olan JDK9 sürümü ile kıyasladığımızda, Java ile modüler yazılımın ve Java’nın sahip olduğu kendi modüler yapının Java 9 ile yapılacak yeni projelerde hafıza kullanımını ne oranda düşürebileceği görülmektedir.

Modül tanımlayıcılarının (module descriptor) içeriğine aşağidaki şekilde ulaşmak mümkündür. Bu kullanmak istediğimiz modüllerin kullanım arayüzleri hakkında fikir edinmemizi kolaylaştıracaktır.

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –describe-module –file=module/logger.jar
logger jar:file:///C:/Users/acar/eclipse-workspace-java9/modules/module/logger.jar/!module-info.class
exports com.kurumsaljava.logger
requires java.base mandated

PS C:\Users\acar\eclipse-workspace-java9\modules> jar –describe-module –file=module/application.jar
application jar:file:///C:/Users/acar/eclipse-workspace-java9/modules/module/application.jar/!module-info.class
requires java.base mandated
requires logger
contains com.kurumsaljava.application
main-class com.kurumsaljava.application.Main

PS C:\Users\acar\eclipse-workspace-java9\modules>
[/source]

Son olarak servis modüllerinden bahsetmek istiyorum. Şimdiye kadar incelemiş olduğumuz modül sisteminde bir sorun mevcut. Logger modülünün birden fazla implementasyonu düşünülebilir. Örneğin bir RemoteLoggerImpl sınıfı ile logları bir sunucuya gönderebiliriz. Bu durumda ikinci bir modül oluşturarak, Logger sınıfını yeniden implemente etmemiz gerekmektedir. Lakin bu durumda modül kullanıcısının bağımlılık sayısı artacaktır. İncelediğimiz örnekte application modülü logger modülünü kullanmaktadır. İsmi remotelogger olan yeni bir modül oluşturduğumuz taktirde, application modülü bu yeni modülü kullanmak isteğinde, modül tanımlayıcısı şöyle bir yapıya bürünecektir:

[source language=”java”]
— application/module-info.java

module application {
requires logger;
requires remotelogger;
}
[/source]

Oluşturacağımız her yeni logger implementasyonu için bu liste uzayıp, gidecektir. Modüller arasında bu şekilde bir bağımlılık oluşturmak, modüllerin bakımını ve geliştirilmesini zora somaktadır. Hizmet kullanan (consumer) ve hizmet sunan (provider) modülleri birbirlerine bağımlı olmayacak şekilde ayırt etmemiz gerekmektedir. Aksi taktirde bu bağımlılıkların yönetimi imkansiz hale gelecektir. Bunu sağlamak için servis katalog (service catalog) ya da servis kayıt merkezi (service registry) yapısını kullanabiliriz.

Servis kayıt merkezini hizmet alan ve hizmet sunan modüller arasında bir aracı katman olarak düşünebiliriz. Hizmet sunan modüller servis kayit merkesine başvurarak, sundukları hizmeti kaydettirirler. Aynı şekilde hizmet almak isteyen modüller de servis kayıt merkezine başvurarak, istedikleri servisi edinmeye çalışırlar. Burada ki en önemli nokta, hizmet sunan ve hizmet alan modüllerin birbirlerini tanımamalarıdır ve daha önce bahsetmiş olduğum bağımlılığın oluşmamasıdır. Modüller sadce servis kayıt merkezini tanırlar ve işlemleri onun aracılığı ile gerçekleştirirler.

Şimdi logger modülünü iki değişik implementasyon sunacak şekilde yeniden oluşturalım ve application modülünün bu iki modüle bagımlı olmadan, mevcut logger implementasyonları servis kayıt merkezi aracılığı ile nasıl kullanabileceğini bir örnek üzerinde inceleyelim.

Logger modülünü soyut olarak yani sadece api sınıflarını ihtiva edecek şekilde şu şekilde tanımlayabiliriz:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java

— logger/module-info.java

module logger {
exports com.kurumsaljava.logger.api;
}

— Logger.java

package com.kurumsaljava.logger.api;
public interface Logger {

public void log(LogLevel level, String log);

}
[/source]

Akabinde stdout ve remote logger implementasyonlarını yeni iki modül bünyesinde aşağıdaki şekilde implemente edebiliriz:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java
|__remotelogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__remote
| |__RemoteLoggerImpl.java
|__stdoutlogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__stdout
| |__StdoutLoggerImpl.java

— remotelogger/module-info.java

module remotelogger {
requires logger;
provides com.kurumsaljava.logger.api.Logger with com.kurumsaljava.logger.remote.RemoteLoggerImpl;
}

— stdoutlogger/module-info.java

module stdoutlogger {
requires logger;
provides com.kurumsaljava.logger.api.Logger with com.kurumsaljava.logger.stdout.StdoutLoggerImpl;
}
[/source]

Modül tanımlayıcısı bünyesinde provides direktifi ile bir modül başka bir modül tarafından tanımlanmış ve export edilmiş bir api sınıfını implemente edebilmektedir. Provides ile oluşturduğumuz implementasyonlar servis kayıt merkezinde Logger sınıfı için iki servis implementasyonu kaydı oluşturacaktır. Kısaca iki yeni modül “biz bu servisi sağlayabiliyoruz” şeklinde bir açıklamada bulunarak, gerekli servis kayıtlarının oluşturulmasını sağlamaktadırlar. Peki bu modüllere doğrudan bir bağımlılık oluşturmadan, servis implementasyonlarını nasıl kullanabiliriz? Şu şekilde:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java
|__remotelogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__remote
| |__RemoteLoggerImpl.java
|__stdoutlogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__stdout
| |__StdoutLoggerImpl.java
|__application
| |__module-info.java
| |__com
| |_kurumsaljava
| |__application
| |__Main

— application/module-info.java

module application {
requires logger;
uses com.kurumsaljava.logger.api.Logger;
}

— Main

package com.kurumsaljava.application;

import java.util.ServiceLoader;

import com.kurumsaljava.logger.api.Logger;
import com.kurumsaljava.logger.api.LogLevel;

public class Main {

public static void main(String[] args) {
Iterable<Logger> services = ServiceLoader.load(Logger.class);
for(Logger logger: services) {
logger.log(LogLevel.DEBUG, "Hello World");
}
}
}
[/source]

Application isimli modül modül tanımlayısı bünyesinde uses direktifi ile hangi modülü kullanmak istediğini ifade etmektedir. Bu Logger soyut sınıfını baz alan soyut bir tanımlamadır. Application modülü kesinlikle somut bir sınıf ya da modül implementasyonuna işaret etmemektedir. Bu şekilde modüller arasındaki bağı daha esnek hale getirmek ve modüller arası alışverişi servis kayıt merkezi aracılığıyla yürütmek mümkün hale gelmektedir.

Mevcut servis implementasyonlarına erişim yani servis kayıt merkezine başvuru ServiceLoader sınıfı aracılığı ile gerçekleşmektedir. Main örneginde Logger.class sınıfını implemente eden modüller load() metodu aracılığı ile servis kayıt merkezinden alınmakta ve bu şekilde arzu edilen servis modül bünyesindeki tanımlı kullanıcı arayüzü aracılığı ile koşturulabilmektedir. ServiceLoader örneğinde görüldüğü gibi LoggerFactory gibi bir sınıfın kullanımı gereksiz hale gelmiştir, çünkü factory (bknz. factory tasarım şablonu) görevini servis kayıt merkezi üstlenmektedir.

Java, 9 sürümü ile gerçek anlamda modüler uygulamaların oluşturulması mümkün kılan bir araç haline gelmiştir. Yeni uygulamaların bu avantajı kullanabilmeleri ümidiyle …


EOF (End Of Fun)
Özcan Acar
JVM Nasıl Çalışır Yazı Serisi – Java Just In Time Compiler (JIT) Nasıl Çalışır?

Java’yı çoğu programcı yorumlanan (interpreted) dil olarak bilir. Java’nın yavaş olduğu efsanesi de başlangıcını da burada bulur. Bytekod olarak derlenen Java sınıfları Java sanal makinesi (Java Virtual Machine – JVM) bünyesinde yorumlanır. Tek derleme işlemi Java sınıflarının bytekoda dönüştürülmesi esnasında yapılmaz. JVM bünyesinde de bytekodun makine koduna dönüştürüldüğü bir derleme gerçekleştirilir. Bu işleme Just in time (JIT) compilation ismi verilmektedir. Bu yazımda JVM bünyesinde kodun nasıl derlendiğini örnekler üzerinden aktarmak istiyorum.

Derleme (compilation) sürecini yüksek dillerde yazılan program kodlarının işlemcinin (CPU) anladığı makine koduna dönüştürüldüğü ve bu şekilde CPU üzerinde koşturulabilir hale getirildiği işlem olarak tanımlayabiliriz. Derleme işlemini gerçekleştiren programları yani derleyicileri kabaca iki guruba ayırmak mümkün. Bunlar:

  • Ahead of time compiler (AOT)
  • Just in time compiler (JIT)

C/C++ gibi diller AOT tarzı derleciyiler kullanırlar. AOT derleyicileri program kodunu programın koşturulmasından önce kullanılan donanımın anladığı makine koduna dönüştürürler. JIT ise Java gibi dillerde uygulamanın çalışması esnasında (runtime) kazanılan performans verileri doğrultusunda uygulanan derleme tekniğidir. JIT devreye girmeden önce kod bytekod olarak yorumlanır. AOT ile derlenen uygulamalar JIT ile derlenen uygulamalara kıyasla daha hızlı çalışırlar, çünkü kod tamamıyla işlemcinin anladığı şekilde derlenmiştır ve yorumlanmadan doğrudan işlemci bünyesinde koşturulur. Buna karşın AOT ile derlenen uygulamalar derlendikleri platformlara bağımlıdırlar ve başka donanım türlerinde koşturulamazlar. Bunun için yeniden derleme işleminin gerçekleştirilmesi gerekmektedir. JIT derleyicileri platformdan bağımsız çalışırlar.

Java kodları javac ile derlenir. Bu derleme işlemi sonucunda bytekod oluşur. Aşağıdaki örnekte HelloWorld sınıfının nasıl derlendiğini ve derlenen sınıfın hangi bytekodu ihtiva ettiğini görmekteyiz.

[source language=”java”]

C:\>java HelloWorld

public class HelloWorld {

public static void main(String[] args){
System.out.println("Merhaba Dünya!");
}
}
[/source]

[source language=”java”]
C:\>javap -c HelloWorld.class

Compiled from "HelloWorld.java"
public class HelloWorld {
public HelloWorld();
Code:
0: aload_0
1: invokespecial #1 // Method java/lang/Object."<init>":()V
4: retur

public static void main(java.lang.String[]);
Code:
0: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;
3: ldc #3 // String Merhaba D?nya!
5: invokevirtual #4 // Method java/io/PrintStream.println:(Ljava/lang/String;)V
8: return
}
[/source]

Bir Java uygulaması JVM bünyesinde çalışır hale getirildiğinde, yukarıda yer alan bytekod JVM tarafından yorumlanmaya başlar. JVM bu durumda “interpreted” modundadır ve bytekodunu satır, satır yorumlar. Bu haliyle JVM bir durum makinesidir (state machine).

JVM bytekodu yorumlarken kodun sık kullanılan alanları hakkında istatistiki bilgiler toplar. Bu şekilde örneğin hangi metodun hangi sıklıkla koşturulduğunu ölçmek mümkündür. JVM parametreleri aracılığı ile JIT in derleme işlemine geçtiği barajlar tanımlanabilir. Örneğin bir metot on bin kez koşturulduktan sonra, bu metodun JIT tarafından derlenmesi ve bytekoddan makine koduna dönüştürülmesi sağlanabilir. Bu değeri örneğin bin olarak değiştirmek de mümkündür.

JIT ile derleme işlemi gerçekleştikten sonra JVM “compiled” moduna geçer. Bu modda JVM işlemciye (CPU) has işlemleri (native direct operations) gerçekleştirir. Kod artık yorumlanmadığı için daha hızlı çalışmaktadır. JVM bir state machine olmaktan çıkmış ve artık doğrudan işlemci üzerinde işlem yaptığından bir native register machine haline gelmiştir.

JVM in yorumlama, derleme ve uygulamayı koşturma esnasında içinde bulunduğu durumları aşağıdaki diyagramda görmekteyiz.

[source language=”java”]

(1) Interpreted –> (2)Profiling
^ |
| |
| v
(4) Deoptimize <– (3)JIT Compiled

[/source]

JVM başlangıçta interpreted (1) yani bytekodu yorumlayıcı durumundadır. Kod yorumlanırken JVM tarafından profiling (2) tekniği ile ölçümler gerçekleştirlir. Bu veriler baz alınarak kodun hangi bölümlerinin JIT ile derleneceği kararı alınır ve kod derlenir. JIT derleme (3) işlemi esnasında tüm bilgilere sahip olamayacağından bazı varsayımlarda bulunur ve spekülasyona dayalı kararlar neticesinde derleme işlemini gerçekleştirir. Bazı şartlar altından bu varsayımlar geçerliliklerini kaybettiklerinden, derlenen kod işe yaramaz hale gelir ve bir kenara bırakılarak (4), yeniden yorumlama (1) moduna geçilir. Bu döngü uygulamanın hayatı boyunca devam eder. Belli bir kullanım süresinden sonra kod hakkında toplanan bilgiler yeterli olduğundan, kodun çok kullanılan alanları derlenmiş olur ve bu da Java uygulamalarını C/C++ uygulamaları gibi hızlı kılar. JIT derleyicisi bir AOT derleyicisine nazaran daha fazla runtime istatistik bilgisine sahip olduğundan, kodun işlemci için optimize edilme işlemi daha verimli sonuçlar verir. Bu yüzden Java uygulamalarının C/C++ uygulamalarına nazaran yer yer daha hızlı çalıştığı söylenebilir. Diğer bir yazımda JIT tarafından uygulanan kod optimizasyon tekniklerine değineceğim.

Aşağıda yer alan Calculator sınıfı aracılığı ile JIT tarafından derleme işleminin nasıl yapıldığını inceleyebiliriz.

[source language=”java”]
package com.kurumsaljava.jvm.jit;

public class Calculator {

public static void main(String[] args) {
int max = Integer.parseInt(args[0]);
System.out.println(addAll(max));
}

private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result = add(result, i);
}
return result;
}

private static int add(int result, int i) {
return result + i;
}
}
[/source]

JIT tarafından yapılan derleme işlemini takip edebilmek için -XX:+PrintCompilation parametresini aşağıdaki şekilde kullanmamız gerekiyor. Bunun yanı sıra -server parametresinin kullanılması, JIT derleyicisinin daha agresif bir şekilde derleme işlemine girişmesini mümkün kılacaktır.

[source language=”java”]
c:\>java -server -XX:+PrintCompilation com.kurumsaljava.
jvm.jit.Calculator 100000
[/source]

Calculator sınıfı 1 – 100000 arasındaki rakamları toplamakta ve neticeyi ekranda görüntülemektedir. Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
1 80 1 3 java.lang.Object::<init> (1 bytes)
2 82 2 3 java.lang.String::hashCode (55 bytes)
3 83 3 3 java.lang.String::charAt (29 bytes)
4 86 4 3 java.lang.Character::toLowerCase (9 bytes)
5 86 5 3 java.lang.CharacterData::of (120 bytes)
6 86 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
7 86 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
8 86 8 3 java.lang.String::indexOf (70 bytes)
9 87 9 3 java.util.Arrays::copyOfRange (63 bytes)
10 87 10 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
11 88 11 n 0 java.lang.System::arraycopy (native) (static)
12 88 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
13 88 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
14 88 14 s 3 java.lang.StringBuffer::append (13 bytes)
15 89 15 3 java.lang.String::length (6 bytes)
16 89 16 1 java.lang.Object::<init> (1 bytes)
17 89 1 3 java.lang.Object::<init> (1 bytes) made not entrant
18 89 17 3 java.lang.String::getChars (62 bytes)
19 91 18 3 java.lang.Math::min (11 bytes)
20 97 19 3 sun.misc.FDBigInteger::mult (64 bytes)
21 97 20 3 sun.misc.FDBigInteger::<init> (30 bytes)
22 98 21 3 sun.misc.FDBigInteger::trimLeadingZeros (57 bytes)
23 98 22 3 sun.misc.FDBigInteger::mult (44 bytes)
24 100 23 n 0 java.lang.System::nanoTime (native) (static)
25 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
26 100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
27 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
28 105 26 3 java.lang.AbstractStringBuilder::append (50 bytes)
29 110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
30 111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
31 113 29 3 sun.nio.cs.SingleByte$Encoder::encode (32 bytes)

704982704
[/source]

Birinci kolonda satır numaralarını, ikinci kolonda JVM in işlem için kullandığı zamanı (millisecond), üçüncü kolonda derleme sırasını, dördüncü kolonda derleyici seviyesini, beşinci kolonda derlenen metodu görmekteyiz. Bizim için ilginç olan derleme işlemleri aşağıda yer almaktadır:

[source language=”java”]
25 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
26 100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
27 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
29 110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
30 111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
[/source]

25. ve 27. satırlarda add() metodunun derlendiğini ve derleme neticesinin 4 byte büyüklükte olduğunu görmekteyiz. 27. satırda “made not entrant” ibaresi yer almakta. Bu JIT in kullandığı varsayımların geçerliliğini yitirdiği ve derlenen kodun devre dışı kaldığı anlamına gelmektedir. 27. satırda JVM deoptimizasyon moduna geçerek, metodun yeni bilgiler doğrultusunda yeniden derlenmesinin önünü açmaktadır.

Derleme sırasının düzenli olmadığını görmekteyiz. Bu JIT derleyicisinin arka planda thread bazlı çalıştığının göstergesidir.

26. satırda add() metodu tekrar derlenmekte ve işlemci üzerinde makine kodu olarak koşturulabilir hale getirilmektedir. Ayrıca 29. ve 30. satırlarda addAll() metodunun da derlendiğini görmekteyiz. 29. satırda yer alan % isaretinin ne anlama geldiğine birazdan değineceğim.

Daha önce de bahsettiğim gibi JIT derleme işlemi esnasında kodu mümkün mertebe daha hızlı çalışabilsin diye optimize etme gayretindedir. Derleyiciler tarafından yapılan bu optimizasyonların başında method inlining gelir. Bu derleme esnasında bir metot gövdesinin kullanıldığı metota kod olarak eklenmesi anlamına gelmektedir. Örneğin aşağıda yer alan addAll() ve add() metotları JIT tarafından şu şekilde optimize edeilecektir:

[source language=”java”]
private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result = add(result, i);
}
return result;
}

private static int add(int result, int i) {
return result + i;
}
[/source]

JIT tarafından optimize edilen kod şu yapıpdadır:

[source language=”java”]
private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result += i;
}
return result;
}
[/source]

Görüldügü gibi JIT add() bünyesindeki kodu birebir addAll() metoduna taşıdı. Bu şekilde add() metoduna geçmek için gerekli frame (bknz. JVM Stack Nedir ve Nasıl Çalışır? başlıklı yazım) oluşturma işlemi gereksiz hale geldiğinden, JVM kodu daha hızlı koşturulabilmektedir.

Method inlining işleminin gerçekleştiğini ispatlamak amacıyla Calculator sınıfını aşağidaki şekilde değiştirerek, tekrar koşturuyorum:

[source language=”java”]
public class Calculator {

public static void main(String[] args) {
int max = Integer.parseInt(args[0]);
System.out.println(addAll(max));
}

private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
long start = System.nanoTime();
result = add(result, i);
long duration = System.nanoTime() – start;
if (i % 10000 == 0)
System.out.println("add execution took " +
((duration) / 1000.0d) + " µs");
}

return result;
}

private static int add(int result, int i) {
return result + i;
}
}
[/source]

Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
80 1 3 java.lang.Object::<init> (1 bytes)
82 2 3 java.lang.String::hashCode (55 bytes)
83 3 3 java.lang.String::charAt (29 bytes)
86 4 3 java.lang.Character::toLowerCase (9 bytes)
86 5 3 java.lang.CharacterData::of (120 bytes)
86 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
86 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
86 8 3 java.lang.String::indexOf (70 bytes)
87 9 3 java.util.Arrays::copyOfRange (63 bytes)
87 10 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
88 11 n 0 java.lang.System::arraycopy (native) (static)
88 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
88 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
88 14 s 3 java.lang.StringBuffer::append (13 bytes)
89 15 3 java.lang.String::length (6 bytes)
89 16 1 java.lang.Object::<init> (1 bytes)
89 1 3 java.lang.Object::<init> (1 bytes) made not entrant
89 17 3 java.lang.String::getChars (62 bytes)
91 18 3 java.lang.Math::min (11 bytes)
97 19 3 sun.misc.FDBigInteger::mult (64 bytes)
97 20 3 sun.misc.FDBigInteger::<init> (30 bytes)
98 21 3 sun.misc.FDBigInteger::trimLeadingZeros (57 bytes)
98 22 3 sun.misc.FDBigInteger::mult (44 bytes)
add execution took 1.579 µs
100 23 n 0 java.lang.System::nanoTime (native) (static)
100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
add execution took 0.0 µs
add execution took 0.395 µs
105 26 3 java.lang.AbstractStringBuilder::append (50 bytes)
add execution took 0.0 µs
110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
add execution took 0.0 µs
113 29 3 sun.nio.cs.SingleByte$Encoder::encode (32 bytes)
add execution took 0.0 µs
704982704
[/source]

İlk on bin adet add() koşturulması neticesinde toplam koşturma süresi 1.579 µs dır. Akabinde kodun iki sefer derlendiğini ve koşma süresinin 0.0 µs şeklinde değiştiğini görmekteyiz. Bu değer add() metodu inline edildiği zaman oluşabilecek bir değerdir. Add() metodu JIT tarafından “made not entrant” yapıldıktan yani derlenen kod çöpe atıldıktan sonra bir sonraki on bin adet koşturulması 0.395 µs süresinde gerçekleşmektedir. Bu add() metodunun deoptimizasyon sonucunda tekrar yorumlanmaya başlandığının ispatıdır. Add() daha sonra tekrar derlenerek, koşturma zamanı sıfıra düşmektedir, çünkü JIT tarafından tekrar addAll() bünyesinde inline edilmiştir.

Bu arada addAll() metodunun ilk derlendiği yerde % işareti görmekteyiz. Bu JIT in derleme işlemini “On stack replacement” modunda yaptığı anlamına gelmektedir. On stack replacement ne anlama gelmektedir? JIT genelde çok kullanılan metotları birebir derleme eğilimindedir. Derleme işleminden sonra derlenen metodu kullanan diğer metotlar yeni makine koduna işaret edecek şekilde yeniden yapılandırılır. Bunu bir hashtable bünyesinde yapılan bir eşleme olarak düşünebiliriz. Tüm kullanıcı metotlar derlenen metoda işaret ederler. JIT in metodu derleyebilmesi için metodun stack frame ini açmamış yani koşuyor durumda olmaması gerekmektedir. Bu add() metodu bünyesinde mevcut olan bir durumdur. Bu metot yüz bin kez koşturulmaktadır ve JIT bu metodu derlemek için gerekli fırsatları değerlendirmektedir. Lakin addAll() metoduna baktığımızda, bu metodun sadece bir kez koşturulduğunu görmekteyiz. Buna rağmen addAll() metodu JIT için bir sicak alandır (hotspot) ve derlenmelidir, çünkü uygulama için gerekli zamanın çok büyük bir kısmı bu metot bünyesinde geçmektedir.

JIT sadece bir kez koşturulan ama derlenmeyi hak eden metotları on stack replacemant yöntemi ile derlemektedir. Bu yöntemde tüm metot derlenmemektedir. JIT sadece for döngüsünün başlangıcından, sonuna kadar olan bölümü derler ve for döngüsünü koşturan yorumlayıcının (interpreter) sahip olduğu stack frame i derlenen koda giriş noktası olarak kullanır. Bu şekilde uzun döngülerin de derlenmesi mümkün hale gelmektedir.

JIT tarafından yapılan method inlining işlemini -XX:+PrintInlining parametresi ile takip etmek mümkündür. Şimdi uygulamayı bu yeni parametre ile çalıştırarak, hangi metotların inlining yöntemi ile yok edildiğini inceleylim. Bu parametreyi kullanabilmek için -XX:+UnlockDiagnosticVMOptions parametresi ile gerekli JVM kanallarının açılması gerekmektedir. Bu sebeple Calculator sınıfını aşağıdaki şekilde koşturmamız gerekmektedir:

[source language=”java”]
c:\>java -server -XX:+PrintCompilation -XX:+UnlockDiagnosticVMOptions
-XX:+PrintInlining com.kurumsaljava.jvm.jit.Calculator 100000
[/source]

Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
65 1 3 java.lang.Object::<init> (1 bytes)
68 2 3 java.lang.String::hashCode (55 bytes)
68 3 3 java.lang.String::charAt (29 bytes)
@ 18 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
71 4 3 java.lang.Character::toLowerCase (9 bytes)
@ 1 java.lang.CharacterData::of (120 bytes) callee is too large
@ 5 java.lang.CharacterData::toLowerCase (0 bytes) no static binding
71 5 3 java.lang.CharacterData::of (120 bytes)
71 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
@ 4 java.lang.CharacterDataLatin1::getProperties (11 bytes)
71 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
72 9 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
72 8 3 java.util.Arrays::copyOfRange (63 bytes)
@ 16 java.lang.StringBuilder::<init> (7 bytes)
@ 3 java.lang.AbstractStringBuilder::<init> (12 bytes)
@ 1 java.lang.Object::<init> (1 bytes)
@ 20 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (62 bytes) callee is too large
@ 25 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (50 bytes) callee is too large
@ 29 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (62 bytes) callee is too large
@ 32 java.lang.StringBuilder::toString (17 bytes)
@ 13 java.lang.String::<init> (62 bytes) callee is too large
@ 35 java.lang.IllegalArgumentException::<init> (6 bytes) don’t inline Throwable constructors
@ 54 java.lang.Math::min (11 bytes)
@ 57 java.lang.System::arraycopy (0 bytes) intrinsic
73 11 n 0 java.lang.System::arraycopy (native) (static)
73 10 3 java.lang.String::indexOf (70 bytes)
@ 66 java.lang.String::indexOfSupplementary (71 bytes) callee is too large
73 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
@ 7 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
73 16 1 java.lang.Object::<init> (1 bytes)
73 1 3 java.lang.Object::<init> (1 bytes) made not entrant
73 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
73 14 s 3 java.lang.StringBuffer::append (13 bytes)
@ 7 java.lang.AbstractStringBuilder::append (29 bytes)
@ 7 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
74 15 3 java.lang.String::length (6 bytes)
74 17 3 java.lang.String::getChars (62 bytes)
@ 9 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 27 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 43 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 58 java.lang.System::arraycopy (0 bytes) intrinsic
76 18 3 java.lang.Math::min (11 bytes)
78 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
79 20 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
79 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
80 21 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
81 22 3 com.kurumsaljava.jvm.jol.Calculator::addAll (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
704982704
[/source]

Bizim için ilginç olan bölümleri şu şekilde özetleyebiliriz:

[source language=”java”]

1) 78 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
2) 79 20 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
3) 79 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
4) 80 21 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (23 bytes)
5) @ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
6) 81 22 3 com.kurumsaljava.jvm.jol.Calculator::addAll (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
[/source]

5. satırda add() metodunun addAdll() metoduna taşındığını görmekteyiz. 3. satırda add() metodu depotimizasyon sonucu devre dışı kaldığından, 6. satırda add() metodu tekrar derlendikten sonra addAll() metoduna inline edilmektedir.

JIT tarafından yapılan işlemlerin XML olarak bir dosyaya eklenmesini istiyorsak, JVM i aşağıdaki şekilde çalıştırabiliriz:

[source language=”java”]
c:\>java -server -XX:+UnlockDiagnosticVMOptions -XX:+LogCompilation
com.kurumsaljava.jvm.jit.Calculator 100000
[/source]

Oluşan log dosyasını JitWatch uygulaması ile analiz etmek mümkün.

JVM nasıl çalışır yazı serisinin bir sonraki yazısında buluşmak üzere.


EOF (End Of Fun)
Özcan Acar
JVM Nasıl Çalışır Yazı Serisi – JVM Stack Nedir ve Nasıl Çalışır?

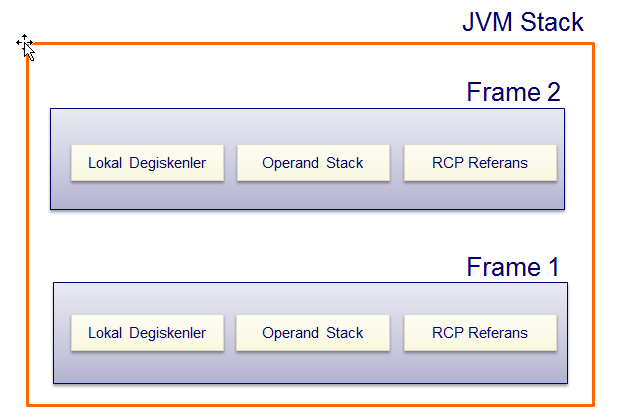
Java sanal makine bünyesinde (JVM – Java Virtual Machine) vücut bulan her thread ile birlikte thread e özel ve stack ismini taşıyan bir hafıza alanı oluşturulur. Stack bünyesinde thread in içinde bulunduğu (koşturduğu) metotlardaki lokal değişkenler, yapılan işlemler için gerekli parametreler (operand), işlem sonuçları ve metot giriş (invocation) ve çıkış (return) bilgileri yer alır.

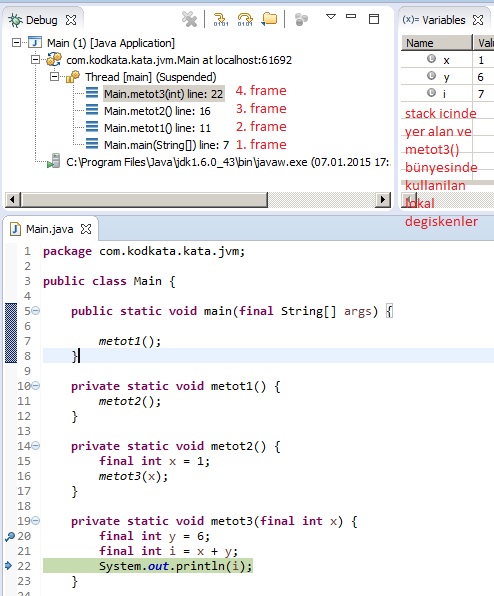
Bu bilgiler frame ismini taşıyan yapılar içinde tutulurlar. Her metot girişinde yeni bir frame oluşturulur. Aşağıda yer alan resimde program akışı main()->metot1()->metot2()-metot3() şeklindedir. Program metot3() bünyesinde bir breakpoint yardımı ile durdurulduğunda, main thread için dört adet frame in oluşturulduğu görülmektedir.

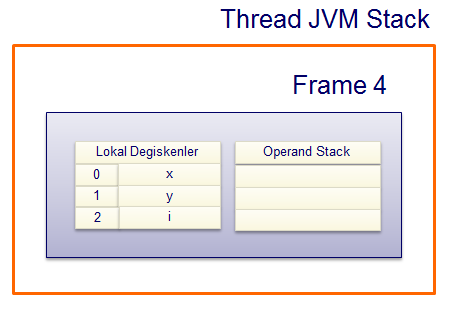
Aşağıdaki resimde stack yapısını görselleştirmeye çalıştım.

Güncel (current) thread in girdiği her yeni metot ile yeni bir frame oluşturulur demiştim. Her frame bünyesinde metot değişkenlerinin yer aldığı bir array, işlem parametrelerini (operand) ve sonuçlarını bünyesinde tutan bir LIFO (last in, first out) stack ve sınıfın runtime constant pool (sınıf bünyesinde kullanılan değişken isimleri, metot ve diğer sınıf referanslarının yer aldığı bir veri yapısı) yapısına bir referans yer alır.

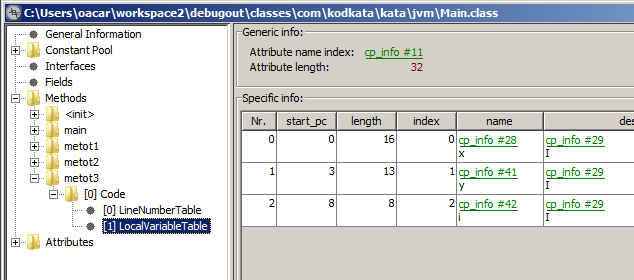
JBE (Java Bytecode Editor) ile oluşturduğumuz Java sınıfını decompile ettiğimizde, lokal değişkenlerin derlenen sınıf bünyesinde bir array içinde tutuldukları ve index numarası üzerinden stack işlemlerinde bu lokal değişkenlere erişilebileceğini görmekteyiz.

Şimdi bir metot bünyesinde stack işlemlerinin nasıl işlediğini bir örnek üzerinde birlikte inceleyelim. Stack işlemlerini incelediğimiz sınıf aşağıda yer almaktadır:

[sourcecode language=’java’]
public class Main {

public static void main(final String[] args) {

metot1();
}

private static void metot1() {
metot2();
}

private static void metot2() {
final int x = 1;
metot3(x);
}

private static void metot3(final int x) {
final int y = 6;
final int i = x + y;
System.out.println(i);
}

}
[/sourcecode]

Bu sınıfı decompile ettiğimizde, aşağıdaki bytecode yapısını elde edebiliriz:

[sourcecode language=’java’]
* ******************************************** */
/* Generated by Dr. Garbage Bytecode Visualizer */
/* http://www.drgarbage.com */
/* Version: 4.4.1.201408050542 */
/* Class retrieved from: Filesystem */
/* Retrieved on: 2015-01-08 12:30:25.220 */
/* ******************************************** */

/* class file format version 50.0 (java 1.6) */
package com.kodkata.kata.jvm;

public class Main {

/* compiled from Main.java */

public Main() {
/* L3 */
0 aload_0; /* this */
1 invokespecial 8; /* java.lang.Object() */
4 return;
}

public static void main(java.lang.String[] args) {
/* L7 */
0 invokestatic 16; /* void com.kodkata.kata.jvm.Main.metot1() */
/* L8 */
3 return;
}

private static void metot1() {
/* L11 */
0 invokestatic 21; /* void com.kodkata.kata.jvm.Main.metot2() */
/* L12 */
3 return;
}

private static void metot2() {
/* L15 */
0 iconst_1;
1 istore_0; /* x */
/* L16 */
2 iconst_1;
3 invokestatic 24; /* void com.kodkata.kata.jvm.Main.metot3(int arg0) */
/* L17 */
6 return;
}

private static void metot3(int x) {
/* L20 */
0 bipush 6;
2 istore_1; /* y */
/* L21 */
3 iload_0; /* x */
4 bipush 6;
6 iadd;
7 istore_2; /* i */
/* L22 */
8 getstatic 30; /* java.lang.System.out */
11 iload_2; /* i */
12 invokevirtual 36; /* void println(int i) */
/* L23 */
15 return;
}
}
[/sourcecode]

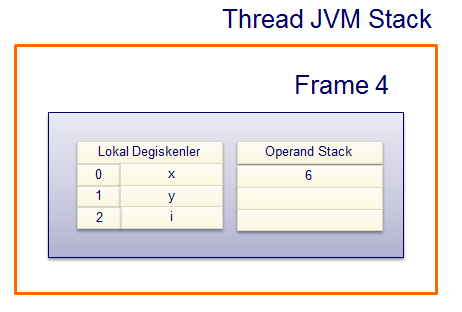
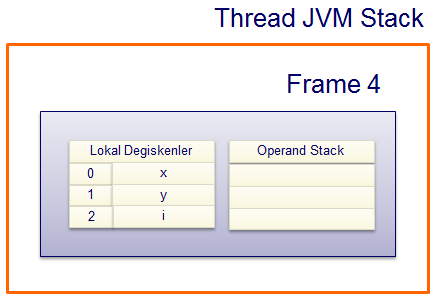
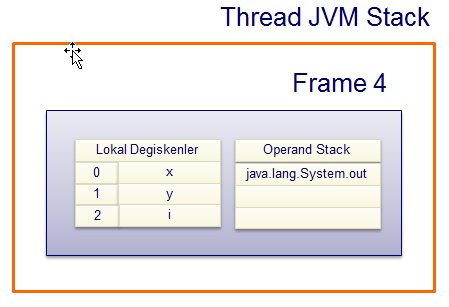
metot3() bünyesinde yer alan sıfırıncı satırda bipush 6 komutu yer almaktadır. Bu komut operand stack e 6 değerini ekler (push). Frame içinde yer alan operand stack ve lokal değişkenlerin yapısı bu işlemden sonra aşağıdaki şekildedir:

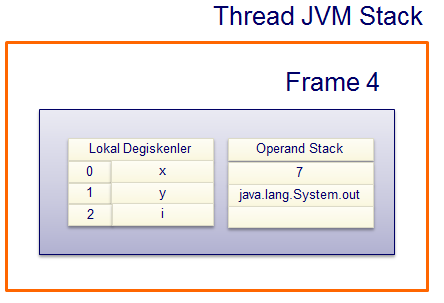
İkinci satırda istore_1 komutu yer almaktadır. Bu komut lokal değişken tablosunda 1 numaralı index değerine sahip y değişkenine operand stack bünyesinde yer alan 6 rakamını pop işlemini gerçekleştirerek, atar. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

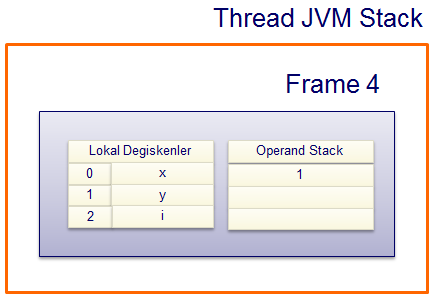
Üçüncü satırda yer alan iload_0 komutu ile 0 index numarasına sahip değişkenin, bu x isimli metot parametresidir, değeri push işlemi ile operand stack e eklenir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

Operand stack bünyesinde 1 degeri yer almaktadir, çünkü bu deger metot2() bünyesinde olusturulup, metot3() metoduna parametre olarak verilmiştir.

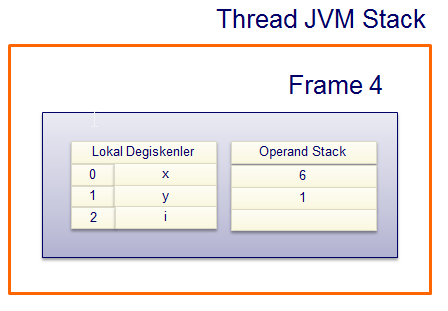
Dördüncü satırda bipush 6 komutu ile y isimli değişkenin değeri push işlemi ile operand stack e eklenmektedir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

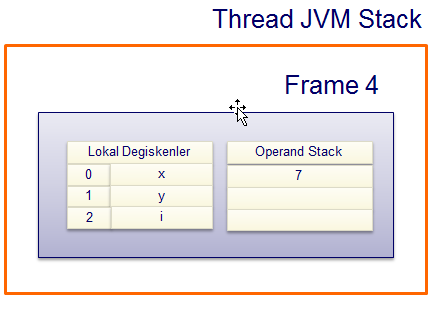
Altıncı satırda yer alan iadd komutu operand stack bünyesinde yer alan iki değeri pop komutu ile alarak, toplama işlemini gerçekleştirdikten sonra işlem sonucunu push komutu ile tekrar operand stack e eklemektedir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

Yedinci satırda yer alan istore_2 ile operand stack in en tepesinde yer alan değer 2 index numarasına sahip değişkene, yani i değişkenine atanmaktadır. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

Sekizinci satırda yer alan getstatic ile runtime constant pool bünyesinde yer alan 30 numaralı değişmezin (constant) değeri operand stack e eklenmektedir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

On birinci satırda yer alan iload_2 komutu ile i isimli değişkenin sahip olduğu değer operand stack e eklenmektedir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

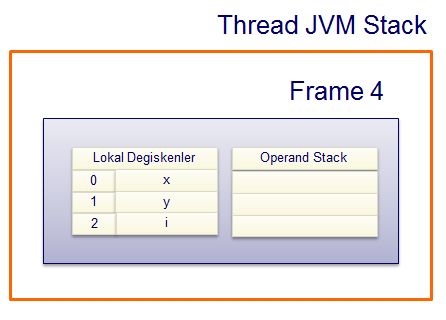
On ikinci satırda yer alan invokevirtual runtime constant pool icinde yer alan 36 numaralı değişmeze işaret etmektir. Bu java.io.PrintStream sınıfında yer alan println metodudur. invokevirtual komutu ard, arda iki sefer pop işlemini gerçekleştirerek, operand stack üzerinde yer alan değerleri alır ve System.out.println(7) ile istenilen işlemi gerçekleştirir. Bu işlemin ardından frame aşağıdaki yapıya sahiptir.

Görüldüğü gibi JVM bir stack makinesidir, çünkü bytecode komutları ihtiyaç duydukları değerleri operand stack aracılığı ile elde etmektedirler. Bu komutların sade bir yapıda olmalarını mümkün kılmaktadır.

On beşinci satırda return komutunu görmekteyiz. Bu komut ile metot son bulmakta ve oluşturulan frame yok edilmektedir. Eğer metot herhangi bir değer geri veriyorsa, bu değer yine metodu koşturan diğer metodun operand stack ine eklenmektedir. Bu şekilde koşturucu metot koşturduğu metot bünyesinde oluşan değere kendi operand stack i aracılığı ile erişebilmektedir.

Her thread için oluşturulan stack belli bir hafıza alanını işgal etmektedir. Bu hafıza alanının büyüklüğü mikro işlemci mimarisine ve bus genişliğine göre 320K ile 1024K arasında değişmektedir.

Stack büyüklüğü şu şekilde ayarlanabilmektedir:

[sourcecode language=’java’]
java -server -Xss64k
[/sourcecode]

Stack için hafıza alanı yetmediği durumlarda StackOverflowException hatası oluşmaktadır. Bu tür hatalar genelde rekursiv çalışan ve son bulmayan metotlarda meydana gelmektedir. Eğer stack için bir hafıza limiti konulmamışsa, mevcut hafıza tüketilene kadar frame yapıları oluşturulabilir. Hafıza kalmaması durumunda OutOfMemoryError hatası oluşur.

Java dili call by value mantığı ile çalışmaktadır. Herhangi bir metot koşturulmadan önce, metoda gönderilen tüm parametreler koşturulacak yeni metodun stack ine kopyalanır. Bu işlem hem basit veri tipleri (int, long..) hem de referans veril tipleri için geçerlidir. Çoğu zaman Java dili için bir metoda parametre olarak gönderilen bir nesne referansının kopyalanmadığı, call by reference mantığı ile metoda aktarıldığı düşünülmektedir. Java’da referanslar bile metot girişlerinde kopyalanmaktadır.

Java’da referansların bile call by value mantığı ile işlediğini aşağıdaki örnekte görmekteyiz.

[sourcecode language=’java’]
private static void metot2() {
final Main m1 = new Main();
System.out.println(m1);
metot3(m1);
System.out.println(m1);
}

private static void metot3(Main m) {
m = new Main();
System.out.println(m);
}
[/sourcecode]

Bu metotları koşturduğumuzda, ekran çıktısı aşağıdaki şekilde olacaktır:

[sourcecode language=’java’]
com.kodkata.kata.jvm.Main@7150bd4d
com.kodkata.kata.jvm.Main@6bbc4459
com.kodkata.kata.jvm.Main@7150bd4d
[/sourcecode]

Eğer Java call by reference mantığı ile çalışmış olsaydı, ekran çıktısının şu şekilde olması gerekirdi, çünkü metot3() bünyesinde metot parametresi olan m isimli referansa yeni bir nesne atadık:

[sourcecode language=’java’]
com.kodkata.kata.jvm.Main@7150bd4d
com.kodkata.kata.jvm.Main@6bbc4459
[/sourcecode]

Lakin metot2() bünyesinde oluşturulan m1 isimli referans metot3() stack ine kopyalandığı için, metot3() bünyesinde bu referansa yaptığımız yeni bir atama metot2() bünyesindeki m1 referansını etkilememektedir.

Java uygulamalarında oluşan hataları java.lang.Throwable ya da türevleri temsil eder. Bu sınıf bünyesinde yer alan printStackTrace() metodu aracılığı ile hata oluşan yere kadar gelinen stack yapısına ulaşmak mümkündür. Bunun bir örneğini aşağıda görmekteyiz.

[sourcecode language=’java’]
java.lang.ArrayIndexOutOfBoundsException: 3
at com.kodkata.jvm.TestTry.execute(Testtry.java:17)
at com.kodkata.jvm.TestTry.main(Testtry.java:11)
[/sourcecode]

Bu stacktrace örneğinde iki stack frame yer almaktadır. İlk frame TEstTry sınıfının main() metodu için, ikinci frame bu metot bünyesinde execute() metodu koşturulduğu için oluşturulmuştur. Stacktrace bünyesinde oluşturulan her iki frame yer almaktadır. execute() metodunun on yedinci satırında ArrayIndexOutOfBoundsException hatasının oluştuğunu görmekteyiz.


EOF (End Of Fun)
Özcan Acar

JVM Nasıl Çalışır Yazı Serisi – Java Dilinde Neden Göstergeçler (Pointer) Yok?

Java’da göstergeçler var, ama C dilinde olduğu şekilde işlemiyorlar. Bu yazımda Java’da göstergeçlerin neden olmadığını aktarmaya çalışacağım.

C dilinde aşağıdaki şekilde bir göstergeç tanımlaması yapilabilmektedir:

[sourcecode language=”java”]

int i, *ptr;
ptr = &i;
*ptr=10;
[/sourcecode]

Bu örnekte i isminde ve int veri tipinde bir değişken ve yine int veri tipine sahip ve ptr isminde bir göstergeç tanımladık. C dilinde göstergeçler bir hafıza alanına işaret ederler. Yukarıdaki örnekte ptr in sahip olduğu değer i değişkeninin hafızadaki adresidir. ptr üzerinde yapılan her işlem i değişkenini etkileyebilir, çünkü ptr dolaylı olarak i değişkeninin sahip olduğu değere işaret etmektedir. Göstergeç aritmetiği sayesinde hafıza alanlarını doğrudan adreslemek ve o hafıza alanlarında yer alan değerler üzerinde işlem yapmak mümkündür.

Java’da göstergeç tanımlamaları ve hafıza alanları üzerinden doğrudan işlem yapmak mümkün değildir, çünkü:

  • Java sanal makinesi (Java Virtual Machine) hafıza alanını kendisi yönetir.
  • Java’da array ve list nesnelerinin uzunlukları JVM tarafından kontrol edilir. Olmayan array elemanları üzerinde işlem yapmaya çalışmak ArrayIndexOutOfBoundsException hatasını oluşturur.
  • Java dilinde array dilin bir parçasıdır ve string işlemleri için String sınıfı kullanılır. C dilinde göstergeçler aracılığı ile bu yapılar oluşturulur ve dilin bir parçası değildirler.
  • Java nesne referanslarını JVM bünyesinde yer alan garbage collector aracılığı ile yönetir.

Java dilinde göstergeçler sadece nesnelere işaret eden değişken isimleri olarak kullanılırlar, ama:

  • Bu değişkenler üzerinde göstergeç aritmetiği yapılamaz
  • Sadece nesnelere işaret ederler, adres alanlarına değil

Java’da bu nesne göstergeçlerine referans ismi verilmektedir.

Aşağıdaki Java kodunu koşturduğunuzda NullPointerExceptin oluşmaktadır:

[sourcecode language=”java”]

Nesne nesne = null;
nesne.birMethod();
[/sourcecode]

Peki neden oluşan hatanın ismi NullPointerException seklindedir de NullReferenceException değildir? Bu sorunun cevabını bende bilmiyorum. Java’da NullReferenceException olmalıydı. NullPointerException sınıfının kaynak koduna baktığımızda, sınıfın kim tarafından geliştirildiği görememekle birlikte, JDK1.0 dan beri Java’nın bir parçası olduğunu görmekteyiz. Bu sanırım Java dilini oluşturanların C/C++ kökenli olmalarından kaynaklanıyor. Ama C# dilinde NullReferenceException isminde ve aynı vazifeyi gören bir sınıf mevcut. C# dil geliştiricileri aynı hatayı yapmamış.

[sourcecode language=”java”]

/**
* @author unascribed
* @version %I%, %G%
* @since JDK1.0
*/
public
class NullPointerException extends RuntimeException {
}
[/sourcecode]

Şüphesiz Java dilinde göstergeçlerin ve göstergeç aritmetiğinin olmaması Java’da geliştirilen kodun daha kolay anlaşılır olmasını sağlamaktadır. C kodu çok kısa zamanda göstergeçlerin yerli, yersiz kullanılmalarından dolayı kaotik bir yapıya bürünebilir. Ama bunun karşılığında göstergeçler yardımı ile donanıma çok yakın kalınarak, uygulama geliştirmek mümkündür. Java’da bu ne yazık ki mümkün değil. Sizinle donanım arasında her zaman JVM olacak.


EOF (End Of Fun)
Özcan Acar
JVM Nasıl Çalışır Yazı Serisi – Java Hotspot, Assembly Kod, Hafıza Bariyerleri ve Volatile Analizi

Java siniflari java derleyicisi javac (compiler) tarafından bytekoduna dönüştürülür.

[source language=”java”]
public class HelloWorld {

public static void main(String[] args) {
System.out.println("Hello World");
}
}
[/source]

Yukarida yer alan HelloWorld sinifinin bytekod olarak derlenmis seklini asagida görmekteyiz:

[source language=”java”]
public class HelloWorld extends java.lang.Object{
public HelloWorld();
Code:
0: aload_0
1: invokespecial #1; //Method java/lang/Object."<init>":()V
4: return

public static void main(java.lang.String[]);
Code:
0: getstatic #2; //Field java/lang/System.out:Ljava/io/PrintStream;
3: ldc #3; //String Hello World
5: invokevirtual #4; //Method java/io/PrintStream.println:(Ljava/lang/String;)V
8: return
}
[/source]

Derlenmis bir java sinifinin bytekod ciktisini su sekilde alabiliriz:

[source language=”java”]
javap -classpath . -c HelloWorld
[/source]

Oluşan bytekod dogrudan işlemci (CPU) üzerinde koşturulamaz, cünkü bytekod islemcinin anlayacagi bir yapida degildir. Bytekodu yorumlayan birimin adi java sanal makinedir (jvm – java virtual machine). Kosturmak istedigimiz derlenmis bir java sinifi classloader olarak tanimlanan sinif yükleyicileri tarafindan hafizaya yüklenir. Bu islemi örnegin su sekilde baslatabiliriz:

[source language=”java”]
java -classpath . HelloWorld
[/source]

Java komutu sanal makineyi baslatir ve sanal makinenin bünyesindeki sinif yükleyicileri devreye girerek, derlenmis ve bir class dosyasi halindeki HelloWorld sinifini hafizaya yükler. HelloWorld sinifi bünyesindeki kodlarin sanal makine tarafindan kosturulabilmeleri icin bu sinif bünyesinde main() isminde bir metodun bulunmasi gerekmektedir. Bu metod uygulamanin giris noktasidir ve sanal makina bu metodun basindan itibaren komutlari kosturmaya baslar.

Sanal makine bytekodlari iki sekilde kosturur. Bunlardan ilkinde bytekod yorumlanir. Ikincisinde ise bytekod mikroislemcinin anlayacagi sekilde derlenir. Bytekodun yorumlanmasi durumunda sanal makine bytekodun karsiligi olan islemci kodunu (microcode) tespit eder ve bu islemci kodunun kendi bünyesindeki derlenmis halini islemci üzerinde kosturur. Bytekodun yorumlanmasi java uygulamalarinin daha yavas calisir durumda olmalari dejavantajini beraberinde getirmektedir. Uygulamanin performansini artirmak icin bytekodun islemci koduna derlenmesi gerekmektedir. Bytekod derleme görevini sanal makine bünyesinde JIT (just in time) Hotspot derleyicisi (compiler) üstlenmektedir. Sikca ihtiyac duyulan kod birimleri JIT tarafindan derlenir ve dogrudan islemci üzerinde kosturulur. JIT olmadan sanal makine sadece bir bytekod yorumlayıcısıdır (interpreter). Hotspot çok sık kullanılan kod bölümlerini, mikroişlemci üzerinde daha hızlı koşturulabilmeleri için doğrudan mikroislemci koduna dönüştürür. Bu işlemi yapabilmesi için belli bir süre kodu analiz etmesi (profiling) gerekmektedir. Bu sebepten dolayı Java uygulamaları belli bir ısınma aşamasından sonra daha hızlı çalışmaya başlarlar, çünkü bytekodun belli bir kısmı ya da hepsi JIT tarafından Assembly oradan da islemi koduna dönüştürülmüştür.

JIT tarafından oluşturulan Assembly kodunun çıktısını alabilmek için bir Hotspot Disassembler plugin kullanmamız gerekmektedir. Kenai base-hsdis projesi bünyesinde böyle bir plugin yer almaktaktadır. Ben bu yazımdaki örnekler için Linux altında 64 bit JDK7 (jdk1.7.0_45) kullandım. Kullandığım disassembler plugin linux-hsdis-amd64.so ismini taşıyor. Bu dosyanın libhsdis-amd64.so ismini taşıyacak şekilde jdk1.7.0_45/jre/lib/amd64/server dizinine kopyalanması gerekiyor. Bu işlem ardından çalışan bir Java uygulamasının makine kodu çıktısını alabiliriz.

Önce koşturmak istediğimiz Java koduna bir göz atalım. Main sınıfı bünyesinde volatile olan volatileCounter ve counter değişkenleri yer almaktadır. count() metodu bünyesinde bir for döngüsünde bu değişkenlerin değerleri artırılmaktadır. For döngüsü volatileCounter değişkeni 100000 değerine ulaştığında son bulmaktadır. Hotspot JIT kod 100000 sefer koşturulduğundan dolayı islemci makine koduna dönüştürmektedir. Bu uygulamanın çok sıkca kullanılan alanlarının (hotspot; sıcak alan anlamında) makine koduna dönüştürülerek, daha da hızlı koşturulabilmeleri için gerekli bir işlemdir. Hotspot sadece sıkca koşturulan kodları makine koduna dönüştürür. Sıkça kullanılmayan kod bloklarının JVM tarafından yorumlanma hızı yeterlidir. Bu tür kodlar için makine kodunun oluşturulması çok maliyetli bir işlemdir. Elde edilecek kazanç çok az olacağından, sıkça kullanılmayan kod blokları makine koduna dönüştürülmez.

Eğer count() metodunda bir for döngüsü kullanılmasaydı, JIT tarafından daha sonra inceleyecegimiz assembly kodu oluşturulmazdı. Bunu sağlayan döngünün 100000 adet olmasıdır. JIT hangi kod bloğunun ne kadar koşturulduğunu takip ettiği için hangi kod birimi için makine kodu oluşturacağına karar verebilmektedir.

[source language=”java”]
public class Main {

private volatile int volatileCounter;
private int counter;

public static void main(final String[] args) {

new Main().count();
}

private void count() {

for (; this.volatileCounter < 100000;) {
this.volatileCounter++;

synchronized (this) {
this.counter++;
}
}
}
}
[/source]

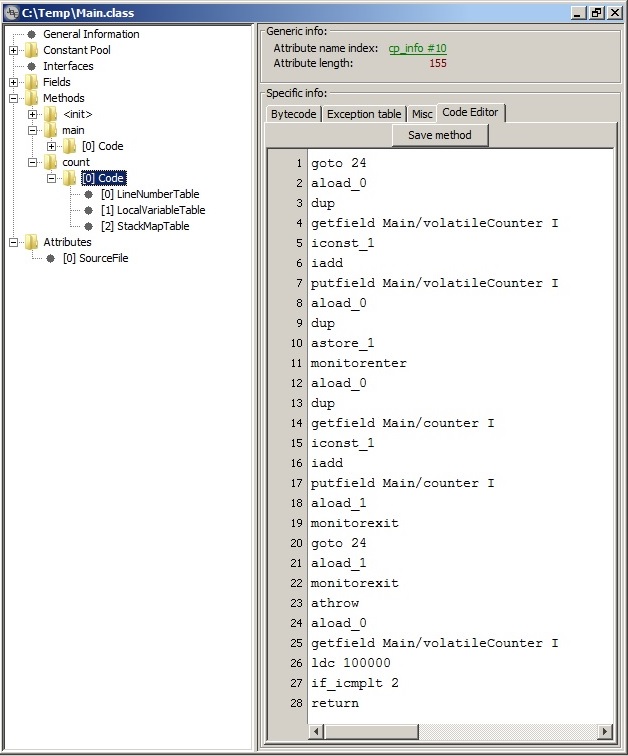
Java derleyicisi (javac) tarafından oluşturulan bytekodunu aşağıdaki resimde görmekteyiz.

Şimdi gelelim Hotspot JIT tarafından oluşturulan assembly koduna. Assembly kodunu görebilmek için java sanal makineyi aşağıdaki şekilde çalıştırmamız gerekiyor:

[source language=”java”]
java -cp . -XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly Main
[/source]

Aşağıda oluşan Assembly kodu yer almaktadır:

[source language=”java”]
1 0x00007f206906015c: jne 0x00007f2069060202 ;*monitorenter
; – Main::count@16 (line 16)
2 0x00007f2069060162: incl 0x10(%r13)
3 0x00007f2069060166: mov $0x7,%r10d
4 0x00007f206906016c: and 0x0(%r13),%r10
5 0x00007f2069060170: cmp $0x5,%r10
6 0x00007f2069060174: jne 0x00007f2069060226 ;*monitorexit
; – Main::count@28 (line 16)
7 0x00007f206906017a: mov 0xc(%r13),%r11d ; OopMap{rbp=NarrowOop r13=Oop r14=Oop off=222}
;*if_icmplt
; – Main::count@41 (line 13)
8 0x00007f206906017e: test %eax,0xa91ee7c(%rip) # 0x00007f207397f000
; {poll}
9 0x00007f2069060184: cmp $0x186a0,%r11d
10 0x00007f206906018b: jge 0x00007f20690602ef ;*aload_0
; – Main::count@3 (line 14)
11 0x00007f2069060191: mov 0xc(%r13),%r11d
12 0x00007f2069060195: inc %r11d
13 0x00007f2069060198: mov %r11d,0xc(%r13)
14 0x00007f206906019c: lock addl $0x0,(%rsp) ;*putfield volatileCounter
; – Main::count@10 (line 14)
15 0x00007f20690601a1: mov 0x0(%r13),%rax
16 0x00007f20690601a5: mov %rax,%r10
17 0x00007f20690601a8: and $0x7,%r10
18 0x00007f20690601ac: cmp $0x5,%r10
19 0x00007f20690601b0: jne 0x00007f2069060106
20 0x00007f20690601b6: mov 0xb0(%r12,%rbp,8),%r10
21 0x00007f20690601be: mov %r10,%r11
22 0x00007f20690601c1: or %r15,%r11
23 0x00007f20690601c4: mov %r11,%r8
24 0x00007f20690601c7: xor %rax,%r8
25 0x00007f20690601ca: test $0xffffffffffffff87,%r8
26 0x00007f20690601d1: je 0x00007f2069060162
27 0x00007f20690601d3: test $0x7,%r8
28 0x00007f20690601da: jne 0x00007f2069060100
29 0x00007f20690601e0: test $0x300,%r8
30 0x00007f20690601e7: jne 0x00007f20690601f6
31 0x00007f20690601e9: and $0x37f,%rax
32 0x00007f20690601f0: mov %rax,%r11
33 0x00007f20690601f3: or %r15,%r11
34 0x00007f20690601f6: lock cmpxchg %r11,0x0(%r13)
35 0x00007f20690601fc: je 0x00007f2069060162
36 0x00007f2069060202: mov %r14,0x8(%rsp)
37 0x00007f2069060207: mov %r13,(%rsp)
38 0x00007f206906020b: mov %r14,%rsi
39 0x00007f206906020e: lea 0x10(%rsp),%rdx
40 0x00007f2069060213: callq 0x00007f206905e320 ; OopMap{rbp=NarrowOop [0]=Oop [8]=Oop off=376}
;*monitorenter
; – Main::count@16 (line 16)
; {runtime_call}

[/source]

Java kodu sequentially consistent değildir yani Java bytekodun sahip olduğu sıraya göre satır satır koşturulma mecburiyeti yoktur. Hem Java derleyicisi (JIT) hem de mikroişlemci performansı artırmak için birbirine bağımlı olmayan kod satırlarının yerlerini değiştirerek işlem yapabilirler. Bu aslında oluşan java kodunun programcının yazdığı şekilde koşturulmadığı anlamına gelmektedir. Paralel çalışan programlarda bunun çok ilginç bir yan etkisi mevcut: bir threadin bir değişken üzerinde yaptığı değişikliği başka bir çekirdek üzerinde koşan başka bir thread göremeyebilir. Örneğin t1 (thread 1) a isimli değişkenin değerini bir artırdı ise ve t2 a belli bir değere sahip iken bir for döngüsünü terk etmek istiyorsa, t2 belki bu for döngüsünden hiçbir zaman çıkamayabilir, çünkü a üzerinde t1 tarafından yapılan değişiklikleri göremeyebilir. Bunun sebebi t1 in üzerinde çalıştığı çekirdeğin (core) a üzerinde yaptığı değişiklikleri kendi ön belleginde (L1/L2 cache) tutmasıdır. Mikroişlemciler yüksek performansta çalışabilmek için hazıfa alanları üzerinde yaptıkları değişiklikleri ilk etapta kendi ön belleklerinde tutarlar. Gerek duymadıkça da bu değişiklikleri diğer çekirdeklerle paylaşmazlar. Her çekirdek sahip olduğu önbelliği tüm hafiza alanıymış (RAM) gibi gördüğü için kendi performansını artırmak adına kod sırasını değiştirebilir. Bu belli bir sıraya bağımlı olan diğer threadlerin düşünüldükleri şekilde çalışmalarını engelleyebilir. Bu genelde paralel programlarda program hatası olarak dışarıya yansır.

Bu tür sorunları aşmanın bir yolu volatile tipinde değişkenler kullanmaktır. Volatile tipinde olan değişkenler üzerinde işlem yapıldığında mikroişlemci kodu programcının yazdığı sırada koşturmaya zorlanır. Bunu gerçekleştirmek için hafıza bariyerleri (memory barrier) kullanılır. Mikroişlemci bir hazıfa bariyeri ile karşılaştığında bir çekirdeğin sahip olduğu önbellekteki değişiklikleri doğrudan hafızaya geri yazar (write back) ve bu hazıfa alanını (cache line) kendi önbelleklerinde tutan diğer çekirdeklere mesaj göndererek bu hafıza alanını silmelerini (cache invalidate) talep eder. Böylece herhangi bir çekirdek üzerinde koşan bir threadin yaptığı değişiklik hemen hafızaya, oradan da diğer çekirdeklerin önbelleklerine yansır. Bu t1 tarafından a üzerinde yapılan bir değişikliğin t2 tarafından anında görülmesi anlamına gelmektedir. Bunun gerçekleşmesi için a isimli değişkenin volatile olması gerekmektedir.

Main sınıfında yer alan this.volatileCounter++; satırı ile bahsettiğim hafıza bariyerinin kullanımı gerekmektedir. JVM bunu sağlamak için Assemby kodunun 14. satırında mikroişlemci için lock addl komutunu kullanmaktadır. 13. satırda yer alan mov komutuyla %r11d registerinde yer alan volatileCounter isimli değişkenin değeri doğrudan hafızaya (RAM) aktarılır. Hafiza alanının adresi %r13 registerinde yer almaktadır. 14. satırda yer alan lock addl ile tüm mikroişlemci bünyesinde global bir hafıza transaksiyonu gerçekleştirilir. Atomik olan bu işlem ile tüm çekirdeklerin üzerinde değişiklik yapılan hafiza alanını önbelleklerinden silmeleri ve yeniden yüklemelerini sağlanır. Böylece diğer threadler yapılan değişiklikleri anında görmüş olurlar.

Java kodunu sequentially consistent yapmanın diğer bir yolu synchronized kelimesinin kullanımıdır. Synchronized kullanılması durumunda mikroişlemci değişikliğe uğrayan değeri önbellekten alıp hafızaya geri aktararak, diğer çekirdeklerin kendi önbelleklerini tazelemelerini sağlar.

Main sınıfında yer alan counter isimli değişken volatile olmadığı için üzerinde yapılan değişiklikler diğer çekirdeklere yansımaz. Bunu sağlamak için count() metodunda değer atamasını synchronized bloğunda yaptım. Bu JVM tarafından tekrar bir hafıza bariyeri kullanımı gerektiren bir işlemdir. JIT makina kodunun 34. satırında lock cmpxchg ile gerekli hafıza bariyerini oluşturmaktadır. Bu üzerinde işlem yapılan çekirdeğin counter isimli değişkenin değerini tekrar hafızaya geri aktarmasını ve diğer çekirdeklerin bu değeri tekrar hafızadan kendi önbelleklerine çekmelerini sağlamaktadır.


EOF (End Of Fun)
Özcan Acar
Java Generics Get ve Put Prensibi

Java Generics and Collections kitabında Get and Put isminde bir prensipden bahsediliyor. Java Generics wildcard kullanımı bu prensip takip edildiğinde daha kolaylaşıyor. Prensip şöyle:

Eğer bir yapıdan (liste, map vs.) nesne ediniyorsanız (get) extends wildcard, bir yapıya nesne ekliyorsanız (put) super wildcard kullanın. Bir yapı üzerinde bu iki işlemi birden yapıyorsanız, o zaman wildcard kullanmayın.

Bunu bir örnek ile açıklayalım. Aşağıdaki metot bir listeden diğer bir listeye nesneleri kopyalamak için kullanılan jenerik bir metot.

[source language=”java”]
public static <T> void copy(List<? super T> dest, List<? extends T> src) {
for (int i = 0; i < src.size(); i++) {
dest.set(i, src.get(i));
}
}
[/source]

copy metodunun ilk parametresi nesnelerin kopyalanacağı, yani put yapılacak olan liste, ikinci parametresi nesnelerin alındığı, yani get edildiği liste. Şu şekilde bir listeyi diğer bir listeye kopyalayabiliriz:

[source language=”java”]
List<Object> objs = Arrays.<Object>asList("String", 1, 3.14);
List<Integer> ints = Arrays.<Integer>asList(1,2);
copy(objs, ints);
[/source]

dest isimli parametre put işlemi yapıldığı için super wildcard’ını, src isimli parametre get yapıldığı için extends wildcard’ını kullanıyor.

Bir iterator kullanıldığında bir yapıdan get işlemi ile değerler edinilir. Bu durumda extends wildcard kullanılmalı. Aşağıdaki örnekte sum metodu bir listede yer alan Number sınıfı ve altsınıflarından oluşan nesnelerin değerlerini topluyor. Buna göre bu metodu sum(Arrays. asList(1, 2)) ya da sum(Arrays. asList(1.1, 2.2)) şeklinde koşturmak mümkün. Eğer extends wildcard kullanılmasaydı Integer ya da Double nesneler ihtiva eden bir listeyi sum metoduna parametre olarak vermek mümkün olmazdı.

[source language=”java”]
public static double sum(Collection<? extends Number> nums) {
double s = 0.0;
for (Number num : nums)
s += num.doubleValue();
return s;
}
[/source]

EOF (End Of Fun)
Özcan Acar
Java’da Bilinmeyenler

Bu yazımda Java programclarının bilmediği, doğru olarak kabul edip kullandığı ya da yanlış bildiği konulardan bahsetmek istiyorum.

Hafıza Alanı Ayarları
Genelde JVM için hazıfa alanı -Xmx -Xms parametreleri ile oluşturulur. -X ile başlayan parametreler standart JVM parametreleri değildirler, yani bu parametreleri JVM implemente etmek zorunda değildir. Durum böyle olunca -Xmx1024m şeklindeki bir parametre, eğer JVM -Xmx parametresini implemente etmedi ise JVM için kullanılan hafıza alanının 1GB olarak ayarlanmasını sağlayamayacaktır. -Xmx ve -Xms yerine standart olan -mx ve -ms parametreleri kullanılmalıdır.

finally Bloğu
try/catch/finally yapısında metot son bulmadan önce finally bloğunda yer alan kodun mutlaka koşturulduğu düşünülür. Ama bu tam doğru değildir. İki durumda finally içinde yer alan kod koşturulmaz. Bu iki durum: Eğer try içinde System.exit(0); komutu kullanıldı ise (bu durumda program hemen son bulur) ya da bir Thread try içindeki kodları koştururken bilgisayarın elektriği kesilirse ;-)

Call By Reference
Java tamamen call by value mantığı ile çalışır. Java’da call by reference mantığı olduğu bir yanılgıdır. Primitif veri tipleri (int, long vs) nasıl metotlara parametre olarak gönderildiklerinde değerleri kopyalanıyorsa, nesne referansları da metot için oluşturulan stack’e kopyalanır. Referans bir göstergeştir (pointer). Bir metoda parametre olarak gönderildiğinde, çoğaltılarak aynı nesneye işaret eden ikinci bir göstergeç oluşturulur. İkinci göstergeç te aynı nesneye işaret ettiği için, metot içinde işaret ettiği nesne üzerinde işlem yaparak nesnenin durumunu değiştirebilir. Bu değişikliklere metot dışındaki göstergeç üzerinden de erişmek mümkündür, çünkü iki göstergeç aynı nesneye işaret etmektedir. Metot içinde oluşturulan ikinci göstergece null değeri atandığında, metot dışındaki göstergeç bu durumdan etkilenmez. Bu nesne referanslarının metotlara parametre olarak gönderildiklerinde kopyalandıkları yani call by value mantığı ile çalıştıkları anlamına gelmektedir.

Java’da sadece call by value mantığının kullanıldığının kanıtı Java spesifikasyonunda yer alan şu cümledir :

When the method or constructor is invoked (15.12), the values of the actual argument expressions initialize newly created parameter variables, each of the declared Type, before execution of the body of the method or constructor. The Identifier that appears in the DeclaratorId may be used as a simple name in the body of the method or constructor to refer to the formal parameter.

String ve StringBuilder

“a”+”b” ile StringBuilder.append(“a”).append(“b”) arasında bytecode seviyesinde bir farklılık yoktur. “a”+”b” kullanıldığı taktirde bu bytecode seviyesinde StringBuilder.append(“a”).append(“b”) şekline dönüştürülür.

[source language=’java’]
public class Test
{

public static void main(String[] args)
{
StringBuilder temp = new StringBuilder();
temp.append(“a”);
temp.append(“b”);

String a =”a”;
String b = “b”;
System.out.println(a+b);
}

}
[/source]

[source language=’java’]
C:\Temp>javap -c Test
Compiled from “Test.java”
public class Test extends java.lang.Object{
public Test();
Code:
0: aload_0
1: invokespecial #1; //Method java/lang/Object.”“:()V
4: return

public static void main(java.lang.String[]);
Code:
0: new #2; //class java/lang/StringBuilder
3: dup
4: invokespecial #3; //Method java/lang/StringBuilder.”“:()V
7: astore_1
8: aload_1
9: ldc #4; //String a
11: invokevirtual #5; //Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
14: pop
15: aload_1
16: ldc #6; //String b
18: invokevirtual #5; //Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
21: pop
22: ldc #4; //String a
24: astore_2
25: ldc #6; //String b
27: astore_3
28: getstatic #7; //Field java/lang/System.out:Ljava/io/PrintStream;
31: new #2; //class java/lang/StringBuilder
34: dup
35: invokespecial #3; //Method java/lang/StringBuilder.”“:()V
38: aload_2
39: invokevirtual #5; //Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
42: aload_3
43: invokevirtual #5; //Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
46: invokevirtual #8; //Method java/lang/StringBuilder.toString:()Ljava/lang/String;
49: invokevirtual #9; //Method java/io/PrintStream.println:(Ljava/lang/String;)V
52: return

}
[/source]

Bu yazım devam edecek!!! Sizde bildiklerinizi lütfen yorum olarak bu yazıya ekleyin.

JVM Nasıl Çalışır Yazı Serisi – Old Generation Parallel Garbage Collector Hatası

Eğer özellikle bir Garbage Collector türü seçimi yapılmadı ise, 2 GB ve üzeri ve Windows işletim sistemi ile çalışmayan sunucularda JVM otomatik olarak paralel çalışan Garbage Collector’ü kullanıyor (-XX:UseParallelGC). Bu Garbage Collector sadece Young Generation üzerinde paralel, Old Generation için kullanılan Garbage Collector ise dizisel (serial) çalışıyor. Her iki heap alanında da paralel çalışan Garbage Collector’ü aktif hale getirmek için -XX=+UseParallelOldGC JVM parametresinin kullanılmasi gerekiyor. Bunu BizimAlem.com için çalışan uygulama sunucularından birinde denemek istedim. BizimAlem için JDK 1.5 kullanımda.

İkinci resimde görüldüğü gibi -XX:+UseParallelOldGC kullanıldığında JVM bir zaman sonra takılıp kalıyor ve çalışmaz hale geliyor. İlk denememde NewSize, SurvivorRatio gibi diğer parametrelerin hepsini deaktive edip, sadece -XX=+UseParallelOldGC parametresini kullanmıştım. Sonuç ikinci resimdeki gibi oldu. İlk önce yeni JVM ayarlarının sorun yarattığını düşündüm ve resim 1’de yer alan ayarlara geri döndüm. İkinci denememde de tekrar -XX=+UseParallelOldGC parametresini kullandım. Lakin ikinci denememde de JVM takılı kalıp, çalışmaz hale geldi. Buradan çıkardığımız sonuç: JDK 1.5 Update 12’de parallel Garbage Collector’ün bir bugı olsa gerek ;-)

EOF (End Of Fun)
Özcan Acar
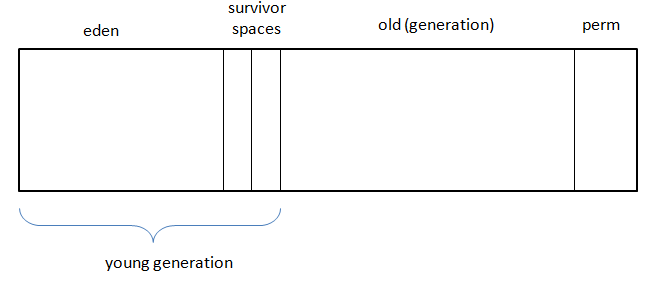
JVM Nasıl Çalışır Yazı Serisi – Çöplerin Efendisi

Java programcısının çok sadık bir hizmetçisi var. Her türlü çöplüğü, pisliği arkasından devamlı toplar, hiç sesini çıkarmaz. Çöplerin efendisidir, ama bir o kadar da mütevazidir. Kimseye belli etmeden işini görür. Bu yüzden birçok Java programcısı onun farkında bile değildir. Ama o işini yapmasa Java programcısının hali çok vahim olur, C/C++ ile kod yazan meslektaşlarından bir farkı kalmaz, bilgisayarın hafızası denilen kara delikte kaybolur gider, yazdığı programlar devamlı sallanır.

Garbage Collector’dan bahsediyorum. Çoğu Java programcısının varlığından bile haberdar olmadığı, bazılarının çekindiği, bazılarının ne yaptığını tam olarak anlamdığı, bazılarının ise yaptığı işe hayran olup, ince ince hayranlık duyduğu Garbage Collector… Java’yı Java yapan özelliklerinden bir tanesi bir Garbage Collector’e sahip olmasıdır. Şimdi yakından tanıyalım bu kahramanı.

Java dilinde herhangi bir sınıftan bir nesne oluşturmak için new operatörü, Class.forName().newInstance(), clone() veya readObject() metodu kullanılır. Örneğin new operatörü sınıfın konstrüktörünü kullanarak JVM bünyesinde yeni bir nesne oluşturur. Nesne inşa edildikten sonra Java Heap içinde konuşlandırılır. Nesnelerin hepsi kullanıldıkları sürece heap icinde mutlu, mesut hayatlarını sürdürürler. Ama her canlı gibi onlar da birgün ölürler. Öldüklerinde onları toplayıp, ebediyete intikal ettiren Garbage Collector’dür.

İngilizce’de garbage çöp anlamına gelmektedir. Garbage Collector JVM bünyesinde hem yeni nesnelerin doğmasına yardımcı olan, hem de ölen nesneleri ortadan kaldıran modüldür. new operatörü ile doğan yeni nesneler için Garbage Collector hafıza alanını temin eder. Ölen ve çöp olarak isimlendirilen nesnelerin işgal ettikleri hafıza alanını Garbage Collector boşaltır ve yeni nesnelere tayin eder. Garbage Collector kısaca Java’da otomatik hafıza yönetiminden sorumludur. Onsuz Java’nın C/C++ dilinden bir farkı kalmazdı.

Garbage Collector’ün nasıl çalıştığını görebilmek için aşağıda yer alan videoyu hazırladım. Collector’ü kızdırmak için bolca çöp (garbage) üreten minik bir Java programını şu şekilde oluşturmak yeterli:

[source language=’java’]
package com.kurumsaljava.jvm.garbage;

import java.util.ArrayList;
import java.util.List;

public class Heap {

public static void main(String[] args) throws Exception {
List temp = new ArrayList();

Thread.sleep(10000);
while (true) {

temp.add(“xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx”);
//System.out.println(temp.size());

if(temp.size() > 3000000) {
temp = null;
temp = new ArrayList();

}
}
}
}
[/source]

Heap ismini taşıyan sınıf bünyesinde x’lerden oluşan uzunca bir String nesnesini sonsuz bir döngü içinde temp ismindeki bir listeye yerleştiriyoruz. Liste bünyesinde yer alan String nesne adedi 300.000’e ulaştığında listeye null değerini atayarak siliyor ve yeniden bir liste oluşturuyoruz. Döngü içinde tekrar String nesneleri yeni listeye ekleniyor. Buradaki amacım hafızanın tükenmesi ile java.lang.OutOfMemoryError oluşmasını engellemek ve Garbage Collector’ün değişik heap alanları üzerinde nasıl çalıştığını gösterebilmekti. Java’da herhangi bir nesneye null degeri atandığında Garbage Collector’e “bu nesne ölmüştür, yok edilebilir” mesajı verilmektedir. Eğer bu nesneye herhangi başka bir nesneden referans yoksa, Garbage Collector bu nesneyi öldü kabul edip, temizleyecektir. Şimdi beraber videoyu izleyelim.

Videoda yer alan program için 64 MB büyüklüğünde bir heap alanını -Xms64m -Xmx64m JVM parametreleri kullanarak tahsis ettim. Eğer heap alanı 10 MB olursa OutOfMemoryError hatası oluşmaktadır. Aynı şekilde liste içindeki String nesne adedini 600.000’e çıkardığımda hafıza yetersizliğinden dolayı OutOfMemoryError hatası oluşmaktadır.

Video ve oluşan Garbage Collection aktiviteleri hakkında detaya girmeden önce, değişik Garbage Collector mekanizmalarını ve algoritmalarını gözden geçirelim.

Generational Garbage Collection

Tipik bir Java uygulaması gözlemlendiğinde, uygulamanın hayatı süresince oluşan birçok nesnenin kısa ömürlü oldukları görülmektedir. Oluşturulan nesnelerin çogu bir metot son bulduktan sonra, sadece metot bünyesinde kullanıldıkları için hayata gözlerini yumarlar. Bunun yanısra bir Java uygulaması bünyesinde nesneler yaşlanarak belli bir yaşa erişebilirler. Bir nesnenin yaşlanma süreci uygulama bünyesinde kullanılma derecesini yansıtmaktadır.


Resim 1

Java uygulamarında oluşturulan nesnelerin hayat döngülerini yönetmek icin Sun firması tarafından JDK 1.3 versiyonu ile Generational Garbage Collection geliştirilmiştir. Resim 1’de görüldüğü gibi Generation Garbage Collection ile Java uygulamasının kullandığı hazıfa iki jenerasyona bölünmektedir. Yeni doğan nesneler genç jenerasyon (young generation), orta ve ileri yaşlı nesneler yaşlı jenerasyon (old generation) bölümünde konuşlandırılırlar.

Nesnelerin ait oldukları yaş gurubuna gore ihtiyaç duyulan hafıza yönetim mekanizmaları farklılık gösterir. Yeni jenerasyon bünyesinde nesne doğum ve ölümleri çok hızlı gerçekleşir. Bu bölümde kullanılan Garbage Collection algoritmasının yeni doğan nesnelere hızlı bir şekilde hazıfa alanı tahsis etmesi, ölen nesneleri ortadan kaldırması gerekmektedir. Bu jenerasyon için kullanılan Garbage Collection algoritması bu ihtiyaca cevap verecek şekilde geliştirilmiştir. Yaşlı jenerasyonda durum farklıdır. Bu bölümde Formel 1’de olduğu gibi hızlı haraket etme gerekliliği yoktur. Bu jenerasyonda nesneler daha yavaş bir hayat temposuna sahiptir. Bu jenerasyonda kullanılan Garbage Collection algoritması buna uygun şekilde geliştirilmistir.

Young Generation Garbage Collection

Young generation üç hafıza alanından oluşmaktadır. Bunlar Eden, Survivor 1 ve Survivor 2 hafıza alanlarıdır. Bir Java uygulamasında nesnelerin hepsi gözlerini Eden hafıza alanında dünyaya açarlar. Survivor 1 ve Survivor 2 alanları geçici ara hafıza alanı olarak kullanılır. Eden hafıza alanı dolduğunda, Garbage Collector hayatta kalan nesneleri önce boş olan Survivor alanlarından birisine kopyalar. Bu işlemin ardından Garbage Collector Eden ve kullanımda olan Survivor alanını boşaltır. Eden hafıza alanı tekrar dolduğunda, hayatta kalan nesneler ve dolu olan Survivor alanındaki nesnelerin hepsi tekrar boş olan Survivor alanına kopyalanır. Her zaman bir Survivor alanı boştur ve bir sonraki Garbage Collection işlemi sonunda hayatta kalan nesneleri bünyesine alacak şekilde pasif olarak bekler. Videoda da Eden ve Survivor hafıza alanlarının Garbage Collector tarafından doldurulma ve boşaltılma işlemleri görülmektedir. Young generation bünyesinde çalışan Garbage Collection mark & copy (işaretle ve kopyala) algoritmasını kullanmaktadır. Şimdi bu algoritmanın nasıl çalıştığını yakından inceleyelim.

Mark & Copy Algoritması

JVM bünyesinde kullanılan tüm Garbage Collection mekanizmaları hayattaki nesneleri işaretleme (mark) işlemi ile işe başlarlar. Garbage Collector hangi nesnelerin hayatta olduğunu anlamak için kök setini (root set) oluşturan nesnelerden yola çıkıp, diğer nesnelere olan bağlantıları takip eder. Bu işlemi bir ağacın kökünden yola çıkarak, dallarına kadar erişme olarak düşünebiliriz. Garbage Collector bu şekilde hayatta olan tüm nesneleri işaretler. Erişemediği diğer nesnelerin hepsini ölü kabul eder ve bir sonraki Garbage Collection ile ortadan kaldırılmalarını sağlar. Kök setinde kendisine doğru nesne referansı olmayan, ama kendisinden başka nesnelere referans giden nesneler yer alır. Bu tip nesneler genelde metot parametreleridir ya da global geçerliliği olan statik olarak tanımlanmış nesnelerdir.


Resim 2

Resim 2’de kök setin A ve E nesneslerinden oluştuğu görülmektedir. Garbage Collector işaretleme işine önce A nesnesinden yola çıkarak başlar. B, C ve dolaylı olarak D nesnelerine erişir ve bu nesne kümesini (A,B,C,D) hayatta olan nesneler olarak işaretler. İşaretleme işine E nesnesi ile devam eder. E nesnesi kök setinde yer alan bir nesnedir, lakin E’den yola çıkarak başka bir nesneye erişmek mümkün değildir. Ayrıca başka bir nesne de E nesnesine işaret etmemektedir. Bu yüzden E nesnesi artık ölmüş bir nesnedir ve bir sonraki Garbage Collection ile E nesnesinin işgal ettiği hafıza alanı temizlenir.

Garbage Collector işaretleme (mark) işlemini tamamladıktan sonra hayatta kalan nesneleri aktif olan Survivor alanına kopyalama işlemine başlar. Garbage Collector resim 2’de görüldüğü gibi hayatta kalan nesne kümesini (ABCD) aktif olan Survivor 1 alanına kopyalar. Nesneler, işgal ettikleri adres alanları arka arkaya gelecek şekilde Survivor 1’de konuşlandırılır. Garbage Collection işlemi sonunda hayatta kalan nesnelerin birbirlerine olan referansları ve sahip oldukları adres alanları değişeceği için Garbage Collector işaretleme ve kopyalama işlemi öncesinde uygulama bünyesinde çalışan tüm threadleri durdurmak zorundadır. Bu işlem JVM terminolojisinde dünyayı durdurma (stop the world) olarak adlandırılır. Belli bir süre boyunca uygulama durur ve uygulama bünyesinde aktif olan sadece Garbage Collector’dür. Eğer Garbage Collector işine başlamadan önce dünyayı durdurmamış olsa, aktif olan uygulama threadleri nesne referansları üzerinde değişiklik yaparak, Garbage Collector’ün yanlış nesneler üzerinde işlem yapmasına sebep olabilirler. Bu sebepten dolayı Garbage Collection öncesi dünyanın durması gerekmektedir.


Resim 3

Resim 3’de Garbage Collection sonrasınra Eden bünyesinde yeni nesnelerin oluştuğu görülmektedir. Kök set içinde X ve W nesnesi yer almaktadır. Garbage Collector X,Y,Z ve Survivor 1’de yer alan ABCD nesnelerini Survivor 2’ye kopyalar. Garbage Collection işlemi sonunda young generation hafıza alanındaki son durum resim 4’de yer almaktadır.


Resim 4

Görüldüğü gibi her Garbage Collection sonunda Survivor alanları rolleri değiştirmektedir. Survivor alanlarının her Garbage Collection sonrası yer degiştirmeleri resim 5’de de görülmektedir.


Resim 5

Resim 5’de yer alan birinci kolon Survivor 1’in, ikinci kolon Survivor 2’nin, üçüncü kolon Eden’in, dördüncü kolon Old hafıza alanının doluluk oranını göstermektedir. Görüldüğü gibi Garbage Collector düzenli olarak hayatta kalan nesneleri kopyalamak için pasif olan Survivor alanını kullanmaktadır.


Resim 6

Bir Java uygulaması -XX:+PrintHeapAtGC JVM parametresi ile çalıştırıldığv zaman, resim 6’da yer alan Garbage Collection log kayıtları oluşmaktadır. İlk kırmızı işaretli alan içinde Survivor 1 from, Survivor 2 ise to olarak isimlendirilmiştir. Survivor 1’in hafıza başlangıç adresi 0x30e40000, Survivor 2’nin hafıza başlangıç adresi 0x30c20000’dir. İkinci kırmızı işaretli alana baktığımızda from ve to’nun adres alanlarının değiştiğini görmekteyiz. Garbage Collection işlemi oluşmuş ve Survivor alanları yer degiştirmiştir. Garbage Collector tarafından hep bir Survivor alanı reserve durumunda bir sonraki Garbage Collection içinde kullanılmak üzere beklemede tutulur. Bu dogal olarak belirli bir hafıza alanının kullanılmayarak israf edildiği anlamına gelir. Ne yazık ki bu Mark & Copy algoritmasının bir dejavantajıdır. Bunun haricinde bu algoritma hızlı bir şekilde Eden bünyesinde olup bitenlere cevap verebilecek yetenekte ve kapasitededir.

Minor & Major Garbage Collection

Garbage Collection minor (küçük) ve major (büyük) olmak üzere ikiye ayrılır. Minor Garbage Collection’ı kendi odamızı, Major Garbage Collection’ı evimizi temizleme gibi düşünebiliriz. Young Generation bünyesinde yapılan Garbage Collection işlemine minor Garbage Collection, JVM kontrolündeki tüm hafıza alanlarının temizlenme işlemine major Garbage Collection ismi verilir.


Resim 7

Resim 7’de Garbage Collector tarafından yapılan minor ve major Garbage Collection işlemleri yer almaktadır. GC ile başlayan satırlar minor, Full GC ile başlayan satırlar major Garbage Collection yapıldığınin ibaresidir. Major Garbage Collection işlemi için ayrıca Full Garbage Collection ismi de kullanılmaktadır.

İlk satırda young generation tarafından işgal edilen hafıza alanı toplamda 11994 kilobytetır (~ 12 MB). Minor Garbage Collection işlemi sonunda ölen nesneler temizlenmiş ve hayatta kalan nesnelerin kapladığı alan 4048 (~ 4 MB) kilobyte olarak değişmiştir. Garbage Collector minor Garbage Collection işlemi ile 8 MB civarında ölü nesneyi hafıza alanından kaldırmıştır. Bu minor Garbage Collection işlemi 0.02 saniye sürmüştür. Bu zaman diliminde JVM bünyesinde sadece Garbage Collection işlemi yapılmıştır. Parantez içinde yer alan 63360K (~ 64 MB) JVM tarafından kullanılan tüm hafıza alanlarının toplamını yansıtmaktadır. JVM parametreleri olarak -Xms64m -Xmx64m kullandığımız için, programın işgal ettiği toplam hafıza alanı 64 MB’dir.

Eden hafıza alanı, Old hafıza alanına göre daha küçük olduğu için bu alanda minor Garbage Collection işlemleri Old generation bünyesinde olan major Garbage Collection işlemlerinden sayıca çok daha fazladır. Resim 7’de Garbage Collector 20 minor Garbage Collection, buna karşılık sadece 4 major Garbage Collection gerçekleştirmiştir.


Resim 8

Yedinci satırda major Garbage Collection yapıldığını görmekteyiz. Tüm JVM bünyesinde 56241 kilobyte (~56 MB) hafıza alanı kullanımdadır (young + s0 + s1 + old). Görüldüğü gibi bu değer JVM hafıza büyüklüğü olan 64 MB’ye yakın bir değerdir. Resim 8’de young ve old generation hafıza alanlarının dağılım oranları yer almaktadır. JVM Eden için 17 MB, S0 için 2 MB, S1 için 2 MB ve Old icin 42 MB alan ayırmıştır. JVM parametreleri ile hafıza alanlarının büyüklüklerini değiştirmek mümkündür. Buna yönelik bir ayarlama yapılmadığında JVM otomatik olarak hafıza alanlarının büyüklüğünü ayarlar. Full GC ardından hayatta kalan nesnelerin kapladığı alan 6011 kilobyte (~6MB) olarak değişmiştir. Bu major garbage collection işlemi ile 50 MB büyüklüğünde nesneler Garbage Collector tarafından ebediyete uğurlanmıştır.

Durdurun Dünyayı

“Durdurun dünyayı başım dönüyor” diyor Ferdi Tayfur şarkısında. JVM mucitleri Ferdi Tayfur’un bu şarkısından esinlenerek dünyayı durduran Garbage Collector algoritmaları geliştirmişlerdir. Arabesk müziğin Java üzerindeki etkilerini başka bir yazımda detaylı olarak ele alacağım. Arabeskin programcılık üzerinde etkileri düşünüldüğünden çok daha fazladır. (:)

Garbage Collector minor Garbage Collection için tek bir thread (Reaper Thread) kullanmaktadır. Garbage Collection işlemi esnasında Garbage Collector JVM bünyesinde çalışan tüm threadleri durdurur. Uygulama için dünya durmuş olur. Dünya ne kadar uzun durursa, uygulamanın kullanıcıya verdiği cevaplar o oranda gecikir. Buradan Garbage Collection işlemi esnasında verilen araların mümkün olduğunca kısa olması gerektiği sonucu çıkmaktadır. JVM mucitleri bunu göz önünde bulundurarak paralel çalışan minor Garbage Collection algoritması geliştirmişlerdir.

Paralel çalışan minor Garbage Collection algoritması, tekil threadle işini gören minor Garbage Collection ile teoride aynı yapıdadır. Aralarındaki tek fark, parelel minor Garbage Collection için birden fazla threadin çalışmasıdır. Bu şekilde stop the world duraklamaları daha kısaltılmış olur. Bu uygulamanın kullanıcıya karşı cevapkanlık oranını artırmaktadır.

Paralel minor Garbage Collection nasıl çalışmaktadır? Garbage Collector’ün temizleme işlemine hayatta kalan nesneleri işaretleyerek (mark) başladığını yazmıştım. Garbage Collector bu amaçla kök setinde yer alan nesneleri tarar ve bu nesnelerden yola çıkarak işaretleme işlemini yapar. Akabinde hayatta kalan tüm nesneleri aktif olan Survivor alanına kopyalar (copy). Paralel Minor Garbage Collection için kök setinde yer alan nesneler birden fazla Garbage Collection threadine atanır. Birden fazla thread paralel olarak kök setindeki bir nesneden yola çıkarak hayatta kalan nesneleri tararlar. Bu şekilde işaretleme performansı artırılır ve işaretleme için harcanan zaman azalır.

Hayatta kalan nesnelerin aktif olan Survivor alanına da kopyalanma işlemi buna benzer bir şekilde gerçekleşir. Her threade Survivor hafıza alanında PLAB (PLAB – Parallel Local Alocation Buffer) ismi verilen bir alan atanır. Garbage Collection threadleri birbirlerinden bağımsız olarak keşfettikleri ve hayatta kalmış olan nesneleri kendi PLAB alanlarına kopyalarlar.

Paralel Garbage Collection paralel çalışan threadlere rağmen dünyayı durduran bir algoritmadır. Tekil threadle çalışan Garbage Collection algoritmasına göre daha hızlı çalışır ve uygulamanın durma zamanlarını kısaltır. Birden fazla işlemcisi (CPU – Central Processing Unit) olan bir sunucu üzerinde paralel Garbage Collection algoritmasını kullanmak bu kazancı getirir. Lakin sadece bir işlemcisi olan sunucularda paralel Garbage Collection’ın kullanılması tam tersi bir etki yaratır.

Yazımın ikinci bölümünde major Garbage Collection’ın nasıl çalıştığını inceleyeceğim.

EOF (End Of Fun)
Özcan Acar
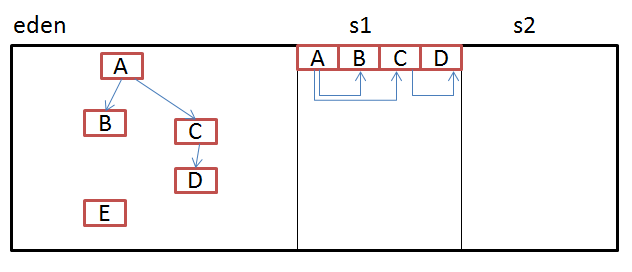
Matrix’de Yaşayan Programcılar

Hemen hemen her programcının Matrix filmini seyrettiğini düşünüyorum. Star Wars gibi Matrix filmi de biz yazılımcılar için bir kült. Biraz abartı da olsa fikir olarak çok enteresan, en azından bir yazılımcı için. Matrix’de kullanılan yazılım sistemi dikkat çekiyor. En çok ilgimi çeken dejavü olarak isimlendirilen yazılım hataları (bug) ve Neo’nun bir tren istasyonunda hapis kalması ve trene binmesine rağmen tekrar tekrar aynı istasyona geri dönmesi, yani bir nevi for döngüsü olmuştur. Bir for döngüsünün bu kadar güzel görselleştirilmesi beni çok etkilemişti. Böyle bir sistemin entegrasyon testleri nasıl yapılıyor acaba? Okumaya devam et →