Eksik Gereksinim Analizleri ve Neticeleri

Bir yazılım ürününün kontrollü ve istenilen nitelikte ortaya çıkabilmesi için gereksinim analizi yapılması gerekmektedir. Gereksinim analizi kısaca müşterinin piyasa koşullarından doğan gereksinimlerinin tespit edilmesidir. Bu analiz müşteri ne ister sorusunun cevabını vermelidir. Aksi taktirde müşterinin ihtiyacı olmayan bir ürün ortaya çıkma riski oluşabilir. Bu yazımda bu tür gereksinim analizlerinin doğru yapılmadığı durumlarda doğabilecek sıkıntılardan bahsetmek istiyorum.

Günümüz projelerinde Jira vari sistemler kullanılarak müşteri gereksinimleri kullanıcı hikayeleri (user story) olarak kanban board üzerinde sprint backlog ya da genel backlog içinde yer alırlar. Bu kullanıcı hikayeleri müşteri ile yapılan görüşmeler sonunda tespit edilen gereksinimlerin kağıda dökülmüş halleridir. Bir kullanıcı hikayesi sonuç itibarı ile uygulama bünyesinde oluşturulması istenen bir özelliğin kısa bir özetidir. Örneğin “kullanıcı isim ve şifresini kullanarak, sisteme giriş yapar” bir kullanıcı hikayesidir. Yazılımcılar plannıng poker oturumlarında bu tür kullanıcı hikayelerinin hangi zaman diliminde implemente edilebileceklerini tahmin etmeye çalışırlar. Genelde story point olarak tabir edilen bir derecelendirme yöntemi ile tahminler yapılır. Herkesin bildiği gibi bu tahminler aslında gerçekleri yansıtmaz, lakin proje yönetimi nedendir bilinmez bu tahminlerin yapılmasında ısrar eder.

Bir kullanıcı hikayesinin içeriği yanı sıra onay/kabul kriterlerinin de (acceptance criteria) tanımlanmış olması önem taşımaktadır. Şahsen onay/kabul kriteri tanımlanmamış bir kullanıcı hikayesine elimi bile sürmezdim, çünkü hangi kriterlere göre daha sonra bu kullanıcı hikayesinin çalışır halde olduğunu ispatlayabilirdim! Bu mümkün değil. Bu sebepten dolayı kullanıcı hikayesini oluşturan kişinin, bu genelde gereksnim analizi yapan ürün sahibi (product owner) olabilir onay/kabul kriterlerini de eklemesi gerekmektedir. Yukarıdaki örnek kullanıcı hikayesinin onay/kabul kriterleri şu şekilde olabilir:

  • Kullanıcı ismi ya da sifresi yanlış ise, kullanıcıya “Lütfen doğru bilgiler ile giriş yapınız” hatası gösterilir.
  • Kullanıcı ismi alanı boş bırakılarak, login butonuna tıklandı ise, kullanıcıya “Lütfen kullanıcı ismini giriniz” hatası gösterilir.
  • Şifre alanı boş bırakılarak, login butonuna tıklandı ise, kullanıcıya “Lütfen şifrenizi giriniz” hatası gösterilir.
  • Kullanıcı ismi ve şifre doğru ise, login işlemi gerçekleştirilir ve kullanıcı ana sayfaya yönlendirilir.

Yazılımcı oluşturacağı implementasyonu bu onay/kabul kriterleri doğrultusunda şekillendirir. Burada ATDD (acceptance test driven development) tam da onay/kabul kriterlerine karşılık gelen bir implementasyonun oluşmasını sağlayacaktır. Bu implementasyon ne bir eksiklik ne de bir fazlalık ihtiva edecektir. Genellikle yazılımcı test güdümlü çalışmadığında “belki kullanılır, su metot da olsun” eğilimi ile fazladan kod yazabilir. Test güdümlü yazılımda oluşturulan kullanıcı ve program arayüzünin (APİ – application programming ınterface) ilk kullanıcısı testler olduğu için, yazılımcı bu api arkasında sadece gerekli ve yeterli olan implementasyonu oluşturarak, ilerleyecektir.

Buraya kadar kabaca gereksinim analizinin nasıl bir kullanıcı hikayesine, oradan da koda dönüşebileceğine değindik. Sonuç itibarı ile gereksinim analizinden doğan kullanıcı hikayeleri ürün sahibi (product owner) ile yazılımcı ekibi arasındaki kontratı temsil etmektedirler. Ürün sahibi ne istediğini (bunlar müşterinin istekleri ve gereksinimleridir) kullanıcı hikayeleri olarak formalleştirir ve yazılım ekibine implemente edilmek üzere devreder. Yukarda bahsettiğim kullanıcı hikayesi çok basit bir örnek, bu yüzden büyük çapta arzu edilmeyen bir şeylerin implemente edilme olasılığı çok düşük. Ayrıca onay/kabul kriterleri de tanımlı olduğundan, yazılımcı bu kriterler doğrultusunda çok hızlı bir şekilde gerekli implementasyonu oluşturabilir. Şimdi daha büyük çaplı ve karmaşık kullanıcı hikayelerinin oluşturulmasında bir takım hatalar yapılması durumunda, oluşabilecek problemlere değinmek istiyorum.

Bizden gerekli verilerin yüzlerce kolonu olan bir excel dosyası olarak export edilmesinin istendiğini düşünelim. Böyle bir kullanıcı hikayesinde yazılımcının görmek istediği ilk şey hangi verinin hangi kolondo yer alacak oluşudur. Bu amaçla ürün sahibinin böyle bir mapping oluşturarak, kullanıcı hikayesine eklediğini varsayalım. Onay/kabul kriteri olarak da “kullanıcı export butonuna tıklayınca, veriler excel dosyası olarak indirilir” tanımlı olsun. Şimdi bu örnek üzerinden nelerin yanlış gidebileceğine yakından göz atalım.

Daha önce 200+ kolonu olan bir excel dosyası oluşturdunuz mu bilmiyorum, lakin çok eğlenceli bir uğraş değil. Ana problemlerden birisi verilerin nereden geleceğini tespit etmektedir. Bu ürün sahibinin görevidir ve hangi verilerin nereden alınacağını oluşturacağı mapping bünyesinde tanımlar. Bunun yanı sıra bu verilerin hangi kolona yerleştirileceği bilgisi de bu mapping bünyesinde yer almak zorundadır. Şimdi biz haftalar süren çalışmalar sonunda export özelliğini çalışır hale getirmiş olalım ve uygulama bu yeni özelliği ile müşteriye/kullanıcılara yeni bir sürüm bünyesinde sunulmuş olsun. Kullanıcılar doğal olarak bu özelliği kullanarak, ilk excel dosyalarını oluşturacaklar ve bize ulaşan bilgilere göre export özelliği istedikleri verileri ihtiva etmeyecek. Durum bir bug olarak tekrar bize iletiliyor ve hatayı girememiz talep ediliyor.

Ortada gerçekten bir hata var mı? Ben böyle bir durumu daha önce yaptığım bir projede yaşadım ve bundan sonra olanları aktararak, nelerin yanlış yapıldığına değinmek istiyorum, çünkü yazılımcı ekibi gereksinimi doğru implemente etmemekle suçlandı. Bakalım suçlu kim!

Öncelikle amaç hiçbir zaman suçlu aramak olmamalıdır. Bu zayıf insanların işidir ve kesinlikle böyle süreçlere dahil olmamak gerekir. Bunun yerine sürecin neresinde hata yapıldı ve bu hatanın bedeli ne oldu sorusuna cevap aranması gerekmektedir. Sonucu biliyoruz, ama buraya nasıl gelindi?

Tekrar kullanıcı hikayesine bir göz atalım. Bu kullanıcı hikayesi bünyesinde 200+ kolon ihtiva eden bir mapping tablosu mevcut. Bize iletilen bugda belli kolonlarda verilerin eksik olduğu bilgisi mevcut. Tekrar kullanıcı hikayesindeki mapping tablosuna baktığımızda boş kalan kolonların nedenini görebiliyoruz: bu kolonlar için sadece belli tipte bir veri tanımlanmış (Drugtype.MIXTIRE ) ve yapılan export işlemi diğer tiplerdeki verileri (örneğin DIVISION) ihtiva etmiyor ve göz ardı ediyor. Aşağıda bu mapping tablosunda yer alan 44. ve 45. satırları görmekteyiz. 44 ve akabinde bu gruba dahil kolonlarda MIXTIRE türünde verilerin kullanılması gerektiğinden bahsediliyor. Gelen bug raporunda ise MIXTIRE harici diğer verilerin excel dosyasında yer almadığından bahsediliyor.

Verilerin hangi yapıda olduklarını anlamak için aşağıdaki enum sınıfına bir göz atalım:

public enüm DrugType{
MIXTIRE,
DIVISION,
COMPLETED_PRODUCTS,
DIVIDED_PRODUCTS
}

Kullanıcı hikayesinde sadece MIXTIRE tipinde olan verilerin export edileceğinden bahsediliyor. Bu durumda yazılımcı kullanıcı hikayesinde yer alan veriler doğrultusunda gerekli implementasyonu gerçekleştirmiştir. Ama kullanıcılar DIVISION ya da başka tipte olan verileri de export etmeye çalıştıklarında, gerekli kolonlar boş kalmaktadır.

Ürün sahibi ile yaptığımız bir kriz toplantısında bize bunun bir bug olduğunu ve diğer tipteki verilerin de export edilmesi gerektiğini söyledi. Hemen şunu belirteyim: ortada bir bug yok! Bu bir change request, çünkü kullanıcı hikayesinde ne yer alıyorsa, yazılımcı ekibi onu implemente etmiştir. Bunu bu şekilde ürün sahibine aktardığımızda, “ben refinement toplantılarında bunu sözlü olarak söylemiştim” cevabını aldık. Ürün sahibi ne yazık ki kusura bakmasın! Kullanıcı hikayesinde ne yazıyorsa, gerçek o dur ve yazılımcı ona göre hareket eder. Bir takım toplantılar esnasında konuşulanlar eğer kullanıcı hikayelerine not düşülmesse, geçerlilikleri yoktur. Bu yüzden ürün sahibinin böyle bir argüman ile gelmesi kabul edilemez. Eğer bir kullanıcı hikayesi ürün sahibi ile yazılım ekibi arasında bir kontrat vazifesi rolünü üstlenerekse, bu durumda gerekli bütün bilgilerin kullanıcı hikayesi bünyesinde yazılı olarak yer alması gerekmektedir.

Ben çoğu zaman bir kullanıcı hikayesini implemente eden bir yazılımcının gördüğü eksikleri kullanıcı hikayesine not düşmeden ürün sahibi ya da diğer yazılımcılar ile bilateral çözmeye çalıştığına şahit oluyorum. Bu çok tehlikeli bir durum arz etmektedir. Eğer bir eksik varsa ve bunun ne olduğu tespit edilmişse, hiç zaman kaybetmeden kullanıcı hikayesine gerekli not düşülmeli ve kontrat yenilenerek, yapılması gerekenler somutlaştırılmalıdır. Oluşturulan implementasyonun garantisi her zaman bu kontrattır.

Bahsetmiş olduğum export konusundaki ana problem analizi yapan şahsın ya da ürün sahibinin export için gerekli olan analizi geniş kapsamlı yapmamış olmasıdır. Oluşturması gereken mapping tablosunun daha kapsamlı olması gerekiyordu. Bunun yanı sıra ürün sahibi oluşturulan bu yeni özelliği test ederek, kabul etmiştir. Yani en geç test esnasında bu hatanın göze batması gerekirdi, lakin böyle bir şey olmadı.

Yazılımcı olarak kendimizi sadece onay/kabul kriterlerini baz alarak gerekli implementasyonu yaptığımızda garantiye alabiliriz. Bu yüzden mutlaka ve mutlaka onay/kabul kriterlerinin kullanılması gerekliliği DOR (definition of ready) bünyesinde tanımlı olmalıdır.

Kısaca özetleyecek olursak:

  • Her bug olarak gelen repor bir bug olmayabilir. Çoğu zaman bu bir change requestdir ve gereksinim analizi yapan ekip işini doğru yapmadığı için bu eksikliği etrafına bug olarak lanse edebilir.
  • Yazılımcılar önlerine gelen her kullanıcı hikayesini içerik olarak doğru olup, olmadığını sorgulamalıdırlar. Eğer eksik olduğunu düşündükleri noktalar varsa, kullanıcı hikayesini reddetme hakkına sahiptirler. Ürün sahibi tespit edilen eksiklikleri tamamlamakla yükümlüdür.
  • Toplantılarda sözlü olarak yapılan tespitler mutlaka kullanıcı hikayelerine not düşülmelidirler. Bu şekilde kontrat yenilenir ve bu bilgiler göz ardı edilmez.
  • Yazılımcılar onay/kabul kriteri olmayan kullanıcı hikayelerini reddetme hakkına sahiptirler. Onay/kabul kriteri olmayan kullanıcı hikayeleri saatli bomba gibidirler. İmplementasyonun kullanıcının elinde patlama ihtimalleri çok yüksektir.
  • Ürün sahibi tanımladığı onay/kabul kriterlerini elden yaptığı testler aracılığı ile kontrol eder. Yazılımcı her onay/kabul kriteri için bir onay/kabul testi yazar. Bu testleri otomatik olarak çalışır ve kullanıcı hikayesinde yer alan uygulama özelliğinin çalışır durumda olduğunun kanıtıdırlar.
  • DOR bünyesinde yer alan kriterlere uymayan kullanıcı hikayeleri yazılım ekibi tarafından sahibine geri gönderilir.
  • DOD (definition of done) bünyesinde yer alan kriterlere uygmayan kullanıcı hikayesi implementasyonları ürün sahibi tarafından yazılım ekibine geri gönderilir.

EOF (End Of Fun)
Özcan Acar

Sekiz Milyar Değişik İşletim Sistemi

Son zamanlarda alışkanlıkların oluşumu, etkileri ve yapıları hakkında bilgi edinme ve uygulama fırsatım oldu. Bir yazılımcı olarak insan vücudunu donanım, kişiliğini oluşturan tüm davranış biçimlerini ve diğer yetilerini yazılım olarak gördüğüm için alışkanlıkları da bu pencereden incelediğim bu yazıyı kaleme almaya çalıştım.

Kısaca bir alışkanlığın ne olduğunu ve anatomisini inceleyelim. Bir alışkanlık beyin tarafından otomatize edilmiş bir rutindir. Alışkanlık çalışır durumda iken beyin herhangi bir kaynağını bu rutini koşturmak için aktif olarak kullanmaz. Bu rutin otomatik olarak çalışır ve bu esnada beyin başka işler ile meşgul olabilir. Beynin rutinleri oluşturmasındaki ana amaç zaten budur. Beyin alışkanlığı oluşturan adımları bilir ve onların otomatik olarak bir rutin çerçevesinde bilinçli bir şekilde dahil olmadan koşturulmasını sağlar. Bu şekilde beyin işlemci çekirdeklerine fazla yükleme yapmadan paralel birkaç işle meşgul olabilir.

Benim için bir alışkanlık sahip olduğumuz donanım üzerindeki işletim sistemi bünyesinde koşturulan bir background taşk gibi bir şey. İşletim sistemimiz cronjob calıştırır gibi gerekli durumlarda bir alışkanlığı da koşturabilmektedir. Kısaca bir alışkanlığı işletim sisteminde çalışan bir app olarak düşünelim.

Kabaca bir alışkanlığın ne olduğunu tanımladıktan sonra anatomisine bir göz atalım. Bunu anlamak için bir alışkanlığın nasıl oluştuğunu incelememiz gerekiyor. James Clear’ın Atomic Habits isimli kitabında bir alışkanlığın oluşabilmesi için bu dört adımın arka arkaya atılması gerektiğini belirtiyor: tetikleyici neden, istek-arzu, işlem ve ödüllendirme. Eğer bu dört adım dopamin salgılanması (ödüllendirme) ile son buluyorsa, beyin tarafından bir alışkanlığa dönüştürülmesi çok olası, çünkü beyin, içinde dopamin olan her şeyle çok ilgili ve bunu sağlamak için gerekli rutinleri oluşturma konusunda çok istekli. Bunu bir örnek üzerinde inceleyelim. Spor yapmak bir alışkanlık haline dönüşmüş olabilir, çünkü spor aktivitesinin bitimi ile vücut dopamin salgılar ve bu dopamin spor aktivitesinin beyin tarafından bir rutin haline dönüştürülmesini kolaylaştırır. Nitekim spor yapanlar bu aktiviteyi gerçekleştirmediklerinde mutsuz olurlar ve her fırsatı spor yaparak değerlendirirler. Kısaca alışkanlık bir bağımlılığa dönüşmüştür. Aynı şey sigara içenler için de geçerlidir.

Peki ama bir alışkanlık durup, dururken nasıl aktif yani app olarak işletim sistemimizin belleğinde çalışır hale gelir? Bunun için şahsın tetikleyici bir neden ile uyarılması gerekiyor. Örneğin sigara içen birisi için sigara paketini görmesi alışkanlığı aktif hale getirmek için tetikleyi bir nedendir. Aynı şekilde sabah yürüyüşlerini alışkanlık haline getirmiş birisi için spor ayakkabılarını görmesi tetikleyici bir nedendir. Kısaca tetikleyici neden mevcut değilse, alışkanlık app olarak çalışamaz. Eğer kötü alışkanlıklarımızdan kurtulmak istiyorsak, tetikleyici nedenleri gözümüzün önünden almamız yeterli olacaktır. Bu ama sigara içmek gibi ağır bağımlılıklar için ne kadar geçerli olur, tartışılır. Benim bahsettiğim alışkanlıklar daha ziyada yüksek bağımlılık ihtiva etmeyen günlük rutinlerdir.

İnsanlar aynı donanıma sahip olmalarına rağmen, sahip oldukları işletim sistemi değişiklik göstermektedir. Bu sebepten dolayı sekiz milyar değişik işletim sistemi gibi bir başlık kullandım. Kanımca bu gezegende insan sayısı kadar işletim sistemi türü mevcuttur. İşletim sistemimiz ve bununla birlikte sahip olduğumuz tüm yazılım sisteminin temeli doğumla atılır. Aile ve toplumun yapısı sahip olduğumuz işletim sistemini modeller. Burada beynimizin yapısını dikkate alarak işletim sisteminin bir çekirdek (ilkel beyin) ve modüllerden (gelişmiş üst beyin) oluştuğunu düşünebiliriz. Beynimizin çekirdeği bizim kontrolümüzde olmayan, evrim sürecinde oluşturulmuş ve hayatta kalabilmek için faydalı olduğu görülmüş rutinler ihtiva etmektedir. Bunun en güzel örneği bir tehlike anında kaçma hissi, düşünmeden nefes alıp, verme, gözlerimizi kırpa ya da karanlıkta korkma halidir. İnsanın bilinçli olarak bu rutinlere müdehale etmesi, onları değiştirmesi çok mümkün değildir. Bunları işletim sisteminde çalışan arka olan appler olarak düşünebiliriz.

İşletim sistemimizin çekirdeğini düşündüğümüz zaman aslında bu gezegende yaşayan herkesin bu konuda bir farklılık göstermediğini görebilmekteyiz. Her insan bu seviyede aynı rutinlere ve bu açıdan aynı işletim sistemine sahiptir. İşletim sistemlerini ayrı kılan çekirdeği değil, üst beyini şekillendiren modüllerdir. Bu modüller insanı diğerlerinde ayrı kılan zihin, zihniyet, empati, kültür, eğitim, vicdan, arzu gibi yapılarla şekillendirilir ve her insanda farklılık gösterirler. Bu da her insanın işletim sisteminin başka bir yapıda olmasını beraberinde getirir.

Her yeni alışkanlık ile işletim sistemi daha zengin bir hale gelir. Burada ilk etapta alışkanlığın iyi ya da kötü olarak ayrılması önem taşımamaktadır. Önemli olan işletim sisteminin yeni appler ile güncellenmesidir. Nitekim kişisel gelişim penceresinden durumu değerlendirdiğimizde bilinçli olarak kazanılan alışkanlıkların insanı bir üst seviyeye taşıdığını söyleyebiliriz. Örneğin her gün yirmi kitap sayfası okuma alışkanlığı bir sene sonra otuz kitap okumuş ve kişisel gelişim olarak bambaşka bir yere evrilmiş yeni bir birey doğuracaktır. Kitap okuma alışkanlığı ile işletim sistemi yepyeni bir boyuta taşınmakta ve muazzam bir gelişime sahne olmaktadır. Bu açıdan bakıldığında insanların sahip oldukları işletim sistemlerini eşsiz kılan kişisel gelişim için bilinçli olarak geliştirilen alışkanlıklardır.

Yazılım böyle bir şey. İstediğinizi yapabilirsiniz. Aynı şey sahip olduğumuz işletim sistemleri için de geçerlidir. Bir sene sonra nerede ve kim olacağımıza sahip olduğumuz işletim sistemi değil, alışkanlıklarımız karar vermektedir. Küçük rutinler olarak başlayan yeni alışkanlıklar işletim sistemlerimizi güncellerken belli bir zaman diliminden sonra bizleri düşünülmesi bile zor yerlere taşıyabilirler. Bu yüzden işletim sistemlerimizin sürekli güncellenmesi gerekmektedir. Bunun kararını sadece ve sadece bilinçli alışkanlıklar oluşturacak olan birey kendisi verebilir.

Buradan çıkartabileceğimiz sonuç kişisel gelişim için alışkanlıklar geliştirmemiz gerektiğidir. Kişisel gelişim süreklilik ister, bunun da alışkanlıkların doğasında yer alan otomatizm ile daha kolay üstesinden gelebiliriz.


EOF (End Of Fun)
Özcan Acar

Gitflow ve Verdiği Zararlar

Artık git ile çalışmayan kalmadı sanırım. Bilindiği üzere gitflow isminde bir çalışma modeli var. Bu modelde uzun ömürlü feature branchlar ve ihtiva ettikleri daha geniş kapsamlı commitler ile çalışılmakta. Bu yazımda sizlerle bu modelin dejavantajları ve sebep olduğu sorunlar ve zorunlulukklar hakkındaki fikirlerimi paylaşmak istiyorum.

İlk etapta bir feature branch bünyesinde çalışmak mantıklı bir opsiyon olarak görünebilir. Programcı mevcut master ya da develop branchdan “git checkout -b feature/my-feature-branch” ile bir feature branch oluşturur ve üstlendiği işi bu branch bünyesinde geliştirir. Bu süreç sonunda bir pull request yardımı ile feature branch bünyesindeki değişilik ekibe duyurulur ve code review yapılması sağlanır. Bu işlem sonunda feature branch bünyesindeki yeni kodun kaynağa geri dönmesi amacıyla trunk olarak tabir edilen master ya da develop ile merge edilir. Bu işlem gerçekleştiği anda trunk sürekli entegrasyon dahilinda build ve deploy edilir.

Şimdi bu süreçde neler olduğuna ve ne gibi sorunların doğduğuna bir göz atalım. Öncelikle feature branch oluşumu gerçekten (reality) kopuş ve izolasyona girmek anlamına gelmektedir. Yazılımcı kendisini feature branch oluşturuğu andan itibaren öncelikle sürekli entegrasyon sürecinin dışına almaktadır. Sürekli entegrasyon uygulamanın her daim tüm değişikliklerle derlenebilir, deploy edilebilir ve test edilebilir olmasını sağlamaktadır. Sürekli entegrasyon trunk dahilinde yapıldığı taktirde tüm ekibin yaptığı değişiklikleri entegre edebilir. Feature branch bünyesinde çalışan bir yazılımcının yaptığı değişiklikler feature branch içinde kalındığı sürece sürekli entegre edilmez ve bu şekilde yazılımcı feature branch bünyesinde izolasyona mahkum kalır. Burada trunk ile rebase yapılması hiçbir şey ifade etmez, çünkü yazılımcının rebase ile trunkdan aldığı değişiklikler sürekli entegrasyondaki kaliteyi sağlamaz, yani rebase sürekli entegrasyonun yerini alamaz.

Feature branch bünyesindeki commit sayısı ve commitlerin hacimleri daha büyüktür. Yazılımcı trunk bünyesindeki gelişmelere bakmak zorunda kalmadan rahat bir şekilde kendi işi üzerinde çalışmaya devam eder. Bu haftaları alan bir sürece dönüşebilir. İki haftadan fazla bir gelişmeyi ihtiva eden feature branchı tekrar trunk ile merge etmek çok zor bir hal alabilir ya da mümkün değildir. Bu kod bazında da entegrasyonun sekteye uğradığı anlamına gelmektedir ve bu projeyi sıkıntı ve rizikoya solabilecek bir durumdur.

Diğer bir sorun ise feature branch modelinin feature branch deployment zorunluluğu doğuruabilmesidir. Yazılımcı feature branch bünyesinde çalıştığı sürece bir paralel evrende yaşar ve projenin sürekli entegrasyon ve sürekli deployment gibi nimetlerinden faydalanamaz. Sürekli deployment ile uygulama ihtiva ettiği tüm özellikleri ile tanımlı bir ortamda çalışır hale getirilmektedir. Feature branchın trunka dönmediği sürece ne oranda entegre ve deploy edilebilir olduğu muammadır. Bazı şartlar altında feature branch bünyesinde yapılan değişikliklerin test edilebilmesi için dev ortamına deploy edilmesini gerektirebilir. Örneğin milyonlarda kafka mesajını lokalde işleyemeyen (kapasite eksikliği, işlemin uzun sürmesi ya da gerekli veritabanı ya da kafka altyapısına erişimin lokalde olmaması) bir fetaure branch test edilmek amacıyla dev ortamına taşınmak zorunda kalınacaktır. Bu feature branch deployment anlamına gelmektedir. Böyle bir yapıdaki en büyük problem yine diğer değişikliklerle entegre olmamış bir yapının kendi izolasyonu bünyesinde deploy edilip, test edilmesidir. Tam entegre olmamış bir uygulamanin bu şekilde test edilmesi hiçbir şey ifade etmemektedir, çünkü entegratif bir yapı ile oluşması mümkün yan etkilerin ortaya çıkma şansı bulunmamaktadır. Bunun yanı sıra feature branch deploy edildikten sonra yazılımcı sadece kendi bölümüne konsantre olduğu için diğer bölümler test edilemeyecek ve yine oluşması mümkün yan etkilerin ortaya çıkması engellenmiş olacaktır.

Gitflow sürekli entegrasyon ve sürekli deployment önünde büyük engel oluşturmakta ve paralel evrenlerin oluşmasını teşvik etmektedir. Feature branch ile çalışmak yazılımcıya güven verebilir. Buradaki ana niyet değişikliklerin izole bir şekilde uygulamaya zarar vermeden yapılmasına alan tanımaktır. Lakin oluşan bu alan feature branch ile ın arasını açmakta ve entegrasyonun yapılmasını engellemektedir. Bu sebeple gitflow modeli ile çalışılması tavsiye edilmektedir.

Bunun yerine trunkbased calışmak, yapılan değişikliklerin meydan vereceği etkileri anında görmeyi mümkün kılacaktır. Bu geri bildirim uygulamanın hangi durumda olduğunu görmek ve gerekli tedbirlerin alınmasını kolaylaştıracaktır.


EOF (End Of Fun)
Özcan Acar

Çevik Süreçler Neden Dikiş Tutturamadı

Çevik süreçlerin tam olarak ne olduğunu kavramamış, çevik süreçler ile bir proje uygulamamış, scrum yaparak çevik olduğunu ve çevik süreçlerin bir işe yaramadığını zanneden şahısların “agile is dead” naralarını unutmadık. Ben de çevik süreçler öldü diyorum, lakin ekliyorum: “yaşasın çevik süreçler”. Çevik süreçlerin yıldızlarının bundan sonra nasıl parlayacaklarını ve tam anlamıyla yazılım geliştirme süreçlerine hakim olacaklarını kendi yazılımcı perspektifimden sizinle paylaşmaya çalışacağım.

Bir yazılım sistemi belli bir büyüklüğe ulaştıktan sonra, kendi dinamiklerini oluşturarak, yeni özellikler eklenmek suretiyle geliştirilmesini engeller hale gelir. Bunun başlıca sebebi, mevcut mimarinin yeni özellikleri taşıyacak yapıda olmamasıdır. Bunu bilen yazılımcılar iki nokta arasındaki en kısa mesafeyi seçmek yerine, en az dirençle karşılacakları patikayı yeğlerler. Bunun neye sebebiyet verdiğini çok iyi biliyoruz: teknik borç! Burada yazılımcının büyük oranda suçu olmadığını düşünüyorum. Daha ziyade yazılımdan bihaber yöneticiler zaman baskısı oluşturarak, işi aceleye getirmektedirler ve aslında başarısızlığın temelini ilk saniyeden itibaren atmaktadırlar. Bu duruma yazılımcılar tepki vermeyerek ve kimsenin etlisine, sütlüsüne karışmayarak ortak olmaktadırlar. Lakin şöyle yöneticilerin karşılarında ağız birliği yaparak, dik durabilseler ve “madem bu işi biz yapıyoruz, o zaman ne zaman biteceğine de biz karar veririz” diyebilseler, çok daha güzel işler ortaya koyabilecekler.

Yazılımda bu sorun ile başa çıkmanın tek bir yolu mevcut, o da refactoring olarak adlandırılan kodun yeniden yapılandırılmasıdır. Teoride her yazılımcının yeniden yapılandırmanın ne anlama geldiğini bildiğini düşünebiliriz. Lakin pratik açıdan baktığımızda, yeniden yapılandırma işleminin nasıl yapıldığı konusuna çok az sayıda yazılımcı hakimdir. Bunun da başlıca sebebi, yazılım testleri üzerinde olan hakimiyetsizliktir.

Refactoring tek başına yapılması mümkün olmayan bir işlemdir. Yapılan her değişiklik bir yan etki doğurabileceğinden, bu etkinin tespit edilebilmesi zaruridir. Bu kontrolü bir yazılımcının elden yapması mümkün değildir. Bu sebepten dolayı burada bir otomasyon ihtiyacı doğmaktadır. İhtiyaç duyulan kapsama alanına sahip olduğumuzu farz ettiğimizde, otomatik çalışan testler refactoring esnasında oluşan tüm yan etkileri tespit etmeyi mümkün kılacaklardır. Özetleyecek olursak, aslında yazılım sisteminin sürekli gelişimi için ihtiyaç duyduklarımız yeniden yapılandırma, test yazılımı ve test otomasyonudur. İşte çevik süreçlerin temelini de bunlar oluşturmaktadır. Eğer sürekli müşteri gereksinimlerini koda dökebiliyor ve mevcut sistemi genişletebiliyorsanız, çeviksiniz! aksi tektirde yazılımcılık oynuyorsunuz!

Çevik süreçler bünyesinde yer alan çevik metotların ana amacı yazılımda sürdürülebilirliği hedefliyor olmalarıdır. Burada sürdürülebilirlik terimini teknik açıdan ele almamız gerekmektedir. Sürdürülebilirlik bir yönetici için başka, bir yazılımcı için daha başka, bir patron için çok daha başka bir anlam ifade etmektedir. Ama doğru olan yaklaşım hangisidir? Şüphesiz herkes kendince doğru yaklaşım içindedir, çünkü beklentiler değişiktir. Lakin tekrar altını çizerek sormak istiyorum, teknik olarak sürdürülebilirlik ne anlama gelmektedir? Bunun cevabını verebilmek için öncelikle işin müşteri kısmını incelememiz gerekiyor.

Bir yazılım sistemi müşteri gereksinimleri doğrultusunda şekillenir. Yazılımcı olarak nihai amacımız, müşteri gereksinimlerini tatmin edecek bir sistem oraya koymaktır. Bu yüzden doğal olarak müşteriye kulak vermemiz ve ne istediğini iyi anlamamız gerekmektedir. Lakin müşteri ne istediğini tam olarak bilmekte midir? Ne yazık ki bu sorunun cevabı hayıdır. Burada yazılımcı olarak bizim için iki sıkıntı oluşmaktadır. Birincisi nasıl bir sistem oluşturmamız gerektiği sorusudur, ikincisi bu sistemin mimarisinin nasıl olması gerektiğidir. Bu iki sorunun da cevabını düşünerek, bulmamız mümkün değildir. O yüzden bir an önce kolları sıvıyarak, müşteriye yarım yamalak dile getirdiği gereksinimleri için kısa bir zaman dilimi sonunda bir şeyler göstermemiz gerekmektedir ki müşteri ne istediğine dair fikir üretmeye başlayabilsin. Bu yüzden çevik süreçlerde bir ya da iki haftalık iterasyonlar sonunda müşteriye mutlaka tespit edilen miktardaki özelliğin çalışır durumda olduğu sistemler sunulur. Bu prototipler müşteriden alınan geribildirimler doğrultusunda onun kullanacağı ürün olana kadar geliştirilir. Lakin burada tekrar sürdürülebilirlik konusuna değinmemiz gerekmektedir. Teknik olarak bu nasıl sağlanabilir? Bunun iki yöntemi mevcuttur: Teknik borç ve teslimiyet ya da kararlılık ile uygulanan “yap/boz” mentalitesi.

Eğer bir bina yapımı söz konusu ise, atılması gereken temelin ve uygulanmak istenen mimarinin bilinmesi gerekmektedir. Bu değişmez iki parametre yapılan binanın kaderidir. Eğer inşaat mühendisleri ve mimarlar yazılım yapmaya başlasalardı, hiç zorluk çekmeden bu işe adapte olabilirlerdi, çünkü günümüzde de yazılım bir bina inşaatı gibi ele alınmaktadır. Durum böyle olduğu için yazılım projelerinin çok büyük bir kısmı belli bir zaman sonra çıkmaza girerek, hem yazılım sistemini oluşturanları hem de müşterisini zorda bırakmaktadırlar.

Tekrar teknik sürdürülebilirlik sorusuna geri dönelim. Teknik sürdürüleiblirliğin bedeli ne yazık ki ağırdır. Öncelikle yazılımla uğraşan herkesin bu bedeli maddi ve manevi olarak ödemeye hazır olması gerekmektedir. Maddi açıdan baktığımızda yöneticilerin sürdürülebilirliği sağlamak adına daha fazla zamana ihtiyaç duyulduğunu ve bunun maliyeti artıracağını anlamaları, manevi açıdan baktığımızda yazılım mühendislerinin işin çıkmaza girdiğinde radikal kararlar vererek, refactoring teknikleri yöntemleri ile mevcudiyeti yeniden şekillendirme iradesine sahip olmaları gerektiğini görmekteyiz.

Günümüzde yapılan yazılımı yirmi sene önceki şekli ile kıyasladığımızda, aslında kafalarda fazla bir şeylerin değişmediğini görebilmekteyiz. Çoğu yazılım projesi yirmi sene önceki kafa yapısı (mindset) ile uygulanmaktadır. Yirmi sene önce aktif olarak hayatımıza giren çevik metotlar ihtiyaç duyulan dönüşümü sağlayamadılar. Bunun nedeni ne olabilir? Çevik süreçler performans gösterebilmek için çok radikal değişimlere ihtiyaç duymaktadırlar. Bu programcıların çalışma tarzlarından başlayarak, firmanın sahip olduğu yazılım geliştirme kültürüne kadar uzanana bir alanı kapsamaktadır.

Çevik süreçler programcı perspektifinden bakıldığında test güdümlü yazılım gibi radikal bir metodun uygulanmasını talep etmektedir. Yazılım birimlerini test etme konusunda pek kafa yormamış ve bu konuda tecrübesi olmayan bir yazılımcıdan test yazarak, yazılıma devam etmesini istemek, bir cobol yazılımcısına bugünden yarına nesne tabanlı program yazdırmaya çalışmak gibi birşeydir. Nitekim ikibinli yılların başlarında görev başında olan yazılımcıların bu fikri benimsemeleri mümkün olmadı. Onlar hep testlerin yazılımın en sonunda uygulanan bir aktivite olarak gördüler. Her zaman angarya olarak görülmüş test yazma olayının birden bire gündemin en başına oturarak, tüm gidişata yön verme fikrine o jenerasyon ne yazık ki adapte olamadı. Tekrar hatırlamakta fayda görüyorum. çevik olabilmeniz için yani müşteri gereksinimlerine her daim yazılım ile karşılık verebilmeniz için yeniden yapılandırma yapmak zorundasınız. Test olmadan yeniden yapılandırma yapılamaz. Bu yüzden çevik süreçlerin en temelinde bu iki prensip yatmaktadır: yeniden yapılandırma ve testler. Olay sadece test güdümlü yazılım ile bitmiyordu. Eşli programlama, sürekli entegatasyon, iterasyon bazlı yazılım gibi birçok çevik süreç metodu mevcut yazılım süreçlerini yer yer tersine çevirdiğinden dolayı, bu durum yazılımcılara sudan çıkmış balık hissi yaşatmakta ve adaptasyonu zorlaştırmaktaydı.

O dönemin yazılım sektöründe çalışanlarını şelale (waterfall) yazılım süreçlerinden geldiklerini unutmamamız gerekmektedir. O zamanın yazılım ekipleri müşteri gereksinimlerini en ince detayına kadar anladıktan ve kağıda döktükten sonra yazılım yapmaya başlarlardı. Burada bir senelik bir ön çalışma ve akabında yine birkaç sene sürebilen yazılım geliştirme sürecinden bahetmekteyiz. O gün olsun, bugün olsun yazılım projelerinin başarısız olmalarının ana sebeplerinden birisi ne yazık ki budur. Müşteri gereksinimleri doğrultusunda bir yazılım sistemine ihiyaç duyar. Müşterinin bu gereksinimleri piyasa şartları ile günlük bazda bile değişime uğrayabilirken, şelale yöntemleri ile birkaç sene kapalı kapılar arkasında yapılan yazılımın, bu zaman dilimi sonunda müşteri gereksinimlerine ne kadar az hitap edebilme potansiyeline sahip olduğunu görebilmekteyiz. Nitekim yazılım projelerindeki başarısızlık, müşteri gereksinimlerinin ne oranda karşılık göremediği ile çok yakından bağlantılı.

Hala ikibinli yılların başlarındayız ve çevik süreçlerin var olma savaşını yakından inceliyoruz. Şimdi o zamanlar yazılımın nasıl yapıldığını ve uygulanan mimarileri yakından inceleyerek, çevik süreçlerin neden tutunamadığını görmeye devam edelim.

İkibinli yılların başlarında Java programlama dili sahip olduğu ekosistemi ile tüm yazılım camiasına hakim olmaya başladı. O zamanlar EJB (Enterprise Java Beans) ile uygulama sunucularında yazılım yapanlar çok iyi hatırlayacaklardır. Tarih hep tekerrürden ibarettir, lakin umarım o günleri hiçbir yazılımcı tekrar yaşamak zorunda kalmaz. O devrin yazılım yöntemleri, araç ve gereçleri çevik süreçler için hazır değildi. Siz ne kadar iyi niyetli de olsanız ve test güdümlü yazılım ile birim testleri yazsanız bile, entegrasyon, onay/kabul testleri ve benzeri testlerin otomatik çalıştırılmaları onlarca ya da yüzlerce dakikanızı almaktaydı. Çok küçük bir değişilik yaptığınızı düşünün. Uygulamanın tekrar paketlenerek, uygulama sunucusunda çalışır hale gelmesi en az on dakikanıza mal olmaktaydı. Bunu çok defa yaşamış bir programcıyım. Çeviklik geribildirimle doğrudan orantılıdır. Yaptığınız şey size ne kadar hızlı geribildirim sağlarsa, o hızda değişilik yapabilirsiniz. Çevik olabilmek için yeniden yapılandırmamız gerekiyor. Bunun için testlerin sağladığı geribildirime ihtiyacımız var. Aynı şekilde sürekli entagrasyon yaparak, sistemin hangi derecede entegre olduğu geribildirimine ihtiyaç duymaktayız. Tüm çevik metotlar geribildirim prensibine dayanmaktadır. Geribildirim sağlanmadan, yaptığımız işin neresinde olduğunu anlamamız mümkün değildir. Geribildirim alma süresinin uzaması, bu o oranda çeviklikten uzaklaşma anlamına gelmektedir. Nitekim uygulama sunucularından kaynaklanan sebeplerden dolayı çok zaman alan test otomasyonu ilerleyebilmek adına devre dışı bırakılmak zorunda kalındı. O devrin EJB projelerine göz attığımız taktirde ya hiç ya da çok çok az oranda test koduna sahip olduğunu görebiliriz. Aynı durum bugün yapılan projeler için bile geçerlidir. Birçok güncel projede bir tane bile test metodu bulunmaması hiç şaşırtıcı değildir. Projelerin neden sürdürülebilir olmadıklarını ortadadır.

İkibin onlara kadar uygulanan yazılım prensip ve mimarileri de ne yazık ki çevik süreçler için gerekli ortamı oluşturamadı. Bahsetmiş olduğum zaman diliminde monolitler revaçtaydı. Durumun bugün bile değişik olduğu söylenemez. Trendin ama microservice mimarileri ile değiştiğine şahit olmaktayız. Peki bir monolit çevik süreçler ile geliştirilemez anlamına mı gelmektedir bu? Bu monolitin büyüklüğü ve bünyesinde barındırdığı kod kalitesi ile doğrudan ilişkili bir durum.

Çevik süreçler ile bir monoliti geliştirmek mümkün. Ama bu ne yazık ki belli bir büyüklüğe kadar sağlanabilir. O kritik büyüklüğe erişildikten sonra, sistemin küçük ve birbirinden bağımsız parçalardan oluşuyor ve geliştirilebiliyor olması gerekmektedir. Yani burada modüler bir yapıya ihtiyaç duyulmaktadır. Lakin bir monolit ne kadar modüler bir yapıda da olsa, tek bir parça olarak entegre edilmesi gerekmektedir. Burada yine test otomasyonu sorunları baş göstermektedir. Bunun yanı sıra entegrasyon süreleri uzamakta ve hızlıca yapılması gereken değişiklikler zaman almakta ve çeviklikten ne yazık ki ödün verilmesi zazuri bir hale gelmektedir. Tekrar hatırlayalım: hızlı bir şekilde geribildirim alınamayan ortamlarda çevik olunması imkansızdır.

Çevik bir yazılım ürünü yani her yeni müşteri gereksnimi ile yeniden yapılandırılabilen ve sürekli değişiklik ile başedebilen bir yazılım sistemi için belli başlı yazılım prensiplerinin, tasarım şablonlarının ve yazılım mimarilerinin uygulanması zaruridir. En basit hali ile clean code, solid prensipleri ve modüler bir mimariye ihtiyaç duyulmaktadır. Bunların uygulandığı bir proje test kültürü ile birleştiğinde her yeni müşteri gereksnimi ile hamur gibi yoğrulabilen yazılım ürünleri ortaya çıkamaktadır. Ama günümüzde bile birçok projede test kodunu bir yana bırakın clean code ya da solid prensiplerinden eser bile bulmak mümkün değildir. Testler olmadığından dolayı programcılar artık binlerce satırdan oluşan sınıfları değiştirmeye korkar olmuşlardır. Bu korkunun mevcut olduğu bir yerde nasıl yeni müşteri gereksinimleri hayat bulabilir?

Teknik açıdan baktığımızda, birçok sebepten dolayı çevik süreçlerin uygulanabilir olmadıklarını ve bu yüzden bir zaman sonra terk edildiklerini görebilmekteyiz. Lakin bunu tümüyle teknik sorunlarla ilişkilendirmek doğru değildir. Bunun yanı sıra firmalarda oluşan yazılım geliştirme kültürlerini ve organizasyonel yapıları da yakından incelememiz gerekmektedir.

Zaman içinde, çevik süreçlerin popülerliğinden de istifade edilerek benim fake agile olarak tabir ettiğim ve yazılımda çevikliği ima eden ama bunu sağlamaktan çok uzak sözde çevik süreçler oluştu. Bunların başında scrum geliyor. Scrum yakından incelendiğinde, aslında yakından, uzaktan çeviklik ile hiçbir alakası olmayan bir şey olduğu görülmektedir. Scrum ne çeviklik namına bir çevik metot ihtiva etmektedir ne de scrum ile çevik bir yazılım ürünü geliştirmek mümkündür. Çevik olmak için çevik metotlara ihtiyaç duyulmaktadır. Bunlar teknik anlamda yazılımcılar tarafından uygulanan metotlardır. Test güdümlü yazılım ya da eşli programlama gibi çevik metotları sadece yazılımcılar uygulayabilirler. Tüm çevik metotlar yazılımcılar için ve onların çevik hareket edebilmeleri için oluşturulmuşlardır. O yüzden çevik süreçler yardımı ile yazılım yapıyoruz denildiğinde, incelenmesi gereken nokta, çevik metotların ne oranda yazılımcılar tarafından yaşanıyor olduklarıdır.

Scrum ve benzeri yapılar ne yazık ki extreme programming gibi gerçek çevik metotların önüne geçtiler ve organizasyonlara çevik oldukları hissini verdiler. Kendini iyi hissetmekten öteye götüremeyen bu yaklaşımlar yazılım yapanların “çevik çalışıyor olmamıza rağmen, gerekli performansı alamıyoruz” söylenimlerine yol açtılar. Scrum ve benzeri yapılar ne yazık ki gerçek çevik süreçlerin adlarını karaladılar ve diskredite olmalarına sebep oldular. Bugün baktığınızda çevik olmayan bir yazılım ekibi bulamazsınız. Herkes scrum yapıyor ve herkes çevik. Ama ortaya çıkan yazılım ürünlerine göz attığımızda, hepsinin aynı dertlere sahip olduklarını ve aslında müşteri gereksnimlerine cevap veremeyecek yapıda, teknik ve mimarı açıdan tükenmiş olduklarını görmekteyiz.

Çevik süreçlerin önünü kapatan diğer bir durumda, yazılım ekiplerinin organizasyon yapısı olmuştur. Klasik bir yazılım ekibinde yazılımcı, testçi, analizci, sürümcü, proje yöneticisi gibi rolleri görmek mümkündür. Bir fabrika bandında üretim için uygun olan bu rol bazlı kadrolaşma, yazılım için ne yazık ki büyük sorular doğurmaktadır. Çevik süreçler yazılım, test, analiz, sürüm ve canlı işletme sorumluluğunu (production) yazılım ekibini oluşturan yazılımcılarda görmektedir. Yazılımcılar yazılım ile ilgili her şeyi yapamazlar mantığı doğru değildir. Mühendislik altyapısına sahip bu kişilerin günümüzde sadece kod yazmak için uygun olduklarını düşünmek en kibar ifadeyle onlara yapılan haksızlıktır. Nitekim Google tarafından uygulanan SRE (Site Reliability Engineering) ve DevOps gibi akımlara baktığımızda, yazılım ekibinin yazılım için gerekli tüm işlevleri yerine getirdiklerini görmekteyiz. Yazılımın, testin, analizin ve sürümün ayrı ekipler tarafından yapıldığı ortamlarda, çevik süreç faydalı olamamaktadır. Bu tür ayrıştırıcı organizasyonel yapılar olduğu sürece, çevik yazılım yapmak ne yazık ki mümkün değildir.

Yazılımda teknik sürdürülebilirlik için gerekli etkenleri ele almaya çalıştım. İsmi illa çevik süreç olmak zorunda değil. Lakin sürdürülebilirlik için atılması gereken somut adımlar var. Yazılımcının ana görevi sadece kod yazmak değildir. Mevcut organizasyonel yapılar bunun doğru olduğu fikrini savunsalar da teknik sürdürülebilirlik için yazılımcılara daha fazla sorumluluk verilmesi gerekmektedir. Yeni gereksinimlerin ivedilikle yazılım ürününe entegre edilebilmeleri için kodun her daim hamur gibi yoğrulabilmesi gerektirmektedir. Bunu sadece ve sadece yazılımcılar yapabilirler. Bunun için yüksek seviyede teknik beceriye ihiyaç duyulmaktadır. Bu da mühendisliğin hakkını verebilen yazılımcılarla mümkün olabilecek bir iştir.

Buraya kadar bahsetmiş olduğum nedenlerden dolayı çevik süreçler ne yazık ki hak ettikleri yere gelemediler ve haksız yere işe yaramaz damgasını gördüler. Ama ben bu durumun değişme sürecine girdiği düşüncesindeyim. Çevik süreçlerin işlemesini engelleyen unsurların yavaş yavaş kaybolmaya başladıklarına şahit olduğumuz bir dönemden geçiyoruz. Bu unsurlardan bazılarını yakından inceleyelim.

Artık günümüzde monolitlerin terk edilmeye yüz tutmuş bir mamarı türü olduğunu görmekteyiz. Modern yazılım sistemleri küçük ve birbirlerinden bağımsız çalışan modüllerden oluşmakta. Bunu sağlamak için microservice, webservice, rest ve soa gibi mimariler ve kubernetes, docker ve cloud gibi altyapı ve teknolojiler tercih edilmekte. Belli bir büyüklüğü geçmeyen ve otonom çalışan kod birimlerinin bakımı, geliştirilmesi, test edilmesi, sürümlenmesi ve işletilmesi geçmişe nazaran çok daha kolay.

Günümüzde yazılım ekiplerinin yapıları da değişmeye başladı. Örneğin Google bünyeside SRE olarak bilinen takımlar, test etmeden işletime kadar uygulamanın her yönüyle ilgileniyorlar. Birçok yeni ekip iki pizza prensibine göre oluşturuluyor. İki pizza ile doymayan bir ekip, büyüklüğü itibari ile monolite dönebilecek yapılar oluşturma eğilimi gösterebilmektedir. Küçük ekip ve tek sorumluluk prensibi kolay değiştirilebilir ve geliştirilebilir yazılım birimleri için sihirli bir formül haline geldi.

Bunun yanı sıra yazılımcılar eskiye nazaran tasarım prenbipleri, tasarım şablonları ve yazılım mimarileri konularında daha donanımlı hale geldiler. Clean code, software craftşman ve devops akımları, yazılımcıların teknik olarak daha da iyi olmaları için gerekli fikir ve pratikleri ihtiva ediyorlar. Ayrıca günümüzde eskiye kıyasla yazılımda teknik sürdürülebilirliği destekleyici, sonar, jenkins, git gibi birçok açık kaynaklı ürün bulmak mümkün.

Müşteri cephesinde de bazı değişiklilerin meydana geldiğini görmekteyiz. Müşteri eskisi gibi artık yıllar sonra kullanmaya başlayacağı bir yazılım ürünü siparişi vermek istemiyor. Müşteri bugün siparişini verdiği yazılım ürününün ilk sürümünü birkaç hafta sonra kullanmaya başlamak isteyebiliyor. Buna sadece çevik süreç ve iterasyon bazlı çalışma ile cevap vermek mümkün. Ayrıca müşteri için bir yazılım ürününün kullanılabilirlik seviyesi de değişmiş durumda. Piyasa rekabetinden doğan yeni gereksinimlerinden dolayı müşteri yıllarca beklemek yerine, sürekli geliştirilen, gereksinimler doğrultusunda adapte edilen ve her daim kullanılabliir yazılım ürünlerine yönelebiliyor.

Yirmi sene öncesi çevik süreçler ve tdd, bdd, pair programming, ci, refaçtoring, solid gibi çevik metotlar uygulanmaya başlandığında devir monolitlerin hakim olduğu mimarı devirdi . Çevik süreç ile bir monolit geliştirmek sadece iyi bir niyetten öteye gidemedi ve bu yüzden çevik süreçlerin bir işe yaramadığı düşünüldü. Oysaki container ve microservice dünyası için çevik süreç biçilmiş bir kaftan. Yıldızı söndüğü zannedilen çevik süreçler bulut bilişim ile ne olduklarını ispatlayacaklar.


Not: Eğer extreme programming gibi safkan bir çevik sürecin nasıl işlediğini merak ediyorsanız, size pratik agile isimli ücresiz kitabımı tavsiye etmek isterim. Çevik süreçler hakkındaki yazılarıma buradan, buradan ve buradan ulaşabilirsiniz.


EOF (End Of Fun)
Özcan Acar

Bilginin Evrimi

Yazılımda bilginin yarı ömrü ne yazık ki altı ayın altına düşmüş durumda. Yazılımcılar eskiye nazaran daha çok bilgi edinmek zorundalar. Bunda yazılımda soyutlamanın hızlanmasının büyük bir rolü mevcut. Soyutlama ve geldiğimiz noktayı bu yazımda kaleme almaya çalışmıştım.

Soyutlama işlemi bilginin evrimi için gerekli bir süreç. Evrimin olmadığı yerde gelişme olmaz. Evrim süreci bilginin geçerliliğini ispat etmekle mükellefken, soyutlama süreci de bilginin kullanıldığı anlamına gelmekte. İnsanlık var olduğu sürece, bu ilişki bilginin bir balon gibi şişip, sonsuzluğa doğru büyüyeceği anlamına geliyor, çünkü insanoğlu doğası gereği soyutlamadan yapamaz. Bu yüzden soyutlama işlemini bilgisel evrimin akaryakıtı olarak görebiliriz. Okumaya devam et →

Yazılım Dünyasının Hızlı Çözüm Üretmek İle Olan İmtihanı

Yazılım neden vardır sorusu sorulduğunda, benim aklıma gelen ve benim için en anlamlı cevap yazılımın müşterinin gereksinimlerini tatmin etmek için var olduğudur. Müşteri piyasa ihtiyaçlarından doğan gereksinimlerini tatmin etmek ya da piyasa rekabetinde avantaj sağlamak için yazılıma yönelir. Yazılım müşterinin piyasa şartlarında ayakta kalkmak için kullanacağı en kıymetli araç haline gelebilir. Sektörüne göre yazılım olmadan bir firmanın piyasa işlevini yerine getiremediğini, rakiplerine yenik düştüğünü ve yök olduğunu ya da yetersiz yazılım yüzünden yok olma riski ile karşılaştığına tanık olmak mümkündür.

Yazılımın artık çok kıymetli bir konumda olduğu konusunda hemfikir olduğumuzu düşünüyorum. Böyle bir ihtiyacın olması yazılım sektörünün temelini oluşturuyor. Firmalar ihtiyaçları doğrultusunda ya kendi yazılım takımlarını oluşturuyorlar ya da mevcut yazılım ürünlerini satın olarak bu konudaki ihiyaçlarını tatmin etmeye çalışıyorlar.

Burada yapı olarak çok değişik iki dünyanın karşı karşıya geldiğini görmekteyiz. Bir tarafta çok hızlı değişen piyasa koşulları neticesinde oluşan yeni müşteri gereksinimleri, diğer tarafta o kadar çok da hızlı müşteri gereksinimlerine adapte olmayan yazılım ürün/ürünleri. Müşteri bulunduğu piyasada önde gidebilmek için kullandığı yazılım ürününde hızlıca değişiklik yapılmasını talep edecektir. Lakin yazılımdaki en büyük problemlerden birinin bu noktada oluştuğuna tanık olmaktayız. Ne yazık ki kurumsal çerçevede geliştirilen yazılım ürünlerde istenilen değişikliklerin rekabetin önünü açacak hızda yapılamadığını görmekteyiz. Bunun başlıca sebebi yazılımda silolaşmaya gidilmesidir.

Günümüzde yazılım değişik vasıflara sahip grupların birlikte çalışarak yerine getirilen bir aktivitedir. Yazılımcılar kod yazmaktan, testçiler bu kodu test etmekten, oplar yazılan ve test edilen kodu canlıya almaktan sorumludur. Sadece bir önceki cümle içinde bile üç değişik meslek gurubunun adı geçti. Bunlara analizcileri, proje yöneticilerini ve ürün sahiplerini de eklersek, aslında çok değişik nitelikteki insanların bir araya gelerek, yazılım oluşturduklarını görmekteyiz. Ama bu gerçekten böyle olmak zorunda mıdır? Asıl sıkıntılar buradan kaynaklanıyor olabilir mi? Neden yazılım silolardan oluşan değişik ekiplerin elinden geçerek, oluşmak zorunda?

Yazılımla uğraşan herkes bilir. Yazılımcı ekibi yazdıkları kodun canlıya alınmasından, canlıyı (production) koruyup, kollayan op ya da admin ekibi de yazılımdan bihaberdir. Op ya da adminler her zaman canlının canlı kalması için ellerinden gelen her türlü işlemi yaparlar ve yeni yazılım ürünleri ya da mevcut yazılım ürünlerinin yeni sürümlerini canlıya almak için kırk dereden su getirirler. Onların uzun checklisteleri vardır. Bu listeler canlıyı korumak amacılıdır lakin hem yazılımcıları canlarından bezdirirler hem de değişikliklerin hızlıca canlıya alınmasını engellerler. Bu sadece op ya da adminlerle sınırlı bir durum değildir. Yazılıma yeni bir özelliğin eklenip, canlıya alınması aylar sürebilmektedir. İş ne yazık ki değişik silolarda çalışan değişik nitelikteki çalışanların tüm resmi göremeyerek, sadece kendi siloları bünyesindeki çalışmalara odaklanmalarından dolayı uzayaip gider.

Durumu kısaca özetleyecek olursak… Bir tarafta hzli değişeçen piyasa koşullarına adapta olmak isteyen müşteri ve yazılımdan olan beklentileri, diğer tarafta değişik silolarda organize olmaya çalışan ve yeterli hızda müşteri isteklerine cevap veremeyen yazılım ekipleri. Burada kaybeden kimdir? Her iki taraf da!

Yazılım sektörü ve camiası uzun bir süredir problemin farkında ve yer yer çözüm üretmeye çalışıyor. Bu çözümlerden birisi DevOps olarak bilinen akım. DevOps benim tanımıma göre yazılımı yapan, canlıda işleten ve her türlü yetki ve sorumluluğa sahip yazılımcıdır. Lakin yine bu konuda da işin sulandırılması sağlanmış ve yazılımcı ekibine gerekli tüm yetki ve sorumluluk verileceği yerde, op ve adminlerin biraz yazılımdan anlayacak ve gidişata destek olacak şekilde yeniden konuşlandırılması sağlanmış ve silo düşüncesine sağdık kalınması yeğlenmiştir. Hala hazırda birçok kurumsal altyapıda devopsları, testçileri ve yazılımcıları beraber çalışır durumda görmek mümkündür. Bir şekilde, yazılım sistemini oluşturan yazılımcıların aynı zamanda canlı için sorumluluk taşıyabilecekleri ve bu görevi yerine getirebilecekleri inancı hala oluşmamıştır. Bunun sebebi nedir?

Bunun başlıca sebebi yöneticilerin yazılımın nasıl işlediğinden bihaber olmaları ve yazılım için gerekli organizasyonel yapıyı oluştururken klasik kurumsal kadrolaşma ve iş yapma şablonlarından faydalanmalarıdır. Klasik organizasyonel yapılarda birileri bir ürünü oluşturur, birileri gerekli tasarımı yapar, birileri kalite konotrulünden sorumludur ve birileri de bu ürünleri pazarlar. Roller ve iş tanımları birbirlerinden keskin bir şekilde ayrıdır ve herkesin görevi detaylı olarak tanımlıdır. Lakin bir yazılım ürünü söz konusu olduğunda, ürünün pazarlanması haricinde gerekli tüm işlerin yazılımcılar tarafından yapılabileceğini söyleyebiliriz. Bunun en güzel örneğini Extreme Programming gibi gerçek çevik yazılım metotlarının uygulandığı projelerde görmek mümkündür. Böyle birçok projede yazılımcı olarak çalışmış birisi olarak söyleyebilirim ki gerçek bir çevik süreç içinde yazılımcılar her türlü sorumluluğu üstlenebilirler ve doğru olan zaten budur.

Klasik iş ayrımı verimliliği artırmak ve vasıf bazlı ücretlendirmeyi mümkün kılmak için kapitalizmin oluşturduğu bir prensiptir. Örneğin klasik bir fabrika üretiminde bant üzerinde oluşan ürün kademeli olarak değişik ellerden geçer. Ürünün oluşumuna katkı sağlayan her el belli bir vasfa sahiptir ve çok hızlı bir şekilde kendi üzerine düşen görevi yerine getirir. Eğer ürüne dokunan el gerekli vasfa sahip değilse, ürünün oluşturulma süreci uzar ve bu maliyeti artırır. Bu yüzden vasıflar silolar bünyesinde gruplaştırılır ve ürün üzerinde iş gücü olarak uygulanır. Seri şekilde üretim yapıldığı sürece bu tarz bir iş gücü organizasyonunun faydalı olduğunu söyleyebiliriz. Lakin nasıl bir ürünün ortaya çıkacağı belli olmayan durumlarda, bu silolaşma ne yazık ki iş koordinasyonu, bilgi ve vasıf yetersizliği ve tüm resmi görememe gibi durumlardan ötürü istenilen sonucun sağlanması konusunda yetersiz kalmaktadırlar. Bunun ispatını günümüzde uygulanan bilimum yazılım projelerinde görmek mümkündür.

Yazılım endüstrisinin yaptığı işten verim almak için ihtiyaç duyduduğu tüm araç, gereç ve metodolojiler gözünün önünde durmaktadır, lakin bunları kullanmak yerine nedendir bilinmez, iş gücünü silolaşmaya götürmekte inat etmektedir. Extreme Programming gibi çevik süreçler yazılımın nasıl yapılması gerektiği konusunda gerekli tüm metotları ihtiva etmektedirler lakin sahip oldukları inovasyon gücü göz ardı edilmektedir.

Çevik süreçlerde bilimum sorumluluk yazılım ekibindedir. Yazılım ekibi müşteriye kulak verir, gerekli yazılımı yapar ve çok kısa aralıklarla oluşan yazılım ürününü müşteriye gösterek, geri bildirim sağlar. Bu geri bildirim ile istikametini belirler. Kendisi yazar, kendisi test eder, kendisi canlıya alır ve kendisi hataları giderir. Google Site Reliability Engineering ismi altında bu prensibi uygulamaktadır. Google yazılım ürünlerinde bütün işi çekip, çeviren yazılımcılardan oluşan takımlardır.

Yazılım endüstrisi kör değil. O da gidişatın doğru olmadığının farkında ve DevOps gibi yerinde ama uygulanışı absürd olan yöntemler geliştirilmekte. Yazılımdan anlamayan sistem adminlerini birkaç günlük bulut eğitimlerine göndererek, onların DevOps olması sağlanamaz. DevOps ile kasıt, canlı ile arasında hiçbir engel kalmamış ve canlının sorumluluğnu da üstlenmiş, yani bu işi a dan z ye yapabilen yazılımcılardır. Bunu anlaması neden bu kadar zordur? Karşımızda bu işin üniversitede eğitimini almış ve her türlü mühendislik çözümü üretebilen yüksek vasıflı yazılım ve bilgisayar mühendisleri durmaktadır. Onları bir kenara koyup, “siz sadece kod yazın” demek, yaşadığımız sorumların başlıca nedenidir.


Özcan Acar
EOF (End Of Fun)

Yazılım Camiasından Son Gelişmeler ve Gidişat

Bilindiği üzere bilginin yarı ömrü yazılım sektörü için altı aylık bir zamanın bile altına düşmüş durumda. Teknolojiler ve trendler çok hızlı gelişiyor ve birçoğu yine bu hızda kayboluyor. Bu yazımda son zamanlarda yaşanan gelişmelere ve değişimlere değinmek istiyorum.

Yazıma yazılımda ustalık (software craftsmanship) konusu ile başlamak istiyorum. Bundan üç, dört sene önce akım haline gelmiş, uzun bir süre hypelanmış ama günümüzde artık unutulmaya yüz tutmuş bir akım. Ben bu konuda birçok yazı kaleme aldım. Arşivden bu yazılara ulaşabilirsiniz. Bu yazıların çoğunluğu yeniden yapılandırma, test ve çevik programlama üzerine. Yazılımda usta-çırak ilişkisini temel alan bu akım, yazılımın bir mühendislik disiplini değil, daha ziyada bir zanaat olduğu ve çırak olarak yola çıkıp, ustalardan bu işi öğrendikten sonra iyi bir yazılımcı olunabileceği kanısını savunmakta. İdeolojisi çevik programcılık ve yazılıma dayanan bu akımın amacı programcının yeniden yapılandırma ve test etme gibi yöntemlerle yazılım sistemini her zaman yoğrulabilir bir yapıda tutarak, müşteri gereksinimlerini her daim tatmin edici çözümler geliştirecek şekilde kendisini yetiştirmesini ve yazılımda ustalaşmasını sağlamak. Bunun için programcının çırak olarak yola çıkarak, ustalardan bu işi öğrenmesi ve kalfalık sürecinden sonra ustalaşması gerekiyor. Temelinde çevik yazılım prensipleri olduğu için bu akıma sempati duymuş birisi olarak, akımın neden son bulduğunu ya da yakında son bulacağına şu şekilde sıralamak mümkün:

  • Çırak olmak için ustayı bulmak gerekli. Yazılımda gerçekten ustalaşmış ve sahip olduğu bilgiyi paylaşmak isteyen çok az sayıda kişi mevcut. Ustası olmayan birisinin çırak olması mümkün değil. Bu durumda programcının kendi, kendisini yetiştirmesi gerekiyor. Durum böyle iken ustalaşma süreci uzayacaktır ya da gerekli bilgi ve tecrübeleri edinemediği için sekteye uğrayacaktır.
  • Yazılım sektöründe çalışan yazılımcıların birçoğu bilgisayar ya da yazılım mühendisi. Bir mühendis ya da mühendis olduğunu düşünen bir şahsa sanayideki gibi bir ustalık imajını satmak çok zor bir iş. Nitekim bu akımın sonunu getiren ya da getirecek olan ana unsur budur.
  • Ustalaşmak extreme programming gibi çevik süreçlerin ihtiva ettiği çevik yazılım metodolojilerine hakim olmak ve günlük iş hayatında uygulamak anlamına da geliyor. Çevik süreçler doğru anlaşılmadığı ve uygulanmadığı için yazılımda ustalaşma süreci sekteye uğramış durumda. Günümüz yazılımcısı test etme, yeniden yapılandırma ve sürekli entegrasyon gibi konuları angarya olarak görüyor, bu konuların bir yazılım sistemi için ne kadar önemli olduğunu önemsemiyor ve bu konuda kendisini geliştirmiyor.
  • Yazılım projelerinde programcıları kenara sıkıştıran ve verimli bir şekilde çalışmalarını engelleyen en önemli problem yapılan tahminler ve konulan bitiş tarihleri. Zamanın daraldığını gören yazılımcı kaliteden ödün vermeye başlıyor. Bunu en usta yazılımcı bile yapmak zorunda kalabiliyor. Buna karşı yazılımda ustalık akımının hiçbir reçetesi olmadığı için bu akımın gerçek hayatta uygulanması da zorlaşıyor.
  • Bazı programcıların gözünde yazılım sanat iken, başkalarına göre zanaat ya da bir mühendislik dalı. Yazılım sanat değildir. Sonuç itibarı ile şiir gibi kod yazma yeteneği geliştirilse bile, müşteri için önemli olan işlevdir. Müşteri kod okuyarak gereksinimlerini tatmin etmez. Gereksinimi tatmin eden işlevdir. Program yazarken zanaatten söz etmek mümkün, çünkü temiz kod yazmak çevik yazılım metotlarını da ihtiva ettiği için belirli bir ustalık gerektirmektedir. Bunun yanı sıra yeni çözümler üretmek bir mühendislik becerisidir. Yazılımda ustalık akımı yazılımı sadece zanaat olarak gördüğünden, bazı kesimlerce hiç kabul görmemiştir. Bu kesimler gerekli üniversite eğitimi ve pratik çalışmalarla yazılım yapmak için gerekli bilgi ve becerinin edinileceği fikrine sahiptirler.

Yazılımda ustalık akımından faydalanan ve ün yapan birkaç yazılımcı haricinde mahalledeki programcılarımız yine eskisi gibi paldır, küldür program yazmaya devam ediyorlar. Ne mutlu programcıyım diyene.

Güncelliğini yitirmeye yüz tutmuş diğer bir konu ise çevik yazılım. Ben kendimi bir çevik yazılımcı olarak tanımlıyor ve bu şekilde iş hayatımı sürdürmeye gayret gösteriyorum. Bu konuda birçok makaleyi kaleme aldım ve çevik süreçleri güncel olmaya başladıkları ilk günlerinden beri takip ediyor ve uyguluyorum. Son yirmi senelik zaman diliminde çevik yazılımın gelişim sürecini göz önünde bulundurduğumuzda, geldiğimiz nokta da çevikliğin her türlü derinliği kaybettiğini ve sadece proje yönetim metodoloji olarak algılandığını görebilmekteyiz. Bir scrum takımı bünyesinde her gün on beş dakika daily standup yapmayan programcı kalmadı sanırım bu gezegen üzerinde. İşin kötüsü, çoğunun bu yüzden çevik olduklarını düşünmeleri. Yapılacak bir şey yok. Kendisi okumayan, başkalarının anlatığı hikayelere inanmak durumunda.

Son zamanlarda iş ilanlarında programcı ünvanlarındaki enflasyonu fark etmişsinizdir. Kimisi frontend, kimisi fullstack, kimisi backend, kimisi de devops arıyor. Bana gelen soruların başında “şunu olmak için nereden başlamalıyım” sorusu geliyor. Genç programcı ya da programcı adaylarının kafası iyice karışmış durumda. Piyasa istiyor, boyun eğilmesi gerekiyor diyeceğim, ama bana kızacaksınız muhtemelen. Piyasa her zaman ne istediğini bilemeyebilir. Piyasa doğal olarak sermaya güdümlüdür. En az paraya, en çok işi yaptırmaya çalışıyor doğal olarak. Bu sebepten dolayı fullstack developer gibi absürd bir gereksinim oluşmuş durumda. Fullstack aslında ne tam olarak frontendi ne de backendi bilen bir programcı anlamına geliyor. İkisini de çok iyi derecede bilmek imkansız gibi bir şey. Ama piyasa iki programcı istihdamı yerine, bir programcı ile iki tarafı da götürmek istiyor ki yakında bu fikrin iyi bir fikir olmadığını anlayacaklar. O yüzden “he he” deyip, geçelim. Burada asıl değinmek istediğim nokta, unvandan ziyade bilginin daha önemli olduğunu vurgulamaktır. Tecrübeli ve bilgili bir yazılımcı için yeni bir şeyleri öğrenmek birkaç günlük mesele. Ama bunun için önce bir şeyleri çok derinlemesine ve kapsamlı olarak öğrenmiş ve uygulamış olması gerekiyor. Paranın parayı çektiği gibi, bilgi de bilgi çekiyor ya da doğuruyor. O yüzden buradaki ana mevzu çok okumak, çok öğrenmek ve çok uygulamaktır. Bu yeteneklerin olduğu yerde “öğrenmeye nereden başlamalıyım” soruşnun cevabı bellidir.

Uzun süredir yazılım sektöründe olanlar corba, ejb ya da soa gibi teknolojileri ve bu teknoojilerin başlarına gelenleri bilirler. Her birisi yeni bir hype olarak doğmuş ve bir sonraki hype in gürültü, patırdışı içinde kaybolup, gitmişlerdir. Hani yazılımdaki her türlü problemin çözümü bu ve buna benzer teknolojilerdi? Nerede kaldı o full distributed, mega event bus, kop da gel rest mimarileri? Sıkıntı yok, biri gider, diğeri gelir. Bunların en yenisi microservis diye tabir edilen, aslında sadece bir işi yapacakken yine monolit haline dönüşen uygulamalar. Microservice mimarisi yine her şeyin çözümü gibi satılıyor. Hadi sonumuz hayırlısı. Ne olacağını söyleyeyim. Beş sene sonraki kimse bu mimariyi ne konuşacak ne de uygulayacak. Tarih tekerrürden ibarettir.

Gelelim Java’ya. Şimdilerde Java 12. ve 13. sürüme kadar gelmiş bulunuyoruz. Neler oluyor? Dili hip tutacağız diye, takla üstüne takla atmaya başladılar. Dil nesneye yönelik ve ımperatifti. Şimdilerde functional ya da öyle olduğunu düşünüyor. Doğal olarak benim gibi kalın kafalı javacılar artık ımperatif değil fonksiyonel düşünmek zorunda. Cobolculara OOP öğretmek daha kolaydır sanırım. Imperatif programlamaya alışmış bir programcıya fonsiyonel programlamayı öğretmek, deveyi hendekten atlamaktan daha zor bir şey. Nereden mi anlıyoruz? Bknz. for yerine stream kullanan programcılar.

Yazılım sektöründe yeni diye satılan çoğu şey mevcudiyetin soyutlanmış yeni bir hali. Durum bu iken aslında gelişmelere adapte olmak çok kolay. Bunun için işin temellerini bilmek yeterli. Ama o temeller artık o kadar derinlerde ki çoğu programcı nerede olduklarını bilme ve anlama umudunu bile yitirmiş durumda. Bu durumda teknolojiden teknolojiye savrulmaya ve bir devrin programcısı olmaya hazır olmak lazım (bknz. Zaman Eksenindeki Teknolojik Fay Hatlarının Programcılar Üzerindeki Etkileri).

Saygı ve sevgilerimle.


EOF (End Of Fun)
Özcan Acar

Alan Borcu (Domain Debt)

Buradaki yazımda teknik borcun ne olduğunu, nasıl oluştuğunu ve nasıl ödenebileceği konusuna değinmiştim. Teknik borç kodu doğrudan ilgilendiren ve projenin sürdürülebilirliğini etkileyen bir durumdur. Bu yazımda teknik borç kadar dikkat görmeyen, lakin yazılım projesinin kaderini teknik borçlanmaya nazaran daha belirleyici olan alan borçlanmasından bahsetmek istiyorum.

Her yazılım sisteminin hitap ettiği bir alan (domain) vardır. Bu alanda yer alan iş süreçleri yazılım sisteminin şekillendirilmesinde yön verirler. Yazılım sisteminin merkezinde alan modeli (domain model) yer alır. Alan modeline dayalı olmayan ya da alandaki iş süreçlerinden doğan gereksinimleri tatmin edemeyen yazılım sistemi oluşturulma hedefine ulaşamamıştır ve alan kullanıcıları tarafından kullanılabilecek yapıda değildir.

Bir önceki paragrafta yer alan teknik terimleri bir örnek üzerinde inceleyelim. İnternet üzerinden sipariş yapmak için kullanılan bir sistemin hitap ettiği alan internet tabanlı alışveriştir (online shopping). Yazılım sisteminin merkezinde yer alan alan modelindeki öğeler (entity) müşteri, sipariş, ürün, adres, ödeme şekli, fatura, alışveriş sepeti gibi yapılardır. Alan kullanıcıları sipariş veren müşteriler ya da gelen siparişleri gözden geçiren çalışanlardır. Örneğin bir müşterinin sipariş verebilmesi için önce seçtiği ürün ya da ürünleri alışveriş sepetine eklemesi gerekmektedir. Siparişin temelini bu örnekte alışveriş sepeti oluşturmaktadır. Bunun yanı sıra müşterinin adres ve ödeme bilgileri sipariş esnasında girmesi gerekmektedir. Sistem çalışanları yönetim paneli aracılığı ile gelen siparişler hakkında bilgi edilebilirler. Burada iş süreçleri devreye girmektedir. Mevcut bir siparişin nasıl yönetildiğini bir iş süreci belirler. Bu iş süreci siparişin yönetimi ile ilgili tüm detayları ihtiva eder. Yazılım sistemi bu detayların koda dökülmüş halidir. İş süreçlerinden gereksinimler doğar ve yazılım sistemi bu gereksinimleri tatmin etme görevini üstlenir.

Oluşturulan yazılım sistemi sadece gerçeği modellemeye çalışan bir araçtır. Bu model gerçeğe ne kadar yakın ise, o oranda yazılım sisteminin kullanımı kolaylaşır ve teşvik edilir. Oluşturulan modelin gerçek ile örtüşür hale gelebilmesi için yazılım ekibinin yazılım sistem sahibi yani müşterileri ile sıkı diyalog halinde olmaları gerekmektedir. Bu her zaman geçerli olmamakla birlikte, sadece müşteri nasıl bir sistem sahibi olmak istediğini bilebilir. Burada yazılım ekibinin öncelikli görevi müşteri gereksinimlerini tespit etmek, iş süreçlerini anlamak ve buradan yola çıkarak bir alan modeli oluşturmaktır. Alan modeli ve iş süreçlerinin implementasyonu gerçeğe ne kadar yakın olurlarsa, projenin başarılı olması o oranda artacaktır. Bunun eksikliği müşterinin kullanmayı reddettiği ve gereksinimlerini tatmin etmeyen bir yazılım ürünü olacaktır.

Bu açıklamalar ışığında alan borçlanmasının ne olduğunu ve nasıl oluştuğunu inceleyelim. Alan borçlanmaları oluşturulan alan modeli ve iş süreçleri implementasyonlarının mevcut ve gelecekteki yeni gereksinimleri tatmin etmek üzere yapılan çalışmaların zora girmesi ile kendilerini gösterirler. Alan borçlanmalarının oluşma şekillerini şu şekilde sıralamak mümkündür:

  • Yazılım ekibi müşteriyi ve gereksinimlerini yeterince anlamadığı için yazılımı yanlış bir model üzerine inşaa eder. Model gerçekleri yansıtmadığı için yazılım ekibi müşteri gereksinimlerini implemente etmekte zorlanır.
  • Mevcut alan modeli genel tutulduğundan ve alt alanlarda (subdomain) ortak kullanıldığından çok sıklıkla değişikliğe uğrar ve alt alanların ihtiyaçlarını tatmin edemez hale gelir. Bu şekilde yapılmak istenen değişiklikler zorlaşır, çünkü model tüm alt alanları destekleyecek esnekliğe sahip değildir.
  • Müşterinin gerekli bilgileri sağlamaması neticesinde yazılım ekibi doğru düşündüğü şekilde modeli oluşturur. Yeni gelen bilgiler doğrultunda modelin yetersiz olduğu tespit edilir. Bu proje bünyesinde geniş çaplı bir yeniden yapılandırma (refactoring) gereksinimi doğurabilir. Bu çapta bir yeniden yapılandırma için gerekli zaman olmadığı için mevcut alan modeli uygulamanın çeşitli yerlerinde oluşturulan yerel alan modellerine dönüştürülerek (mapping) tekrar kullanılır.
  • Programcılar genel alan modelinde yer alan öğelerden bazılarını yerel implementasyonlarında tekrar (reuse) kullanırlar. Lakin kullanım bağlamı (context) değiştiği için kullanılan ögeler yetersiz kalabilir. Aynı zamanda genel alan modelinde yapılan değişiklikler ögelerin başka bağlamda kullanıcılarını kırılgan hale getirebilir.

Kimi zaman bilgi yetersizliği, kimi zaman yanlış anlaşılmalar ve kimi zaman zaman yetersizliği alan borçlanmasına sebep verebilmektedir. Teknik borçlanmalara kıyasla alan borçlanmaları bir projenin tamamen durma noktasına gelmesine sebep olabilmektedirler. Bunun önüne geçmek için yazılım ekibinin alan eksperleri ile sıkı bir diyalog içinde olmaları ve ortak bir alan dili oluşturmaları gerekmektedir. Bu ortak dil programcıların ihtiyaç duyulan alan modelini oluşturmalarını ve gerekli şekilde kullanımını kolaylaştırıcı nitelikte olacaktır.

Alan borçlanmasını önlemek için müşteri ve yazılım ekibi arasında sıkı bir diyaloğun ve ortak bir alan dilinin oluşturulması gerektiğinden bahsettim. Peki teknik olarak alan borçlanmasını önlemek için kullanılabilecek yöntemler var mıdır? Teknik borcun ödenmesinde olduğu gibi alan borçlanmaları da kod yeniden yapılandırılarak ödenebilirler. Bu çok masrafla bir uğraşı haline dönüşebilir. Durumun bu hale gelmesini önlemek için projenin başlangıç safhalarında gerekli önlemlerin alınması gerekmektedir. Bu yöntemler nelerdir?

Domain Driven Design (DDD) olarak bilinen yöntemde sınırlı bağlam (bounded context) olarak bilinen bir metot mevcuttur. Bu metot ile sınırlı geçerlilik alanı bulunan alan modelleri oluşturulur. Modeller birbirlerinden bağımsızdır ve geçerli oldukları alanlar belirlidir. Modellerin ya da sahip oldukları parçaların tanımlandıkarı bağlam haricinde kullanılmları yasaktır. Bu şekilde bir model bir sorumluluk prensibi uygulanmış olur. Tek sorumluluk prensibinden de bildiğimiz gibi bir yazılım öğesinin birden fazla sorumluluk taşıması onun kırılganlığını artırır. Sınırlı bağlam bunu önleyici bir yöntemdir ve oluşturulan alan modellerinin tek bir sorumluluk ile tanımlanmalarını mümkün kılar.

Teknik ve alan borçlarıyla başetmenin en verimli yöntemi oluşmalarını engellemektir. Bunun için kullanılabilecek yöntemlerin başında çevik süreçler gelir. Örneğin test güdümlü yazılım yeniden yapılandırma süreci kolaylaştırır. Hızlı bir şekilde yapılabilen yeniden yapılandırma kodu rehin alan her türlü borcun ödenmesini kolaylaştırır. Ama kanımca çevik süreçlerde her türlü borçlanmayı engelleme potansiyeline sahip başka bir yöntem daha mevcuttur. Bu yöntem aracılığı ile belli zaman dilimlerinde yeni sürümler oluşturularak, gelinen durum müşteri ile paylaşılır. Müşteriden alınan geribildirim aracılığı ile model hataları kısa zamanda farkedilir ve gerekli düzeltmeler gerçekleştirilir. Burada çevik süreçler bünyesinde yer alan yazılım metotlarının tamemen geribildirim döngüleri üzerine kurulu olduğunu söylemek doğru olacaktır. Test yazımı, sürekli entegrasyon, eşli programlama, sürekli yeni sürüm oluşturmak her daim geribildirim alınmasını ve gerekli rota değişikliği yapılamasını mümkün kılar. Bu bağlamda teknik ve alan borçlarının aslında yetersiz ya da mevcut olmayan geribildirimi döngülerinden kaynaklandığını söylemek yanlış olmayacaktır.

Teknik borç konusunun yazılımcılar arasında sıkça dile gelen bir konu olduğuna şahit olmaktayım. Lakin alan borçlanması o kadar sıkça dile gelen bir konu değildir. Her yazılım projesinde alan borçlanmasına şahit olmak mümkündür. Kod kalitesi ne kadar iyi olursa, olsun yanlış bir alan modeli yeni değişikliklerin yapılmasını zorlaştıracaktır. Bu duruma gelmemek için öncelikle alan borçlanmasını da ciddi bir proje riski olarak görülmesi ve projenin başlangıcından itibaren bu konuya gerekli önemin verilmesi gerekmektedir.


EOF (End Of Fun)
Özcan Acar

Neden Debug Yapmak Yazılımın En Kötü Alışkanlıklarından Birisidir

Kodu debug yapma tekniği her yazılımcının hata bulmak ve kodu anlamak için kullandığı bir yöntemdir. Lakin bu tekniğin kullanımı yazılımın en kötü alışkanlıklarından birisidir. Bunun neden böyle olduğunu bu yazımda sizlerle paylaşmak istiyorum.

Yazıma başlamadan önce şunu belirtmek isterim. Bir yazılımcı olarak debug etme tekniğini gerekli gördüğümde kullanıyorum. Bu blog yazımın kesinlikle “debug etmek yanlıştır, kullanılmamalıdır” şeklinde algılanmasını istemem. Gerekli olduğu yerde debug etme tekniğinin kullanımı mübahtır. Yazımda debug yapma termini hata bulma ve kodu anlama süreci için eş anlamlı kullandım.

Bu konuda kısa bir zaman önce bir tweet yazdım:


Okumaya devam et →

Java 9 ile Modül Bazlı Yazılım

Bir yazılım sisteminde karmaşaya, bağımlılıklara ve kodun bakım ve geliştirilmesi sürecine hakim olabilmenin bir yolu da komponent ya da modül bazlı yazılım yapmaktan geçmektedir. İdeal şartlarda bir modül tek bir görevi yerine getirir ve tek sorumluluk prensibi göz önünde bulundurularak implemente edilmiştir. Modül iç dünyasını gizli tutar ve kullanımını modül API (application programming interface) olarak isimlendirilen tanımlı giriş, çıkış kanalları ya da başka bir deyişle kullanım arayüzü aracılığı ile sağlar. Kullanım arayüzleri modülün hangi işlemleri gerçekleştirdiğini soyut olarak tanımlarken, bu işlemlerin nasıl gerçekleştirildikleri modül içinde yer alan implementasyonlarda yer almaktadırlar. Kısaca bir modül kullanıcısı için bir kara kutudur. Bu şekilde kullanıcısını etkilemeden, iç implementasyonu değiştirmek mümkündür, çünkü kullanıcı iç implementasyona değil, kullanıcı arayüzüne bağımlıdır. Kullanıcı arayüzleri sahip oldukları yapıyı koruyabildikleri sürece, modül üzerinde yapılan değişiklikler kullanıcıyı etkilemez. Bu şekilde tanımlı kullanıcı arayüzleri aracılığıyla esnek olarak birbirine bağlı olan uygulama parçaları geliştirmek ve bu parçalar üzerinde uygulamanın genelini etkilemeden gerekli değişiklikleri yapmak mümkündür.

Java 9 öncesinde modül bazlı yazılımın nasıl yapıldığını ya da benim bu konuda nasıl çalıştığımı ve karşılaştığım sorunları bir örnek üzerinde göstermek istiyorum. Vereceğim örnekte loglama işlemini gerçekleşiren bir modül yer almaktadır. Bu modülün kullanım arayüzü (API) Logger.java isimli sınıfta tanımlıdır.

[source language=”java”]

package com.kurumsaljava.logger;

public interface Logger {

void log(LogLevel level, String log);

}
[/source]

Logger bir interface sınıftır ve modülün yaptığı işlemi tek bir soyut metot olarak ihtiva etmektedir. Bu yapı bize genel olarak modülün hangi tür bir işlemden sorumlu olduğunu tanımlama imkanı sağlamaktadır. Bunu yaparken herhangi bir implementasyon detayı kullanma zorunluluğumuz bulunmamaktadır. Bu şekilde tamamen soyut bir tanımlama yapmış olmaktayız. Oluşturduğunuz API ne sorusuna cevap verirken, nasıl sorunun cevabını iç implementasyona bırakmaktadır.

Loglama işleminin nasıl gercekleştirildiği bir implementasyon detayıdır ve modül dışında yer alanları ilgilendirmez/ilgilendirmemeldir. Modülün ana görevlerinden birisi, bu implementasyon detayını gizlemek olmalıdır. Bu ona implementasyon üzerinde istediği şekilde değişiklik yapma imkanını sunarken, modül kullanıcılarının bu değişikliklerden doğrudan etkilenmelerinin önüne geçen bir unsur olacaktır.

Modülün sorumlu olduğu işlemi su şekilde implemente edebiliriz:

[source language=”java”]
package com.kurumsaljava.logger;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.Logger;

class StdoutLoggerImpl implements Logger {

@Override
public void log(LogLevel level, String log) {
System.out.println(level.name() + " – " + log);
}
}
[/source]

Burada dikkatinizi sınıfın tanımlandığı satıra çekmek istiyorum. Sınıfı public olarak tanımlamadım, çünkü modül dışındaki dünyanın bu sınıfa erişimini engellemek istiyorum. Modülün kara bir kutu olabilmesi için bu gerekli bir adım. Bana kalmış olsa bu sınıfı private olarak tanımlardım. Ama bu ne yazık ki mümkün değil, çünkü bir interface sınıfın tüm metotları ya public ya da package private olmak zorundadır yani implementasyon sınıfı private kullanarak metotların görünürlüğünü daha da daraltamaz. Bu yüzden yukarıda yer alan implementasyon sınıfını en az package private olarak tanımlayabilmekteyim. Bu StdoutLoggerImpl sınıfının sadece aynı paket içinde yer alan sınıflar tarafından erişilebilir olduğu anlamına gelmektedir. Ama reflection kullanarak, bu sorunu aşabiliriz yani sadece paket içinde kullanılabilir olan bir sınıfın reflection aracılığı ile başka bir paket içinde yer alan bir sınıf tarafından kullanılabilir olmasını sağlayabiliriz.

[source language=”java”]
package com.kurumsaljava.application;

import java.lang.reflect.Constructor;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.Logger;

public class Main {

public static void main(String[] args) throws Exception {

Class<Logger> c = (Class<Logger>)Class.forName("com.kurumsaljava.logger.StdoutLoggerImpl");

Constructor<?> constructor = c.getDeclaredConstructor();
constructor.setAccessible(true);
Logger logger = (Logger)constructor.newInstance();
logger.log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Görüldüğü gibi başka bir paket içinde yer alan Main sınıfı aslında modülün iç dünyasının bir parçası olan ve dış dünyanın görmemesi gereken bir implementasyon sınıfını kullanabilmektedir. Buna ne derleyici ne de yorumlayıcı engel olabilmiştir. Bu durum modüler bir yapı oluşturmamıza engel olmakta ve modüllerin birer kara kutu olmaları gerektiği prensibini çiğmemektedir. Modül bir kara kutu olduğunu düşünerek hareket ettiğinde, örneğin StdoutLoggerImpl yerine başka bir sınıf oluşturulduğunda, Main sınıfı çalışmaz hale gelecektir. Oysaki bizim istediğimiz modül kullanım yapısı şu şekilde olmalıdır:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) throws Exception {

LoggerFactory.instance().log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Main sınıfı logger modülene ve sunduğu hizmete erişebilmek için LoggerFactory sınıfını kullanmaktadır. LoggerFactory şu yapıya sahiptir ve iç implementasyonu API aracılığı ile kullanılabilir hale getirmektedir:

[source language=”java”]
package com.kurumsaljava.logger;

public class LoggerFactory {

public static Logger instance() {
return new StdoutLoggerImpl();
}
}
[/source]

LoggerFactory sınıfı StdoutLoggerImpl sınıfı ile aynı paket içinde bulundugundan, LoggerFactory bu sınıfı kullabilmektedir. İç implementasyonu kullanılabilir hale getirmek için API’nin bir parçası olan böyle bir sınıfı oluşturmamız gerekmektektedir. Bu durumda modülün kullanım arayüzünü oluşturan sınıflar Logger, LogLevel ve LoggerFactory sınıflarıdır yani modül kullanıcıları modülün sunduğu hizmeti sadece bu üç sınıf aracılığı ile kullanabilirler. Ama reflection örneğinde gördüğümüz gibi iç implementasyona erişmek her zaman mümkündür yani Java dilinde gerçek modüller oluşturmak aslında mümkün değildir.

StdoutLoggerImpl sınıfı gizleme imkanımız gerçekten yok mu? Bir de şöyle denesek:

[source language=”java”]
package com.kurumsaljava.logger;

public class LoggerFactory {

public static Logger instance() {
return new StdoutLoggerImpl();
}

private static class StdoutLoggerImpl implements Logger {

@Override
public void log(LogLevel level, String log) {
System.out.println(level.name() + " – " + log);
}
}
}
[/source]

Java’da bir sınıf bünyesinde başka bir sınıf tanımlamak (inner class) ve sınıfı private olarak deklare etmek mümkün. Modülü yine şu şekilde kullanabiliriz:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) throws Exception {

LoggerFactory.instance().log(LogLevel.DEBUG, "Hello World");
}
}
[/source]

Peki reflection? Ne yazık ki bu şekilde bile reflection ile iç sınıflara erişim mümkündür:

[source language=”java”]
public static void main(String[] args) throws Exception {

Class<Logger> c = (Class<Logger>)Class.forName("com.kurumsaljava.logger.LoggerFactory$StdoutLoggerImpl");

Constructor<?> constructor = c.getDeclaredConstructor();
constructor.setAccessible(true);
Logger logger = (Logger)constructor.newInstance();
logger.log(LogLevel.DEBUG, "Hello World");
}
[/source]

Sonuç? Java 9 öncesi dilin sahip oldugu özellikleri kullanarak kara kutu gibi çalışan modüller oluşturmak mümkün değil. Biz ne kadar paket bazında sınıf erişimini engellemeye çalışsak da, classpath içinde yer alan her sınıfa erişim bir şekilde mümkündür. Bize burada ne jar dosya yapısı, ne public/private direktifleri ne de tüm sınıfların yer aldığı classpath destek vermektedir. Peki Java dilinde modül nasıl oluşturabiliriz? Bu OSGI (Open Services Gateway initiative) ile mümkün, ama Java 9 ile daha da kolay, çünkü modüller için gerekli yapılar dilin ve derleyicinin bir parçası haline geldi.

Java 9 sürümünün getirdiği yeniliklerin başında yeni modül sistemi geliyor. Şimdi logger modülünün gerçek bir modül olarak Java 9 ile nasıl implemente edilebileceğini yakından inceleyelim.

Öncelikle bir takım sınıfların bir modül teşkil ettiğini tanımlamamız gerekiyor. Bu amaçla modül tanımlayıcısı (module descriptor) olarak isimlendirilen bir sınıf oluşturmamız gerekiyor. Logger modülü için bu sınıfı şu şekilde tanımlayabiliriz:

[source language=”java”]
module logger {
}
[/source]

Modül tanımlayıcı sınıfının ismi module-info.java ismini taşımaktadır. Yukarıdaki örnekte logger isminde bir modül tanımladık. Modülün yer alacağı dizin yapısı şu şekildedir:

[source language=”java”]
src
|__logger
|__module-info.java
|__com
|_kurumsaljava
|__logger
|__Logger.java
|__LoggerFactory.java
|__LogLevel.java
|__StdoutLoggerImpl.java
[/source]

Modüle ait tüm parçalar src/logger dizininde yer almaktadır. Modülü tanımlamak için src/logger/module-info.java sınıfını oluşturduk. Modül implementasyonu /src/logger/com/kurumsaljava/logger dizininde yer almaktadır. Şimdi logger modülünü kullanan yeni bir modül oluşturulım. Application ismini taşıyan bu modül, logger modülünde yer alan loglama servisini kullanmaktadır.

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__Logger.java
| |__LoggerFactory.java
| |__LogLevel.java
| |__StdoutLoggerImpl.java
|__application
|__module-info.java
|__com
|_kurumsaljava
|__application
|__Main.java
[/source]

Uygulamamız iki modülden oluşmaktadır ve şu şekilde (windows powershell ile) derlenmektedir:

[source language=”java”]

javac -d classes –module-source-path src $(dir src -r -i "*.java")

[/source]

Birinci parametre (-d) ile derlenen sınıfların hangi dizinde yer aldığını, ikinci parametre ile (–module-source-path) derlemek istediğimiz modül kodlarının hangi dizinde yer aldığını tanımladık. Bu işlemin ardından ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> javac -d classes –module-source-path src $(dir src -r -i "*.java")
C:\Users\acar\eclipse-workspace-java9\modules\src\application\com\kurumsaljava\application\Main.java:3: error: package com.kurumsaljava.com.logger is not visible
import com.kurumsaljava.com.logger.LogLevel;
^
(package com.kurumsaljava.com.logger is declared in module logger, but module application does not read it)
C:\Users\acar\eclipse-workspace-java9\modules\src\application\com\kurumsaljava\application\Main.java:4: error: package com.kurumsaljava.com.logger is not visible
import com.kurumsaljava.com.logger.LoggerFactory;
^
(package com.kurumsaljava.com.logger is declared in module logger, but module application does not read it)
2 errors
[/source]

Hatanın ne olduğunu daha iyi anlayabilmek için tekrar Main sınıfına bir göz atalım:

[source language=”java”]
package com.kurumsaljava.application;

import com.kurumsaljava.logger.LogLevel;
import com.kurumsaljava.logger.LoggerFactory;

public class Main {

public static void main(String[] args) {
LoggerFactory.instance().log(LogLevel.INFO, "Hello World");
}

}
[/source]

Main sınıfı LogLevel ve LoggerFactory sınıflarını kullanmaktadır. Bunlar logger modülünün kullanım arayüzünü oluşturan sınıflardır. Lakin derleyici bu sınıflar için “not visible” yani görülmeyen sınıflar hatasını vermektedir. Derleyici bu sınıfları bulamamaktadır, çünkü logger modülü tanımlayıcısında (module-info.java) bu sınıflar kullanıma açılmamıştır yani logger modülü bu hali ile tam bir kara kutudur ve kullanımı imkansızdır. Logger modülünü kullanılabilir hale getirmek için kullanım arayüzünü oluşturan sınıfları diğer modüllerin erişebileceği şekilde tanımlamamız gerekmektedir. Bu işlemi şu şekilde gerçekleştirebiliriz:

[source language=”java”]
— logger/module-info.java

module logger {
exports com.kurumsaljava.logger;
}
[/source]

Bu tanımlama ile com.kurumsaljava.logger paketinde yer alan sınıfların hepsini diğer modüller tarafından kullanılabilir hale getirmiş olduk. Logger modülünü kullanmak isteyen her modülün şu şekilde bu isteği dile getirmesi gerekmektedir:

[source language=”java”]
— application/module-info.java

module application {
requires logger;
}
[/source]

Derleme işlemi tamamlandıktan sonra, uygulamayı oluşturan Main sınıfını şu şekilde koşturabiliriz:

[source language=”java”]

java –module-path classes -m application/com.kurumsaljava.application.Main

[/source]

Bu hali ile bir modülün sahip olması gerektiği yapıya çok yaklaşmış olduk. Modülün iç dünyasını paket bazında kullanıma sunabildigimiz için logger modülünün yapısını aşağıdaki şekilde değiştirmek faydalı olacaktır, aksi taktirde bu konfigürasyon ile application/Main sınıfı doğrudan StdoutLoggerImpl sınıfına erişebilmektedir. Bu dogal olarak modülün bir kara kutu gibi işlev görmesinin önünde bir engel oluşturmaktadır.

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__impl
| | |__StdoutLoggerImpl.java
| |__api
| |__Logger.java
| |__LoggerFactory.java
| |__LogLevel.java

— logger/module-info.java

module logger {
exports com.kurumsaljava.logger.api;
}
[/source]

Modüler uygulamamızı koştururken –module-path parametresi dikkatinizi çekmiş olabilir. Aynı şekilde modülleri derlerken –module-source-path parametresini kullanmıştık. Java’nın yeni modül sistemi classpath yerine modülü oluşturan sınıfları yüklemek için module-path dizin yapısını kullanmaktadır. Module path bir ya da daha fazla ve derlenen modülleri ihtiva eden dizinlerden oluşmaktadır. Derleme işlemi esnasında modüle ait sınıflar module-source-path ile tanımlanmatadır. Modüler bir uygulama koşturulduğunda, modülün module-path içinde bulunan ilk sürümü kullanılmakta ve diğerleri göz ardı edilmektedir. Module-path ve classpath birlikte kullanılabilmektedir.

Oluşturulan modülleri jar dosyalarında tutmak münkün. Lakin her modül için ayrı bir jar dosyası oluşturulması gerekmektedir. Modüler uygulamamiz için aşağidaki şekilde modül jar dosyaları oluşturabilir ve bu jar dosyaları aracılığı ile uygulamamızı koşturabiliriz.

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –create –file module/application.jar –main-class com.kurumsaljava.application.Main -C classes/application .
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –create –file module/logger.jar -C classes/logger .
PS C:\Users\acar\eclipse-workspace-java9\modules> java –module-path module -m application/com.kurumsaljava.application.Main
INFO – Hello World
[/source]

Oluşturdugumuz modüller arasındaki bağımlılıkları şu şekilde kontrol edebiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jdeps –module-path modules module/*.jar
application
[file:///C:/Users/acar/eclipse-workspace-java9/modules/module/application.jar]
requires mandated java.base (@9.0.4)
requires logger
application -> java.base
application -> logger
com.kurumsaljava.application -> com.kurumsaljava.logger logger
com.kurumsaljava.application -> java.lang java.base
logger
[file:///C:/Users/acar/eclipse-workspace-java9/modules/module/logger.jar]
requires mandated java.base (@9.0.4)
logger -> java.base
com.kurumsaljava.logger -> java.io java.base
com.kurumsaljava.logger -> java.lang java.base
com.kurumsaljava.logger -> java.lang.invoke java.base
PS C:\Users\acar\eclipse-workspace-java9\modules>
[/source]

Görüldügü gibi application.jar dosyasında yer alan modül logger modülü yanı sıra java.base modülüne bağımlıdır. Aynı şekilde logger modülü de java.base modülüne bağımlıdır. Burada Java bünyesinde yer alan sınıfların da artık modüler bir yapıda olduğunu görmekteyiz. Sadece ihtiyaç duyulan sınıfların yer aldığı modülleri kullanarak, Java uygulamalarını daha az hafıza ihtiyacı duyan Java ortamlarında koşturmak mümkün hale gelmiştir. Tüm java modüllerine şu sekilde erişebiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> java –list-modules
java.activation@9.0.4
java.base@9.0.4
java.compiler@9.0.4
java.corba@9.0.4
java.datatransfer@9.0.4
java.desktop@9.0.4
java.instrument@9.0.4
java.logging@9.0.4
java.management@9.0.4
java.management.rmi@9.0.4
java.naming@9.0.4
java.prefs@9.0.4
java.rmi@9.0.4
java.scripting@9.0.4
java.se@9.0.4
java.se.ee@9.0.4
java.security.jgss@9.0.4
java.security.sasl@9.0.4
java.smartcardio@9.0.4
java.sql@9.0.4
java.sql.rowset@9.0.4
java.transaction@9.0.4
java.xml@9.0.4
java.xml.bind@9.0.4
java.xml.crypto@9.0.4
java.xml.ws@9.0.4
java.xml.ws.annotation@9.0.4
jdk.accessibility@9.0.4
jdk.attach@9.0.4
jdk.charsets@9.0.4
jdk.compiler@9.0.4
jdk.crypto.cryptoki@9.0.4
jdk.crypto.ec@9.0.4
jdk.crypto.mscapi@9.0.4
jdk.dynalink@9.0.4
jdk.editpad@9.0.4
jdk.hotspot.agent@9.0.4
jdk.httpserver@9.0.4
jdk.incubator.httpclient@9.0.4
jdk.internal.ed@9.0.4
jdk.internal.jvmstat@9.0.4
jdk.internal.le@9.0.4
jdk.internal.opt@9.0.4
jdk.internal.vm.ci@9.0.4
jdk.jartool@9.0.4
jdk.javadoc@9.0.4
jdk.jcmd@9.0.4
jdk.jconsole@9.0.4
jdk.jdeps@9.0.4
jdk.jdi@9.0.4
jdk.jdwp.agent@9.0.4
jdk.jlink@9.0.4
jdk.jshell@9.0.4
jdk.jsobject@9.0.4
jdk.jstatd@9.0.4
jdk.localedata@9.0.4
jdk.management@9.0.4
jdk.management.agent@9.0.4
jdk.naming.dns@9.0.4
jdk.naming.rmi@9.0.4
jdk.net@9.0.4
jdk.pack@9.0.4
jdk.policytool@9.0.4
jdk.rmic@9.0.4
jdk.scripting.nashorn@9.0.4
jdk.scripting.nashorn.shell@9.0.4
jdk.sctp@9.0.4
jdk.security.auth@9.0.4
jdk.security.jgss@9.0.4
jdk.unsupported@9.0.4
jdk.xml.bind@9.0.4
jdk.xml.dom@9.0.4
jdk.xml.ws@9.0.4
jdk.zipfs@9.0.4
[/source]

Aşağıdaki şekilde sadece uygulamamızı ve ihtiyaç duyduğumuz Java modüllerini ihtiva eden bir Java sürümü oluşturabiliriz:

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jlink –module-path "%JAVA_HOME%/jmods;module" –add-modules application –output distribution
PS C:\Users\acar\eclipse-workspace-java9\modules> .\distribution\bin\java -m application
INFO – Hello World
[/source]

Jlink ile oluşturduğumuz Java sürümü sadcee 35MB büyüklügünde olup, uygulamamızı ihtiva etmekle birlikte, onu koşturmak için gerekli tüm yeteneklere sahiptir. Bunu 300MB büyüklügünde olan JDK9 sürümü ile kıyasladığımızda, Java ile modüler yazılımın ve Java’nın sahip olduğu kendi modüler yapının Java 9 ile yapılacak yeni projelerde hafıza kullanımını ne oranda düşürebileceği görülmektedir.

Modül tanımlayıcılarının (module descriptor) içeriğine aşağidaki şekilde ulaşmak mümkündür. Bu kullanmak istediğimiz modüllerin kullanım arayüzleri hakkında fikir edinmemizi kolaylaştıracaktır.

[source language=”java”]
PS C:\Users\acar\eclipse-workspace-java9\modules> jar –describe-module –file=module/logger.jar
logger jar:file:///C:/Users/acar/eclipse-workspace-java9/modules/module/logger.jar/!module-info.class
exports com.kurumsaljava.logger
requires java.base mandated

PS C:\Users\acar\eclipse-workspace-java9\modules> jar –describe-module –file=module/application.jar
application jar:file:///C:/Users/acar/eclipse-workspace-java9/modules/module/application.jar/!module-info.class
requires java.base mandated
requires logger
contains com.kurumsaljava.application
main-class com.kurumsaljava.application.Main

PS C:\Users\acar\eclipse-workspace-java9\modules>
[/source]

Son olarak servis modüllerinden bahsetmek istiyorum. Şimdiye kadar incelemiş olduğumuz modül sisteminde bir sorun mevcut. Logger modülünün birden fazla implementasyonu düşünülebilir. Örneğin bir RemoteLoggerImpl sınıfı ile logları bir sunucuya gönderebiliriz. Bu durumda ikinci bir modül oluşturarak, Logger sınıfını yeniden implemente etmemiz gerekmektedir. Lakin bu durumda modül kullanıcısının bağımlılık sayısı artacaktır. İncelediğimiz örnekte application modülü logger modülünü kullanmaktadır. İsmi remotelogger olan yeni bir modül oluşturduğumuz taktirde, application modülü bu yeni modülü kullanmak isteğinde, modül tanımlayıcısı şöyle bir yapıya bürünecektir:

[source language=”java”]
— application/module-info.java

module application {
requires logger;
requires remotelogger;
}
[/source]

Oluşturacağımız her yeni logger implementasyonu için bu liste uzayıp, gidecektir. Modüller arasında bu şekilde bir bağımlılık oluşturmak, modüllerin bakımını ve geliştirilmesini zora somaktadır. Hizmet kullanan (consumer) ve hizmet sunan (provider) modülleri birbirlerine bağımlı olmayacak şekilde ayırt etmemiz gerekmektedir. Aksi taktirde bu bağımlılıkların yönetimi imkansiz hale gelecektir. Bunu sağlamak için servis katalog (service catalog) ya da servis kayıt merkezi (service registry) yapısını kullanabiliriz.

Servis kayıt merkezini hizmet alan ve hizmet sunan modüller arasında bir aracı katman olarak düşünebiliriz. Hizmet sunan modüller servis kayit merkesine başvurarak, sundukları hizmeti kaydettirirler. Aynı şekilde hizmet almak isteyen modüller de servis kayıt merkezine başvurarak, istedikleri servisi edinmeye çalışırlar. Burada ki en önemli nokta, hizmet sunan ve hizmet alan modüllerin birbirlerini tanımamalarıdır ve daha önce bahsetmiş olduğum bağımlılığın oluşmamasıdır. Modüller sadce servis kayıt merkezini tanırlar ve işlemleri onun aracılığı ile gerçekleştirirler.

Şimdi logger modülünü iki değişik implementasyon sunacak şekilde yeniden oluşturalım ve application modülünün bu iki modüle bagımlı olmadan, mevcut logger implementasyonları servis kayıt merkezi aracılığı ile nasıl kullanabileceğini bir örnek üzerinde inceleyelim.

Logger modülünü soyut olarak yani sadece api sınıflarını ihtiva edecek şekilde şu şekilde tanımlayabiliriz:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java

— logger/module-info.java

module logger {
exports com.kurumsaljava.logger.api;
}

— Logger.java

package com.kurumsaljava.logger.api;
public interface Logger {

public void log(LogLevel level, String log);

}
[/source]

Akabinde stdout ve remote logger implementasyonlarını yeni iki modül bünyesinde aşağıdaki şekilde implemente edebiliriz:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java
|__remotelogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__remote
| |__RemoteLoggerImpl.java
|__stdoutlogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__stdout
| |__StdoutLoggerImpl.java

— remotelogger/module-info.java

module remotelogger {
requires logger;
provides com.kurumsaljava.logger.api.Logger with com.kurumsaljava.logger.remote.RemoteLoggerImpl;
}

— stdoutlogger/module-info.java

module stdoutlogger {
requires logger;
provides com.kurumsaljava.logger.api.Logger with com.kurumsaljava.logger.stdout.StdoutLoggerImpl;
}
[/source]

Modül tanımlayıcısı bünyesinde provides direktifi ile bir modül başka bir modül tarafından tanımlanmış ve export edilmiş bir api sınıfını implemente edebilmektedir. Provides ile oluşturduğumuz implementasyonlar servis kayıt merkezinde Logger sınıfı için iki servis implementasyonu kaydı oluşturacaktır. Kısaca iki yeni modül “biz bu servisi sağlayabiliyoruz” şeklinde bir açıklamada bulunarak, gerekli servis kayıtlarının oluşturulmasını sağlamaktadırlar. Peki bu modüllere doğrudan bir bağımlılık oluşturmadan, servis implementasyonlarını nasıl kullanabiliriz? Şu şekilde:

[source language=”java”]
src
|__logger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__api
| |__Logger.java
| |__LogLevel.java
|__remotelogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__remote
| |__RemoteLoggerImpl.java
|__stdoutlogger
| |__module-info.java
| |__com
| |_kurumsaljava
| |__logger
| |__stdout
| |__StdoutLoggerImpl.java
|__application
| |__module-info.java
| |__com
| |_kurumsaljava
| |__application
| |__Main

— application/module-info.java

module application {
requires logger;
uses com.kurumsaljava.logger.api.Logger;
}

— Main

package com.kurumsaljava.application;

import java.util.ServiceLoader;

import com.kurumsaljava.logger.api.Logger;
import com.kurumsaljava.logger.api.LogLevel;

public class Main {

public static void main(String[] args) {
Iterable<Logger> services = ServiceLoader.load(Logger.class);
for(Logger logger: services) {
logger.log(LogLevel.DEBUG, "Hello World");
}
}
}
[/source]

Application isimli modül modül tanımlayısı bünyesinde uses direktifi ile hangi modülü kullanmak istediğini ifade etmektedir. Bu Logger soyut sınıfını baz alan soyut bir tanımlamadır. Application modülü kesinlikle somut bir sınıf ya da modül implementasyonuna işaret etmemektedir. Bu şekilde modüller arasındaki bağı daha esnek hale getirmek ve modüller arası alışverişi servis kayıt merkezi aracılığıyla yürütmek mümkün hale gelmektedir.

Mevcut servis implementasyonlarına erişim yani servis kayıt merkezine başvuru ServiceLoader sınıfı aracılığı ile gerçekleşmektedir. Main örneginde Logger.class sınıfını implemente eden modüller load() metodu aracılığı ile servis kayıt merkezinden alınmakta ve bu şekilde arzu edilen servis modül bünyesindeki tanımlı kullanıcı arayüzü aracılığı ile koşturulabilmektedir. ServiceLoader örneğinde görüldüğü gibi LoggerFactory gibi bir sınıfın kullanımı gereksiz hale gelmiştir, çünkü factory (bknz. factory tasarım şablonu) görevini servis kayıt merkezi üstlenmektedir.

Java, 9 sürümü ile gerçek anlamda modüler uygulamaların oluşturulması mümkün kılan bir araç haline gelmiştir. Yeni uygulamaların bu avantajı kullanabilmeleri ümidiyle …


EOF (End Of Fun)
Özcan Acar
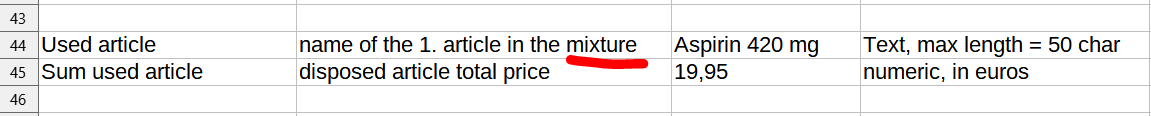
Yeni Teknolojileri Öğrenme Konusunda Nasıl Bir Yol Haritası Oluşturmalıyım?

Birçok okurumdan bu ve buna benzer sorular aldığım için bu konuyu aydınlatmak adına bu yazıyı kaleme almak istedim.

Bilindiği üzere yazılım sektörü çok hızlı teknolojik gelişmelere sahne olmakta. Kullanıma sunulan yeni programlama dilleri, çatı ve yöntemlerin sayısı çok yüksek. Doğal olarak yazılımcılar işin neresinden tutmalıyım ya da başlamalıyım, hangi konulara ağırlık vermeliyim, neleri öğrenmeliyim gibi sorularla karşılaşmaktalar. Bu yazımda bu tür sorulara kendim için nasıl cevap bulduğumu aktarmak istiyorum. Vermek istediğim örnek bir nevi öğrenim ve kişisel gelişim konusundaki benim yol haritam.

Ben öncelikle öğrenmem gereken şeyleri somut olanlar ve soyut olanlar olarak ikiye ayırıyorum. Soyut olan tarafta genel yazılım prensip ve yöntemleri yer alıyor. Soyut olan bu yapılar genel olarak yazılımın temel prensiplerini oluşturmakta. Bu temelleri oluşturmadan sağlam bir bilgi hazinesinin inşa edilmesi hemen hemen olanaksız. Örneğin nesneye yönelik programlama teknikleri, ayrık matematik, soyutlama yeteneği, tasarım prensipleri, tasarım şablonları gibi konular benim icin geçerliliğini hiçbir zaman yitirmeyen ve yazılıma genel ve soyut bir çerceveden bakmamı sağlayan konulardır. Yazılım alanındaki bilgi ve teknoloji genişliğine baktığımızda, bahsetmiş olduğum soyut konular bu büyüklüğün çok küçük bir kısmını oluşturmaktadırlar. Geriye kalan da zaten yeni diller, yeni çatılar, bu çatıların yeni sürümleri vb. gibi konulardan oluşmaktadır.

Soyut olarak tanımladığım ve yazılımın temellerini oluşturan konuların ihtisası büyük önem taşımaktadır. Örneğin yazılım prensiplerine hakim olmak, onları herhangi bir dilde uygulanabilir hale getirmektedir. Bu konuya hakim olan bir yazılımcı “acaba yazılım prensiplerinin bir sonraki sürümü nasıl olacak” kaygısı taşımayacaktır. Evrensel geçerliliği olan bu konu büyük çapta bir değişikliğe uğramadan, varlığını sürdürecek ve yazılımcının yazılıma genel bir çerceveden bakmasını kolaylaştıracaktır. Soyut konular ve onların ihtisası ile bahsetmek istediğim asıl nokta budur, onların evrensel geçerliliğe sahip ve her ortamda ve programlama dili ile uygulanabilir olmaları.

Soyutluğu işin felsefesi olarak algılayabiliriz. Bu gibi yapıları bir interface sınıf olarak düşünebiliriz. Java gibi dillerde sıkça kullanılan ve soyut sınıflar olan interface sınıflar bir işin nasıl yapıldığından ziyade ne yapılması gerektiğini tanımlayan sınıflardır. Bu sınıflar bünyesinde soyut işlemler yer alır. Bunların nasıl implemente edilecekleri implementasyon sınıflarına bırakılmıştır. Bu analogiden yola çıkarsak, piyasada bulunan bu kadar bilgi kirliliği (çatılar, onların yeni sürümleri ve diğer teknolojik araç ve gereçler) soyut konuları taban alan somut implementasyonlardan ibarettirler.

Somut teknolojileri doğuran ve ileriye götüren yazılım sahasındaki soyut felsefelerdir. Bu felsefeleri anlamadan somut teknolojilere yönelmek verimli sonuçlar doğurmayacaktır. Bu sebepten dolayı yazılımcının öğrenmesi gerektiği konularda soyutluğa ve işin felsefesini ihtiva eden konulara öncelik vermesinde fayda bulunmaktadır. Bu konuyu kaleme aldığım yazıma bu link üzerinden ulaşabilirsiniz.

Doğal olarak işin sadece felsefesine hakim olmak, karın doyurucu nitelikte olmayabilir. Sonuç itibari ile programcı günlük iş hayatında bir takım somut araç, gereç, dil ve diğer yapılar ile irtibat halindedir. Somut yapılarda meydana gelen değişiklikleri programcı nasıl takip etmelidir?

Bu sorunun cevabını piyasa belirlemektedir. Piyasa ne isterse, onu alır. Bu yüzden somut konuların öğreniminde programcı piyasa ihtiyaçlarına paralel bir öğrenim haritası oluşturmalıdır. Örneğin tasarım prensip ve şablonlarının somut bir implementasyonu olan spring çatısı piyasada çok rağbet gören bir çatı haline gelmiştir. Bunun gibi nesneye yönelik programlama tekniklerinin uygulanabildiği java dili aynı konumdadır. Bir ara hype olan ve artık adından fazla bahsedilmeyen scala popülerliğini yitirmek üzeredir. Piyasa kendi ihtiyaçları doğrultusunda somut yapıların gelişim ve kullanımına yön vermektedir. Programcının yapması gereken tek şey, piyasa ihtiyaçlarini takip etmek ve kişisel gelişim yol haritasını buna göre adapte etmektir. Piyasanın sahip olduğu ihtiyaçları takip etmek için güncel iş ilanlarına bakmak yeterli olacaktır.

Bunun yanı sıra programcının yazılım sahasında oluşan trendleri iyi analiz ederek, gitmek istediği yönü adapte etmesi, ileride yazılımcı olarak bulunduğu mevkiyi koruması açısından faydalı olacaktır. Bu tür trendler yine piyasa ihtiyaçları doğrultusunda oluşma eğilimi göstermektedirler. Örneğin günümüzde javascript bazlı frontend projelerinde, kodun bakım ve geliştirilebilirliğini artırmak adına backend yöntemlerini kullanma eğilimi oluşmaya başlamıştır. Bunun en güzel örneğini Angular çatısı oluşturmaktadır. Bunun yanı sıra fullstack developer isminde yeni bir yazılımcı türü aranmaktadır. Proje sahipleri giderleri azaltmak adına hem frontend hem backend yazılım yapabilecek nitelikte yazılımcılar aramaktadırlar. Bu trendleri takip etmeyen bir yazılımcı, kısa zaman sonra sadece bir konuda uzman oldugu için işsiz kalma sorunu ile karşı karşıya kalabilecektir

Kanımca yazilim sektöründe oluşan teknolojik balonun büyüklüğü yazılımcıları tedirgin edecek boyutta değildir. Bu balon çok büyük gibi görünsede, büyük bir bölümünü somut yapılar oluşturmaktadır. Yazılımcılar işin temelinde yatan prensiplere ağırlık verdikleri ve piyasada olup, bitenleri takip ettikleri sürece, yeni gelişmelere her zaman ayak uydurabilme konumunda olacaklardır.


EOF (End Of Fun)
Özcan Acar

Neden Programcılık Harici İşlerle Uğraşmak Daha İyi Bir Programcı Olmayı Sağlar

Programcılığın çok büyük bir bölümünü basmakalıp işler oluşturur. Bu zamanla programcının belli kalıpların dışına çıkmasını zor hale getiren bir durumdur. Belli kalıplar çerçevesinde düşünmeye başlamak, yaratıcı ve çözüm üretici olmanın önündeki en büyük engeldir. Bu kalıpları yıkmanın ya da en azından onların görüşü engellemeyecek şekilde aşılabilmelerinin tek yolu programcılık harici iş ve projelere zaman ayırmaktan geçmektedir.

Çözüm üretme sürecindeki en önemli faktör, çözüm arayanın hangi büyüklükte bir tecrübe ve bilgi birikimine sahip olduğudur. Yapılan tecrübelerin ve edinilen bilgilerin geniş bir yelpazeyi kapsamaları da büyük önem taşımaktadır. Sadece bu durumda çözüm üretme sürecinde problemlere başka perspektiflerden bakma yetisi var olacaktır. Değişik alanlarda edinilmiş tecrübeler ve bilgi birikimi genel resmi görmeyi kolaylaştırır. Bu sebepten dolayı programcıların değişik alanlara yönelmeleri, onların günlük işlerinde daha kolay çözümler üretebilen ve bu çözümleri hayata geçirebilen bireyler olmalarını sağlayacaktır.

Birçok programcıda “ben bu görevin altından kalkabilir miyim” kuşkusuna rastlamak mümkündür. Bunun ana sebebi tecrübe, bilgi ve özgüven eksikliği olabilir. Her yeni görevde bu kuşkunun oluşmaması için bireyin programcılık sahasında kişisel gelişimine öncelik vermesi gerekmektedir. Mevcut teknoloji genişliğine ve bilgi birikimine bakıldığında çok geniş çaplı bir çalışma alanı olarak görünse de, programcılık kendi içinde kullanılan yöntemler açısından sınırlıdır. Örneğin yazılım projelerinin çok büyük bir bölümü nesneye yönelik programlama teknikleri ile geliştirilmektedir. Yazılımcılın nesneye yönelik programlama konseptlerini başka diller aracılığı ile uygulaması çok uzun bir zaman almamaktadır. Aynı şey veri tabanları, uygulama sunucuları ve test yöntemleri için de geçerlidir. İster istemez uzun yıllardır aynı yöntemleri kullanan bir programcı yaptıklarının sınırlarına gelecek ve aynı şeyleri tekrar edecektir. Bu yazımın başında bahsettiğim kalıplar içinde düşünme sendromu baş göstermesi anlamına gelmektedir. Bunu aşabilmenin yolu programcılık harici kişisel projelerden geçmektedir.

Hangi tür kişisel projelerden bahsediyorum? Bu tür projelerin bireyi konfor alanından hemen çıkarıp, çok uzun bir süre öğrenim ya da panik alanında tutabilme kabiliyetine sahip olmaları gerekmektedir. Konfor alanı ile ilgili yazıma buradan erişebilirsiniz. Konfor alanı terk edilmedikçe, kişisel gelişimde bir ilerlemenin kaydedilebileceği beklentisi olmamalıdır.

Örnek bir kişesel proje şu özelliklere sahip olmalıdır:

  • Birey böyle bir projeyi tek başına yapabileceğini daha önce hayal bile etmemiştir.
  • Proje bireyi fiziksel ve ruhsal sınırlarına taşımalıdır.
  • Projenin somut bir çıktısı olmalıdır. Bu çıktının günlük hayatta kullanılabilir ya da günlük hayatın bir parçası olması faydalı olacaktır.
  • Proje geniş çaplı bilgi ihtiyacı doğurmalıdır.
  • Birey ilerleyebilmek için sürekli ihtisas ve araştırma yapmalı ve deneme yanılma yöntemi ile çalışmalarını sürdürmelidir.
  • Birey atılması gereken adımları kısa ve uzun vadede planlamak zorunda olmalıdır.
  • Proje bireyin vazgeçemeyeceği cazibede olmalıdır.

Bu özelliklere sahip kisisel bir projenin bireye kazandırdıklarını şu şekilde sıralabiliriz:

  • Daha önce hayal bile edemeyeceği bir konuda başarılı olması özgüvenini artıracaktır.
  • Karşılaştığı problemleri çözmek için azimli olması gerektiğini kavrayacaktır.
  • Başkalarının yardımını almakla birlikte, asıl sorumlu şahsın kendisi olduğunun bilincine varacaktır.
  • Başarısız olmasının bile ona yeni tecrübeler ve bilgiler kattığını anlayacaktır.
  • Fiziksel ve ruhsal sınırlarını tanıyacaktır.

Bu tanımlamaya göre söz konusu olamayacak projeler şunlardır:

  • Çiçek dikip, hergün onları sulamak.
  • Motosiklet ehliyeti yapıp, motosiklet sürmek.
  • ABC çatısını öğrenerek, web tabanlı adres defteri uygulaması geliştirmek
  • Spor yapmak, kitap okumak, sinemaya gitmek, blog yazmak.
  • Tatil yapmak.

Saydıklarım proje değil, eğlence türünde aktivitelerdir. Bu yüzden hobilerin birçoğu bahsetmiş olduğum kişesel proje kapsamına girmemektedirler. Ben gerçekten fikir olarak ilgilenmeye başladığınız da bile size yeni ufuklar açabilecek projelerden bahsediyorum. Heyecan verecek projeler. “Somut bir proje söyler misiniz” dediğinizi duyar gibiyim. Aklınıza gelmiyor mu muazzam bir proje? Bir arabayı sıfırdan tasarlamayı düşündünüz mü hiç? Ya da bir ev inşa etmeyi. Tamam bunlar biraz uçuk projeler olabilirler, lakin yine de azimle işe koyulanın, bu gibi projelerin üstünden geleceğini düşünüyorum.

Ben kendi projelerimden birkaç örnek vereyim.

Kısa bir zaman önce bir demir parmaklık projesine başladım. Yapım aşamasından izlenimleri aşağıda görmektesiniz.

a>

Daha önce demir bir parmaklığın nasıl yapıldığına dair hiçbir fikrim yoktu. Gözümün önünde sadece parmaklığın nasıl olması gerektiğine dair bir resim vardı. Yazılımcı kimliğinden gelen tasarımcı ve problem çözücü tarafıma güvenerek, bu projeye başladım. Bu proje sayesinde gazlı kaynak yapmayı öğrendim. Kaynak makinesini sipariş etmeden önce youtube ve diğer kaynaklardan saatlerce bilgi topladım. İşin inceliklerini öğrenmeye çalıştım. Parmaklığın taşıyıcı kolonlarını mevcut bir beton duvara yerleştirebilmek için betonu kestim ve kolon taşıyıcılarını gömmek için elli santim derinlikle delikler açtım. Kolonları bu taşıyıcılara kaynak yaptım. Kolonlar için açtığım beton bölümleri tekrar hazır beton aracılığı ile kapattım. Kolonların alt kısımlarına led lambalar takabilmek için kablolar çektim ve demir kolonlara yuvalar açtım. Sabahları çalışmaya başladım ve güneş batmaya yakın bitap düştüm. Günlerce böyle çalıştım. Beni iten her zaman kafamdaki bitmiş parmaklığın son hali oldu. Kendime projenin hiçbir safhasında acaba ben bunu yapabilir miyim sorusunu sormadım. Karşılaştığım her sorunu yeni cözümler üreterek, aşmaya çalıştım. Azmin ne anlama geldiğini yeniden keşfettim. Problem çözerken böl ve yönet yönteminin ne kadar verimli olduğunu anladım. Fiziksel olarak çok yorulmuş olsam bile, sorumluluk bende olduğu için projeyi yarım bırakmadım.

Bu kadar şeyin programcılıkla hiçbir alakası yok, haklısınız. Ama karşılaştığım bir sonraki problemi kafamdaki bu proje sayesinde daha da büyüyen sinaps kitlesi ve oluşturdukları bağlantılar sayesinde daha kolay çözeceğimden eminim. Programcının asıl sermayesi işte yeni tecrübeler sonrasında oluşan sinapslar ve çoğalan sinaps bağlantıları. Her yeni bir ihtisas alanı onların sayılarını artıracak ve sizin çözüm bulmanızı kolaylaştıracaktır.


EOF (End Of Fun)
Özcan Acar

Zaman Eksenindeki Teknolojik Fay Hatlarının Programcılar Üzerindeki Etkileri

Programcılık gibi bilgi güdümlü mesleklerin bir dejavantajı bulunmakta. Bu tür meslekler sadece bilgiyi taşıyanı yanlarında geleceğe taşırlar. Bilgi de öyle bir kitap karıştırma ile edinilecek bir şey değildir. Çoğu bilgi daha önce edinilmiş bilgiyi temel alır. Yani bilgilenme süreci yıllarca süren ve sağlam bilgisel temellere ihtiyaç duyan bir yapıdır.

Bilginin değeri ona duyulan ihtiyaç ile tartılır. Bu ihtiyaç ise kullanıcısının güncel ihtiyaçları ile doğru ortantılıdır. Örneğin bugün Java dilinin revaçta olmasının tek sebebi, birçok proje sahibinin bu dili tercih etmesidir. Proje sahipleri sahip oldukları gereksinimlerin yani ihtiyaçların en hızlı ve doğru şekilde Java ile tatmin edilebileceğini düşünmektedirler. Bu Java ve sahip olduğu bilgi ekosistemine bugünkü tanıdığımız değeri sağlamaktadır. Java’nın sahip olduğu konum kalıcı mıdır? Değildir! Neden değildir? Çünkü proje sahiplerinin gereksinimleri de piyasa güdümlüdür. Proje sahipleri her zaman piyasa rekabetleri güçlenecek şekilde hareket ederler. Bu onların dogma olmadan teknoloji ve bilgi seçimi yaptıkları anlamına gelmektedir. Yani bugün Java ise, yarın bu başka bir şey olabilmektedir.

Bunun yanı sıra zaman ekseninde bazen teknolojik kırılmalar oluşur. Teknolojik fay hatları olarak isimlendirdigim bu yapılar yeni teknolojilerin ortaya çıkmasını ve eski teknolojilerin tarihe karışmasını sebep olurlar. Bunun en güzel örneğini motorlu araçların icadı teşkil etmektedir. At gücü ile çekilen araçlar ve bu araçların oluşmasını sağlayan bilgi çok kısa bir zamanda hükmünü yitirmiştir.

Özellikle günümüzde teknolojik fay hatlarının en büyük destekçisi piyasa rekabetidir. İnsanlık tarihinin en büyük buluşları hayatı daha kolaylaştırmak ve mevcut ihtiyaçları tatmin etmek için vücut bulmuşlardır. Piyasa aktörleri bu doğrultuda rekabette öne geçmek amacıyla teknoloji fay hatlarının en büyük tetikçileri haline gelmişlerdir.

Teknolojilerin çok hızlı şekilde geliştiği bir çağda yaşıyoruz. Bu bilginin yarı ömrünün çok daha kısaldığı yani çok daha hızlı eskidiği anlamına gelmektedir. Proje sahiplerinin piyasa güdümlü olup, işlerine geldiği şekilde mevcut teknolojileri seçmelerini, teknolojik fay hatlarının çok çabuk yeni teknolojiler doğurmalarını ve bilginin yarı ömrünün düşmesini göz önünde bulunduracak olursak, programcı olarak çalışan kesimi önümüzdeki zamanda ne beklemektedir? Bu sorunun cevabını somut bir örmek üzerinde bulmaya çalışalım.

Şimdi kırklarına gelmiş bir programci hayal edelim. Böyle birisi büyük bir ihtimalle çoluk, çocuğa karışmış ve sorumluluk sahibi birisi olmuştur. Ev yaptırmış ya da satın almıştır. Araba almıştır, onu almıştır, bunu almıştır yani tam anlamıyla tüketim çılgınlığı kültürünün bir parçası haline gelmiştir. Bu şahsın kişisel gelişim haricinde her şey ile kafası dolup, taşmıştır. Bilginin yegane anahtarının kişisel gelişim çabaları olduğunu düşünecek olursak, bu şahsin kendi mesleki geleceği açısından ne kadar zor bir pozisyonda olduğunu görmekteyiz, değil mi? Bu kısmı somut bir örnekle detaylandırmak istiyorum.

Bahsettiğimiz şahsın iyi bir programcı olduğunu düşünecek olursak, mevcut yetileri ve bilgisi güncel gereksinimleri tatmin etmek için yeterli seviyede olacaktır. Kişisel gelişimine yatırım yapacak zamanı bulamayan bu şahıs mevcut bilgisi ile bir sonraki teknolojik depreme kadar mesleğini yapabilecektir. Böyle depremlerden bir tanesi son zamanlarda sessizce oldu ve çoğu programcı bu depremin farkına bile varamadı. Neydi gerçekleşen bu deprem? Tek çekirdekli sistemlerin programlanmasından çok çekirdekli sistemlerin programlanmasına geçiş. Bu deprem ile her şey yerle bir oldu. Proje sahiplerinin gereksinimleri değişti. Birkaç çekirdekli sistemleri programlamakta zorluk çeken biz programcılar, binlerce çekirdeği olan bir sistemi nasıl programlayabiliriz? Kişisel gelişimimize katıksız ve tavizsiz devam ederek.

Kendimden bir örnek vereyim. Yirmi sene önce tekno dinlerken, ebeveynlerimin bu müzik türüne hoş bakmamalarına anlam veremezken, aynı saşkınlığı günümüzün çocuk ve gençlerinin dinlediği müzik türlerine olan yabancılığımda yaşıyorum. Benim anlam veremediğim, kulağıma hoş gelmeyen, beynimin dinlerken hoşnut olmadığı, oluşumunu takip edemediğim ve oluşumunun farkında bile olmadığım yeni bir müzik kültürü oluşmuş. Yani birileri kültürel bir fayı tetiklemiş, bir kültürel deprem olmuş, ben altında kalmışım ve sudan çıkmış balığa dönmüşüm. Bu konudaki hislerimi kısaca bu şekilde ifade edebilirim.

Böyle bir gelişim benim mesleki geleceğim için bir önem taşımıyor. Lakin teknolojik bir fayın tetiklenmesi benim mesleki sonumu getirebilir. Bu tür teknolojik depremler beraberlerinde çok yeni piyasa gereksinimleri ve gereksinimleri tatmin edecek teknolojiler getirirler. Bunu bir fayton tamircisi iken motorun icadı ile motor teknisyeni olmak zorunda kalan birisi ile kıyasladığımızda, durumun ne kadar ciddi olduğunu kavrayabiliriz. Fayton tamircisinin motor teknisyeni olma şansı var. Lakin bu zaman, bilgi ve azim isteyen bir iş. Tek çekirdekli bir sistemi programlayan bir programcının bin çekirdekli bir sistemi programlayabilmek için kat etmesi gereken mesafe çok fazla. Bu sıçrama sadece yıllarca kişisel gelişim sayesinde edinilen bilgi birikimi ile sağlanabilir. Yeni teknolojik depremler olmadan önce bilgi binasının sağlam temeller üzerine inşa edilmesi gerekiyor. Binanın duvarları taş üzerine taş, yani bilgi üzerine bilgi konularak, sağlam örülmeli ve depreme hazır hale getirilmelidir. Teknolojik deprem olduğunda yani yeni nesil programcılara ihtiyaç duyulduğunda, sadece bilgi binası ayakta kalan programcılar ihtiyaç duyulan gereksinimlere cevap verebilecek durumda olacaklardır, çünkü her şeyleri ile hazır durumdadırlar ve istenilen yolda devam edecek yeti ve bilgiye sahiptirler. Peki bahsi geçek örnek programcının durumu ne olacaktır? Kendisi ne yazık ki hayat meselelerinin kurbanı olup, kişisel gelişimine yatırım yapamadığı için teknolojik depremin altında kalacak ve can verecektir. Hiçbir dikili taşı kalmadığı için devam etmesi mümkün değildir. Onun haberi olmadan teknolojik devrim olmuş, sistem değişmiştir.

Bu noktada deprem sonrasında tekrar ayağa kalkarak, meslek hayatıma yeni koşullarda devam edebilirim diyenler olacaktır. Bunun neden bu kadar kolay olmadığını bir örnekle açıklamak istiyorum.

Bir assembly programcısına bir C++ ya da Java hotspot derleyicisinin oluşturduğu assembly kodunu gösterelim. Birilerinin neden bu kadar verimsiz ve kötü assembly kodu yazdığına kesinlikle anlam veremeyecektir, çünkü kendisi bu kodu assembly dilinde çok daha kısa ve verimli olarak yazabilecektir. Bu sebepten dolayı yüksek dillerin kullanımını reddedecektir. Bizim de neden C++ ya da Java dilinde kod yazmanın daha verimli sonuçlar doğurduğunu kendisine anlatabilmemiz mümkün değildir, çünkü meydane gelmiş olan teknolojik deprem assembly programcısının yüksek dillere olan ihtiyacı görmesini engellemektedir.

İki teknolojik deprem arasındaki zaman dilimi kendi ideoloojisi ile o zamanda yaşayanları zihinsel olarak yoğurur. Buna dogmatik bir terbiye diyebiliriz. Bu belli bir şeyleri görmek için yapılmış gözlükler ile dünyaya bakmak gibi bir şeydir. Zihin zaman içinde başka şeyleri göremez hale gelir ya da onların varlığını reddeder. Assembly programcısı örneğinde bu yüksek dillere olan ihtiyacın göz ardı edilmesidir. Doğrudan assembly kodu yazmanın çok daha verimli olduğunu bilen bir zihne yüksek bir dilde nesneye yönelik programlamanın daha verimli sonuçlar doğuracağını anlatamazsınız. Aynı şey cobol programcıları için de geçerli. Assembly ve cobol programcıları ile yüksek dil ihtiyacı ile oluşan teknolojik deprem sonrasında yetişen programcı arasında çok büyük bir kafa yapısı (mindset) farklılığı bulunmaktadır, çünkü her teknolojik deprem zamanla kendi kafa yapısını, düşünüş tarzını ve bakış açısını oluşturmaktadır. İşte eski şartlarda, eski bilgi ve eski kafa yapısı ile programcı olarak devam etmeninin önündeki en büyük engeli bu oluşturmaktadır.

Şimdi bizim tertip programcılara bir göz atalım. Günümüzün programcıları son 20 yılın en kabul gören nesneye yönelik programlama tekniği ile yetişti. İmperatif programlama tarzı ile çok çekirdekli sistemlere hükmedemeyeceğimizi artık sağır sultan bile duymuş durumda. Bu işin yolu fonksiyonel programlamadan geçiyor. Ama nesneye yönelik programlama teknikleri ile büyümüş bir programcı için fonksiyonel programlama çok başka bir dünya. Eline bir kitap alıp, o dünyaya giriş yapmak isteyen bir programcı bunu çok iyi bilir. Fonksiyonel programlama tekniklerini öğrenmek için çektiğimiz çile az değil. Neden? Çünkü kafamız almıyor. Meslek hayatımızın çok büyük bir kısmını imperatif programlar yazarak geçirdik. Artık kafamızda belli kalıplar oluştu. Kınadığımız assembly ya da cobol programcısından hiç farkımız yok. Onların durumuna düştük.

Bu durumu aşabiliriz. Lakin hemen şimdi bu yeni teknikleri öğrenmeye ve uygulamaya başlamamız gerekiyor, çünkü bunun talebi piyasada oluşmaya başladı yani bahsettiğim deprem ve artçılar olmaya başladı. Eğer şimdi öğrenmeye başlamaz isek, deprem sonrasında çok başka bir dünyaya uyanacağız ve gidişata ayak uydurmak için hiç zamanımız olmayacak. Bilgi edinme işi bugünden yarına olan bir sey degil. Uzun vadeli planlanlası ve uygulanması gerekiyor.

Yarı yolda kalmak istemiyorsak, sürekli ve tavizsiz kişisel gelişim uygulamamız gerekiyor. Bunu beceremeyenler iyi programcılar da olsalar, sadece geride kalmış bir dönemin iyi programcıları olarak kalırlar.


EOF (End Of Fun)
Özcan Acar

Geri Dönüşü Olmayan Ünvanlar

İkibinli yılların başlarında bir konferansda eski başbakanlarımızdan Tansu Çiller’e etrafındaki korumalarının ve çalışma arkadaşlarının sayın başbakanım diye hitap ettiklerine şahit olmuştum. Başbakanlık görevi on sene geride kalmış bir şahıs için neden başbakan ünvanı kullanılmaktaydı? Nedenini tam olarak hala bilmemekle birlikte, bunun nezaket kuralları çercevesinde, ünvan sahibi şahsı onure etmek ve onu eski ünvanı ile bir zamanlar sahip olduğu mertebede görme amaçlı kullanıldığını düşünüyorum. Tenzili rütbe görmenin hoş görülmediginden de anlaşıldığı gibi bir şahsa sahip olduğu en yüksek ünvanın altında bir ünvanla hitap etmek ayıp kaçıyor olabilir.

Sevgili meslaktaşım Aykut Taşdelen buradaki paylaşımında yazılımcıların neden senior gibi ünvanlar taşıdıklarını, bunun her proje için geçerli olamayabileceğini yazmış. Kendisine katıldığım ve bu duruma düştüğüm için bu yazıyı kaleme alıyorum.

Kim senior programcıdır başlığında daha önce bir yazı yazmıştım. Senior kelimesi bir sıfat ve programcının sahip olduğu bilgi ve tecrübeyi tanımlamakta yardımcı nitelige sahip. Bu sıfatı programcılar kendilerine layık gördüklerinde kullanırlar yani hiç kimse kalkıp programcıya “sen şimdi senior programcısın” demez, programcı “ben artık senior programcıyım” der ve bu ünvanı kullanmaya başlar. Bir kere kullanmaya başladıktan sonra da bu böyle kalır. Programcı artık senior programcı olmuştur. Bu programcıya junior programcı ya da sadece programcı olarak hitap etmeye kalkarsanız, karşı tarafı kızdırmış olabilirsiniz.

Senior dönüşü olmayan bir ünvandır. Kimileri kendisine iki sene sonra bu ünvanı uygun görürken, kimileri on sene sonra buna layık olduklarına kanaat getirirler. Burada tanımlı bir ölçü ya da kural mevcut değil. Ben, buna kendim de dahilim, senior programcı ünvanından daha alt bir ünvana tenzili rütbe eden görmedim. Yazımın başlığında da belirttiğim gibi, bu geri dönüşü olmayan bir ünvan ve açıkcası pek de gerçekleri yansıtmıyor. Neden mi? Kendimden örnek vereyim…

Neredeyse yirmi yıla yakın bir süredir programcı olarak çalışıyorum. Ne zamandan beri senior programcı ünvanını kullandığımı Xing profilime bakınca hatırladım. 2003 senesinin ortalarından beri bu ünvanı taşıyorum ve açıkcası bunu hiç sorgulamadım, taki Aykut Taşdelen’in LinkedIn’deki paylaşımını görene kadar. Büyük bir ihtimalle sorgulamaya da gerek görmezdim, eğer bahsi geçen duruma düşmemiş olsaydım. Nedir bu durum? Açıklamaya çalışayım.

Son altı aydır Alman Telekom bünyesindeki QIVICON akıllı ev projesinde programcı olarak çalışıyorum.

Beni senior programcı olarak işe aldılar. İş görüşmelerinde istenilen bilgi seviyesine sahip olduğum kanısının oluşması, ön elemeleri geçmemi sağladı. Ama işe alınmamın ana sebebi senior programcı olmam değil, kendi evimde uygulamış olduğum akıllı ev projesidir. Bu beni diğer iş başvurusu yapan programcılardan ayıran en büyük özellikti.

Bulunduğum ortamda Java/C/C++ gibi dillerde embedded programlama yapılıyor. Küçük IOT cşhazların programlanması ve sisteme entegre edilmesi çok eğlenceli bir uğraş. Lakin son altı aydır şimdiye kadar hiçbir projede muhattap olmadığım konularla ugraşma zorunluluğu doğdu. Bazı konulara hiç hakim olmamam beni çok hızlı bir şekilde tenzili rütbeye götürdü. Birden kendimi ne yapacağımı bilemediğim, benden istenileni anlamadığım bir konumda buldum. Artık junior programcıydım, bildiğin tecrübesiz bir programcı! Ama hayatın tadının panic zone olmadan çıkmayacağına inananlardan birisi olarak, junior/senior programci olarak işime devam ediyorum. Hakim olduğum konularda senior, bilmediğim ve yeni ögrendiğim konularda junior programcıyım ve bundan daha güzel bir kombinasyon olamaz. Bir anda benden on yaş küçük, embedded programlama uzmanı bir programcının çırağı durumuna düştüm. O senior programcı, ben onun yanında junior programcıyım. İş Java’ya döndüğünde, roller değişiyor :)

Hülesai kelam, Aykut’un bahsettiği durumu canlı, canlı yaşayan birisi olarak, programcıların kendilerine verdikleri ünvanların bir şey ifade etmedikleri kanısındayım. Ama bundan daha da kötüsü, programcının bu ünvanlara kendisini inandırarak, belli bir seviyeye geldiğini düşünmesidir. Bu bir nevi çıkmaz ve geri dönüşü olmayan bir yol ve düşünce tarzıdır. Kişisel gelişimin önündeki en büyük engellerden birisidir. Programcıyı uzmanlığa götürür. Nitekim birçok programcı da senior sıfatı yerine uzman sıfatını kullanılabilir. Senior ünvanını kullanan programcıların çoğu bir takım konular hakkında uzman olduklarını ifade etmektedirler.

Kişisel görüşüm gidilen istikametin uzman/senior değil, usta yazılımcı yönünde olmasıdır. Usta programcı zamanı gelince tekrar çırak olma fikrine açık iken, çünkü sadece bu şekilde kendisine yeni bir uzmanlık alanı açabileceğini ve kişisel gelişimini ileriye götürebileceğini bilmektedir, uzman yazılımcı mevcut mevkiyi koruma ile meşguldür. Yazılımda ileriye gitmenin bir yolu varsa, o da tekrar, tekrar çırak olarak baştan başlayabilmek ve kendisine bunu layık görebilmektedir.

Senior ünvanı tamamıyla yanlış kullanılan bir ünvan değildir. Programcılar kendi aralarında çok kısa bir zamanda kimin ne kadar iyi olduğunu anlayabilme yetisine sahip iken, işverenler için durum farklıdır. İşverenler belli kriterler doğrultusunda seçim yapmak zorundadırlar. Burada eğitim seviyesi, sertifikasyon ve senior gibi ünvanlar ön elemeyi kolaylaştıran etkenlerdir. Bu açıdan bakıldığında programcının senior ünvanını kullanmasında bir sorun bulunmamaktadır.

Ünvanlar taşıyıcılarının gözlerine perde çekme ve mevcudiyetten daha iyi olduklarını hissettirme kabiliyetine sahiptirler. Önemli olan bunun farkında olabilmektir.


EOF (End Of Fun)
Özcan Acar

JVM Nasıl Çalışır Yazı Serisi – Java Just In Time Compiler (JIT) Nasıl Çalışır?

Java’yı çoğu programcı yorumlanan (interpreted) dil olarak bilir. Java’nın yavaş olduğu efsanesi de başlangıcını da burada bulur. Bytekod olarak derlenen Java sınıfları Java sanal makinesi (Java Virtual Machine – JVM) bünyesinde yorumlanır. Tek derleme işlemi Java sınıflarının bytekoda dönüştürülmesi esnasında yapılmaz. JVM bünyesinde de bytekodun makine koduna dönüştürüldüğü bir derleme gerçekleştirilir. Bu işleme Just in time (JIT) compilation ismi verilmektedir. Bu yazımda JVM bünyesinde kodun nasıl derlendiğini örnekler üzerinden aktarmak istiyorum.

Derleme (compilation) sürecini yüksek dillerde yazılan program kodlarının işlemcinin (CPU) anladığı makine koduna dönüştürüldüğü ve bu şekilde CPU üzerinde koşturulabilir hale getirildiği işlem olarak tanımlayabiliriz. Derleme işlemini gerçekleştiren programları yani derleyicileri kabaca iki guruba ayırmak mümkün. Bunlar:

  • Ahead of time compiler (AOT)
  • Just in time compiler (JIT)

C/C++ gibi diller AOT tarzı derleciyiler kullanırlar. AOT derleyicileri program kodunu programın koşturulmasından önce kullanılan donanımın anladığı makine koduna dönüştürürler. JIT ise Java gibi dillerde uygulamanın çalışması esnasında (runtime) kazanılan performans verileri doğrultusunda uygulanan derleme tekniğidir. JIT devreye girmeden önce kod bytekod olarak yorumlanır. AOT ile derlenen uygulamalar JIT ile derlenen uygulamalara kıyasla daha hızlı çalışırlar, çünkü kod tamamıyla işlemcinin anladığı şekilde derlenmiştır ve yorumlanmadan doğrudan işlemci bünyesinde koşturulur. Buna karşın AOT ile derlenen uygulamalar derlendikleri platformlara bağımlıdırlar ve başka donanım türlerinde koşturulamazlar. Bunun için yeniden derleme işleminin gerçekleştirilmesi gerekmektedir. JIT derleyicileri platformdan bağımsız çalışırlar.

Java kodları javac ile derlenir. Bu derleme işlemi sonucunda bytekod oluşur. Aşağıdaki örnekte HelloWorld sınıfının nasıl derlendiğini ve derlenen sınıfın hangi bytekodu ihtiva ettiğini görmekteyiz.

[source language=”java”]

C:\>java HelloWorld

public class HelloWorld {

public static void main(String[] args){
System.out.println("Merhaba Dünya!");
}
}
[/source]

[source language=”java”]
C:\>javap -c HelloWorld.class

Compiled from "HelloWorld.java"
public class HelloWorld {
public HelloWorld();
Code:
0: aload_0
1: invokespecial #1 // Method java/lang/Object."<init>":()V
4: retur

public static void main(java.lang.String[]);
Code:
0: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;
3: ldc #3 // String Merhaba D?nya!
5: invokevirtual #4 // Method java/io/PrintStream.println:(Ljava/lang/String;)V
8: return
}
[/source]

Bir Java uygulaması JVM bünyesinde çalışır hale getirildiğinde, yukarıda yer alan bytekod JVM tarafından yorumlanmaya başlar. JVM bu durumda “interpreted” modundadır ve bytekodunu satır, satır yorumlar. Bu haliyle JVM bir durum makinesidir (state machine).

JVM bytekodu yorumlarken kodun sık kullanılan alanları hakkında istatistiki bilgiler toplar. Bu şekilde örneğin hangi metodun hangi sıklıkla koşturulduğunu ölçmek mümkündür. JVM parametreleri aracılığı ile JIT in derleme işlemine geçtiği barajlar tanımlanabilir. Örneğin bir metot on bin kez koşturulduktan sonra, bu metodun JIT tarafından derlenmesi ve bytekoddan makine koduna dönüştürülmesi sağlanabilir. Bu değeri örneğin bin olarak değiştirmek de mümkündür.

JIT ile derleme işlemi gerçekleştikten sonra JVM “compiled” moduna geçer. Bu modda JVM işlemciye (CPU) has işlemleri (native direct operations) gerçekleştirir. Kod artık yorumlanmadığı için daha hızlı çalışmaktadır. JVM bir state machine olmaktan çıkmış ve artık doğrudan işlemci üzerinde işlem yaptığından bir native register machine haline gelmiştir.

JVM in yorumlama, derleme ve uygulamayı koşturma esnasında içinde bulunduğu durumları aşağıdaki diyagramda görmekteyiz.

[source language=”java”]

(1) Interpreted –> (2)Profiling
^ |
| |
| v
(4) Deoptimize <– (3)JIT Compiled

[/source]

JVM başlangıçta interpreted (1) yani bytekodu yorumlayıcı durumundadır. Kod yorumlanırken JVM tarafından profiling (2) tekniği ile ölçümler gerçekleştirlir. Bu veriler baz alınarak kodun hangi bölümlerinin JIT ile derleneceği kararı alınır ve kod derlenir. JIT derleme (3) işlemi esnasında tüm bilgilere sahip olamayacağından bazı varsayımlarda bulunur ve spekülasyona dayalı kararlar neticesinde derleme işlemini gerçekleştirir. Bazı şartlar altından bu varsayımlar geçerliliklerini kaybettiklerinden, derlenen kod işe yaramaz hale gelir ve bir kenara bırakılarak (4), yeniden yorumlama (1) moduna geçilir. Bu döngü uygulamanın hayatı boyunca devam eder. Belli bir kullanım süresinden sonra kod hakkında toplanan bilgiler yeterli olduğundan, kodun çok kullanılan alanları derlenmiş olur ve bu da Java uygulamalarını C/C++ uygulamaları gibi hızlı kılar. JIT derleyicisi bir AOT derleyicisine nazaran daha fazla runtime istatistik bilgisine sahip olduğundan, kodun işlemci için optimize edilme işlemi daha verimli sonuçlar verir. Bu yüzden Java uygulamalarının C/C++ uygulamalarına nazaran yer yer daha hızlı çalıştığı söylenebilir. Diğer bir yazımda JIT tarafından uygulanan kod optimizasyon tekniklerine değineceğim.

Aşağıda yer alan Calculator sınıfı aracılığı ile JIT tarafından derleme işleminin nasıl yapıldığını inceleyebiliriz.

[source language=”java”]
package com.kurumsaljava.jvm.jit;

public class Calculator {

public static void main(String[] args) {
int max = Integer.parseInt(args[0]);
System.out.println(addAll(max));
}

private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result = add(result, i);
}
return result;
}

private static int add(int result, int i) {
return result + i;
}
}
[/source]

JIT tarafından yapılan derleme işlemini takip edebilmek için -XX:+PrintCompilation parametresini aşağıdaki şekilde kullanmamız gerekiyor. Bunun yanı sıra -server parametresinin kullanılması, JIT derleyicisinin daha agresif bir şekilde derleme işlemine girişmesini mümkün kılacaktır.

[source language=”java”]
c:\>java -server -XX:+PrintCompilation com.kurumsaljava.
jvm.jit.Calculator 100000
[/source]

Calculator sınıfı 1 – 100000 arasındaki rakamları toplamakta ve neticeyi ekranda görüntülemektedir. Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
1 80 1 3 java.lang.Object::<init> (1 bytes)
2 82 2 3 java.lang.String::hashCode (55 bytes)
3 83 3 3 java.lang.String::charAt (29 bytes)
4 86 4 3 java.lang.Character::toLowerCase (9 bytes)
5 86 5 3 java.lang.CharacterData::of (120 bytes)
6 86 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
7 86 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
8 86 8 3 java.lang.String::indexOf (70 bytes)
9 87 9 3 java.util.Arrays::copyOfRange (63 bytes)
10 87 10 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
11 88 11 n 0 java.lang.System::arraycopy (native) (static)
12 88 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
13 88 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
14 88 14 s 3 java.lang.StringBuffer::append (13 bytes)
15 89 15 3 java.lang.String::length (6 bytes)
16 89 16 1 java.lang.Object::<init> (1 bytes)
17 89 1 3 java.lang.Object::<init> (1 bytes) made not entrant
18 89 17 3 java.lang.String::getChars (62 bytes)
19 91 18 3 java.lang.Math::min (11 bytes)
20 97 19 3 sun.misc.FDBigInteger::mult (64 bytes)
21 97 20 3 sun.misc.FDBigInteger::<init> (30 bytes)
22 98 21 3 sun.misc.FDBigInteger::trimLeadingZeros (57 bytes)
23 98 22 3 sun.misc.FDBigInteger::mult (44 bytes)
24 100 23 n 0 java.lang.System::nanoTime (native) (static)
25 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
26 100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
27 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
28 105 26 3 java.lang.AbstractStringBuilder::append (50 bytes)
29 110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
30 111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
31 113 29 3 sun.nio.cs.SingleByte$Encoder::encode (32 bytes)

704982704
[/source]

Birinci kolonda satır numaralarını, ikinci kolonda JVM in işlem için kullandığı zamanı (millisecond), üçüncü kolonda derleme sırasını, dördüncü kolonda derleyici seviyesini, beşinci kolonda derlenen metodu görmekteyiz. Bizim için ilginç olan derleme işlemleri aşağıda yer almaktadır:

[source language=”java”]
25 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
26 100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
27 100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
29 110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
30 111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
[/source]

25. ve 27. satırlarda add() metodunun derlendiğini ve derleme neticesinin 4 byte büyüklükte olduğunu görmekteyiz. 27. satırda “made not entrant” ibaresi yer almakta. Bu JIT in kullandığı varsayımların geçerliliğini yitirdiği ve derlenen kodun devre dışı kaldığı anlamına gelmektedir. 27. satırda JVM deoptimizasyon moduna geçerek, metodun yeni bilgiler doğrultusunda yeniden derlenmesinin önünü açmaktadır.

Derleme sırasının düzenli olmadığını görmekteyiz. Bu JIT derleyicisinin arka planda thread bazlı çalıştığının göstergesidir.

26. satırda add() metodu tekrar derlenmekte ve işlemci üzerinde makine kodu olarak koşturulabilir hale getirilmektedir. Ayrıca 29. ve 30. satırlarda addAll() metodunun da derlendiğini görmekteyiz. 29. satırda yer alan % isaretinin ne anlama geldiğine birazdan değineceğim.

Daha önce de bahsettiğim gibi JIT derleme işlemi esnasında kodu mümkün mertebe daha hızlı çalışabilsin diye optimize etme gayretindedir. Derleyiciler tarafından yapılan bu optimizasyonların başında method inlining gelir. Bu derleme esnasında bir metot gövdesinin kullanıldığı metota kod olarak eklenmesi anlamına gelmektedir. Örneğin aşağıda yer alan addAll() ve add() metotları JIT tarafından şu şekilde optimize edeilecektir:

[source language=”java”]
private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result = add(result, i);
}
return result;
}

private static int add(int result, int i) {
return result + i;
}
[/source]

JIT tarafından optimize edilen kod şu yapıpdadır:

[source language=”java”]
private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
result += i;
}
return result;
}
[/source]

Görüldügü gibi JIT add() bünyesindeki kodu birebir addAll() metoduna taşıdı. Bu şekilde add() metoduna geçmek için gerekli frame (bknz. JVM Stack Nedir ve Nasıl Çalışır? başlıklı yazım) oluşturma işlemi gereksiz hale geldiğinden, JVM kodu daha hızlı koşturulabilmektedir.

Method inlining işleminin gerçekleştiğini ispatlamak amacıyla Calculator sınıfını aşağidaki şekilde değiştirerek, tekrar koşturuyorum:

[source language=”java”]
public class Calculator {

public static void main(String[] args) {
int max = Integer.parseInt(args[0]);
System.out.println(addAll(max));
}

private static int addAll(int max) {
int result = 0;
for (int i = 0; i < max; i++) {
long start = System.nanoTime();
result = add(result, i);
long duration = System.nanoTime() – start;
if (i % 10000 == 0)
System.out.println("add execution took " +
((duration) / 1000.0d) + " µs");
}

return result;
}

private static int add(int result, int i) {
return result + i;
}
}
[/source]

Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
80 1 3 java.lang.Object::<init> (1 bytes)
82 2 3 java.lang.String::hashCode (55 bytes)
83 3 3 java.lang.String::charAt (29 bytes)
86 4 3 java.lang.Character::toLowerCase (9 bytes)
86 5 3 java.lang.CharacterData::of (120 bytes)
86 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
86 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
86 8 3 java.lang.String::indexOf (70 bytes)
87 9 3 java.util.Arrays::copyOfRange (63 bytes)
87 10 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
88 11 n 0 java.lang.System::arraycopy (native) (static)
88 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
88 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
88 14 s 3 java.lang.StringBuffer::append (13 bytes)
89 15 3 java.lang.String::length (6 bytes)
89 16 1 java.lang.Object::<init> (1 bytes)
89 1 3 java.lang.Object::<init> (1 bytes) made not entrant
89 17 3 java.lang.String::getChars (62 bytes)
91 18 3 java.lang.Math::min (11 bytes)
97 19 3 sun.misc.FDBigInteger::mult (64 bytes)
97 20 3 sun.misc.FDBigInteger::<init> (30 bytes)
98 21 3 sun.misc.FDBigInteger::trimLeadingZeros (57 bytes)
98 22 3 sun.misc.FDBigInteger::mult (44 bytes)
add execution took 1.579 µs
100 23 n 0 java.lang.System::nanoTime (native) (static)
100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
100 25 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
100 24 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
add execution took 0.0 µs
add execution took 0.395 µs
105 26 3 java.lang.AbstractStringBuilder::append (50 bytes)
add execution took 0.0 µs
110 27 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (75 bytes)
111 28 3 com.kurumsaljava.jvm.jol.Calculator::addAll (75 bytes)
add execution took 0.0 µs
113 29 3 sun.nio.cs.SingleByte$Encoder::encode (32 bytes)
add execution took 0.0 µs
704982704
[/source]

İlk on bin adet add() koşturulması neticesinde toplam koşturma süresi 1.579 µs dır. Akabinde kodun iki sefer derlendiğini ve koşma süresinin 0.0 µs şeklinde değiştiğini görmekteyiz. Bu değer add() metodu inline edildiği zaman oluşabilecek bir değerdir. Add() metodu JIT tarafından “made not entrant” yapıldıktan yani derlenen kod çöpe atıldıktan sonra bir sonraki on bin adet koşturulması 0.395 µs süresinde gerçekleşmektedir. Bu add() metodunun deoptimizasyon sonucunda tekrar yorumlanmaya başlandığının ispatıdır. Add() daha sonra tekrar derlenerek, koşturma zamanı sıfıra düşmektedir, çünkü JIT tarafından tekrar addAll() bünyesinde inline edilmiştir.

Bu arada addAll() metodunun ilk derlendiği yerde % işareti görmekteyiz. Bu JIT in derleme işlemini “On stack replacement” modunda yaptığı anlamına gelmektedir. On stack replacement ne anlama gelmektedir? JIT genelde çok kullanılan metotları birebir derleme eğilimindedir. Derleme işleminden sonra derlenen metodu kullanan diğer metotlar yeni makine koduna işaret edecek şekilde yeniden yapılandırılır. Bunu bir hashtable bünyesinde yapılan bir eşleme olarak düşünebiliriz. Tüm kullanıcı metotlar derlenen metoda işaret ederler. JIT in metodu derleyebilmesi için metodun stack frame ini açmamış yani koşuyor durumda olmaması gerekmektedir. Bu add() metodu bünyesinde mevcut olan bir durumdur. Bu metot yüz bin kez koşturulmaktadır ve JIT bu metodu derlemek için gerekli fırsatları değerlendirmektedir. Lakin addAll() metoduna baktığımızda, bu metodun sadece bir kez koşturulduğunu görmekteyiz. Buna rağmen addAll() metodu JIT için bir sicak alandır (hotspot) ve derlenmelidir, çünkü uygulama için gerekli zamanın çok büyük bir kısmı bu metot bünyesinde geçmektedir.

JIT sadece bir kez koşturulan ama derlenmeyi hak eden metotları on stack replacemant yöntemi ile derlemektedir. Bu yöntemde tüm metot derlenmemektedir. JIT sadece for döngüsünün başlangıcından, sonuna kadar olan bölümü derler ve for döngüsünü koşturan yorumlayıcının (interpreter) sahip olduğu stack frame i derlenen koda giriş noktası olarak kullanır. Bu şekilde uzun döngülerin de derlenmesi mümkün hale gelmektedir.

JIT tarafından yapılan method inlining işlemini -XX:+PrintInlining parametresi ile takip etmek mümkündür. Şimdi uygulamayı bu yeni parametre ile çalıştırarak, hangi metotların inlining yöntemi ile yok edildiğini inceleylim. Bu parametreyi kullanabilmek için -XX:+UnlockDiagnosticVMOptions parametresi ile gerekli JVM kanallarının açılması gerekmektedir. Bu sebeple Calculator sınıfını aşağıdaki şekilde koşturmamız gerekmektedir:

[source language=”java”]
c:\>java -server -XX:+PrintCompilation -XX:+UnlockDiagnosticVMOptions
-XX:+PrintInlining com.kurumsaljava.jvm.jit.Calculator 100000
[/source]

Ekran çıktısı şu şekilde olacaktır:

[source language=”java”]
65 1 3 java.lang.Object::<init> (1 bytes)
68 2 3 java.lang.String::hashCode (55 bytes)
68 3 3 java.lang.String::charAt (29 bytes)
@ 18 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
71 4 3 java.lang.Character::toLowerCase (9 bytes)
@ 1 java.lang.CharacterData::of (120 bytes) callee is too large
@ 5 java.lang.CharacterData::toLowerCase (0 bytes) no static binding
71 5 3 java.lang.CharacterData::of (120 bytes)
71 6 3 java.lang.CharacterDataLatin1::toLowerCase (39 bytes)
@ 4 java.lang.CharacterDataLatin1::getProperties (11 bytes)
71 7 3 java.lang.CharacterDataLatin1::getProperties (11 bytes)
72 9 3 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
72 8 3 java.util.Arrays::copyOfRange (63 bytes)
@ 16 java.lang.StringBuilder::<init> (7 bytes)
@ 3 java.lang.AbstractStringBuilder::<init> (12 bytes)
@ 1 java.lang.Object::<init> (1 bytes)
@ 20 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (62 bytes) callee is too large
@ 25 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (50 bytes) callee is too large
@ 29 java.lang.StringBuilder::append (8 bytes)
@ 2 java.lang.AbstractStringBuilder::append (62 bytes) callee is too large
@ 32 java.lang.StringBuilder::toString (17 bytes)
@ 13 java.lang.String::<init> (62 bytes) callee is too large
@ 35 java.lang.IllegalArgumentException::<init> (6 bytes) don’t inline Throwable constructors
@ 54 java.lang.Math::min (11 bytes)
@ 57 java.lang.System::arraycopy (0 bytes) intrinsic
73 11 n 0 java.lang.System::arraycopy (native) (static)
73 10 3 java.lang.String::indexOf (70 bytes)
@ 66 java.lang.String::indexOfSupplementary (71 bytes) callee is too large
73 12 3 java.lang.AbstractStringBuilder::append (29 bytes)
@ 7 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
73 16 1 java.lang.Object::<init> (1 bytes)
73 1 3 java.lang.Object::<init> (1 bytes) made not entrant
73 13 3 java.io.WinNTFileSystem::isSlash (18 bytes)
73 14 s 3 java.lang.StringBuffer::append (13 bytes)
@ 7 java.lang.AbstractStringBuilder::append (29 bytes)
@ 7 java.lang.AbstractStringBuilder::ensureCapacityInternal (16 bytes)
@ 12 java.lang.AbstractStringBuilder::expandCapacity (50 bytes) callee is too large
74 15 3 java.lang.String::length (6 bytes)
74 17 3 java.lang.String::getChars (62 bytes)
@ 9 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 27 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 43 java/lang/StringIndexOutOfBoundsException::<init> (not loaded) not inlineable
@ 58 java.lang.System::arraycopy (0 bytes) intrinsic
76 18 3 java.lang.Math::min (11 bytes)
78 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
79 20 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
79 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
80 21 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
81 22 3 com.kurumsaljava.jvm.jol.Calculator::addAll (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
704982704
[/source]

Bizim için ilginç olan bölümleri şu şekilde özetleyebiliriz:

[source language=”java”]

1) 78 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
2) 79 20 1 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
3) 79 19 3 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes) made not entrant
4) 80 21 % 3 com.kurumsaljava.jvm.jol.Calculator::addAll @ 7 (23 bytes)
5) @ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
6) 81 22 3 com.kurumsaljava.jvm.jol.Calculator::addAll (23 bytes)
@ 9 com.kurumsaljava.jvm.jol.Calculator::add (4 bytes)
[/source]

5. satırda add() metodunun addAdll() metoduna taşındığını görmekteyiz. 3. satırda add() metodu depotimizasyon sonucu devre dışı kaldığından, 6. satırda add() metodu tekrar derlendikten sonra addAll() metoduna inline edilmektedir.

JIT tarafından yapılan işlemlerin XML olarak bir dosyaya eklenmesini istiyorsak, JVM i aşağıdaki şekilde çalıştırabiliriz:

[source language=”java”]
c:\>java -server -XX:+UnlockDiagnosticVMOptions -XX:+LogCompilation
com.kurumsaljava.jvm.jit.Calculator 100000
[/source]

Oluşan log dosyasını JitWatch uygulaması ile analiz etmek mümkün.

JVM nasıl çalışır yazı serisinin bir sonraki yazısında buluşmak üzere.


EOF (End Of Fun)
Özcan Acar

JVM Nasıl Çalışır Yazı Serisi – Java Nesne Düzeni (Java Object Layout)

Bu yazımda bir Java nesnesinin hafıza alanında (heap) nasıl yer aldığını yanı sahip olduğu hafiza düzenini (object layout) aktarmak istiyorum. Bu amaçla aşağıda yer alan sınıfı kullanacağım.

[source language=’java’]
public class BirSinif {
boolean b;
char c;
int i;
float f;
double d;
String s;
byte bb;
}
[/source]

Java nesnelerinin hafıza düzenini elde etmek için JOL isimli aracı kullandım. Burada JOL kullanım örneklerini bulabilirsiniz.

Yukarıda yer alan BirSinif isimli sınıfın hafıza düzenini JOL aracılığı ile şu şekilde edinebiliriz:

[source language=’java’]
public static void main(String[] args) throws Exception {
System.out.println(ClassLayout.parseClass(BirSinif.class).toPrintable());
}
[/source]

Ekran çıktısı şu şekilde olacaktır:

[source language=’java’]
com.kurumsaljava.jvm.jol.JOLSample1$BirSinif object internals:

OFFSET SIZE TYPE DESCRIPTION VALUE
0 12 (object header) N/A
12 4 int BirSinif.i N/A
16 8 double BirSinif.d N/A
24 4 float BirSinif.f N/A
28 2 char BirSinif.c N/A
30 1 boolean BirSinif.b N/A
31 1 byte BirSinif.bb N/A
32 4 String BirSinif.s N/A
36 4 JOLSample1 BirSinif.this$0 N/A

Instance size: 40 bytes
Space losses: 0 bytes internal + 0 bytes external = 0 bytes total
[/source]

BirSinif sınıfından bir nesne oluşturulduktan ve hafızada konuşlandırıldıktan sonra bu nesne arka arkaya dizilmiş byte elementlerinden oluşan bir düzene sahip olacaktır. Bir Java nesnesinin hafızada kapladığı alan hep sekizin katlarıdır.

Nesnenin kapladığı hafıza alanının ilk 12 byte elementi nesne başlığını (header) teşkil etmektedir. Başlık bünyesinde mark word ve klass pointer ismini taşıyan yapılar yer almaktadır. Klass pointer 32 bitlik sistemlerde 4 byte uzunluğundadır ve nesnenin heap hafıza alan adresini ihtiva etmektedir. 64 bitlik sistemlerde bu alan 8 byte uzunluktadır. 64 bitlik sistemlerde nesne hafıza alanı adreslerinin 4 byte artış göstermesi CPU belleklerinde (cache) daha az sayıda nesne referansi tutulabilmesine sebebiyet vermiştir. Bu aynı anda daha az sayıda nesne üzerinde işlem yapıldığı anlamına gelmektedir. Bu sorunu gidermek için compressed oops (ordinary object pointers) mekanizması kullanılmaktadır. 64 bitlik bir sistemde tüm hafıza alanı 2^64 genişliğindedir. Bu genişlikteki alanı sadece 64 bit ile adreslemek mümkündür. Bu yüzden klass pointer 8 byte uzunlulğunda olmak zorundadır. 64 bitlik sistemlerde compressed oops mekanizması kullanıldığında, klass pointer 4 byte uzunluğu ile yetinmekte ve bu değer adres offset değeri olarak kullanılarak, yine teoride 64 bitlik adres alanını adreslemek için kullanılabilmektedir. -XX:+UseCompressedOops JVM parametresi ile compressed oops mekanizması yönetilebilmektedir.

Nesne başlığının diğer parçası olan mark word 32 bit sistemlerde 4, 64 bit sistemlerde 8 byte uzunluğundadır ve nesne lock, nesnenin yaşı, hash değeri, hangi thread tarafından bloke edildiği ve garbage collection işlemleri için kullanılmaktadır. Markoop.hpp dosyasında bu yapının tanımlaması yer almaktadır. Aşağıdaki alıntıda 32 bit ve 64 bit sistemlerde mark word yapısının nasıl şekillendirildiği yer almaktadır.

[source language=’java’]

// 32 bits:
// ——–
// hash:25 ————>| age:4 biased_lock:1 lock:2 (normal object)
// JavaThread*:23 epoch:2 age:4 biased_lock:1 lock:2 (biased object)
// size:32 ——————————————>| (CMS free block)
// PromotedObject*:29 ———->| promo_bits:3 —–>| (CMS promoted object)
//
// 64 bits:
// ——–
// unused:25 hash:31 –>| unused:1 age:4 biased_lock:1 lock:2 (normal object)
// JavaThread*:54 epoch:2 unused:1 age:4 biased_lock:1 lock:2 (biased object)
// PromotedObject*:61 ———————>| promo_bits:3 —–>| (CMS promoted object)
// size:64 —————————————————–>| (CMS free block)
//
// unused:25 hash:31 –>| cms_free:1 age:4 biased_lock:1 lock:2 (COOPs && normal object)
// JavaThread*:54 epoch:2 cms_free:1 age:4 biased_lock:1 lock:2 (COOPs && biased object)
// narrowOop:32 unused:24 cms_free:1 unused:4 promo_bits:3 —–>| (COOPs && CMS promoted object)
// unused:21 size:35 –>| cms_free:1 unused:7 ——————>| (COOPs && CMS free block)

[/source]

Nesne başlığının ardından sınıf bünyesinde kullanılan sınıf değişkenleri için rezerve edilen byte elementleri gelmektedir.

BirSinif bünyesinde birçok veri tipine sahip değişkenler yer almaktadır. Bu değişkenlerin kapladıkları hafıza alanlarını aşağıda görmekteyiz.

[source language=’java’]
12 4 int BirSinif.i N/A
16 8 double BirSinif.d N/A
24 4 float BirSinif.f N/A
28 2 char BirSinif.c N/A
30 1 boolean BirSinif.b N/A
31 1 byte BirSinif.bb N/A
32 4 String BirSinif.s N/A
36 4 JOLSample1 BirSinif.this$0 N/A
[/source]

Int görüldüğü gibi 4 byte genişliktedir ve 32 bit değerleri ihtiva edebilmektedir. Buna karşın double 8, float 4, char 2, boolean 1, byte 1 ve String 4 byte genişliktedir. Hepsini topladığımızda BirSinif sınıfından olan bir nesnenin hafızada kapladığı alan 40 byte büyüklüktedir.

Bu yazımda Java nesnelerinin hafızadaki düzenlerine değindim. “JVM Nasıl Çalışır” başlıklı yeni yazı serisine JVM bünyesinde olup, bitenlere ışık tutmak için yeni blog yazılarımı yakında sizlerle paylaşacağım.


EOF (End Of Fun)
Özcan Acar