Kategori arşivi: Yapay Zeka
Video: Hangi Programlama Dilini Öğrenmeliyim?
LLM’ler Deterministik Output Üretmezmis!
Su anda LLM’lerin daha iyi ve hizli kod yaziyor olmalarina karsi duydugun tek argüman: “LLM’ler deterministik output üretmez”.
Fable 5 / Opus 4.8 ile calisin, deterministik output ne anlama geliyor, görün. Ondan sonra bu konuyu tekarr degerlendirelim :)
LLM’lerle calisirken önemli olan derleyicilerdeki gibi ayni input icin ayni output’u almak degildir. Önemli olan ayni input icin ayni derecede iyi calisan outputlar alabilmektir ki bunu Fable 5 ve Opus 4.8 gereginden fazla sagliyorlar.
Siz programci olarak ayni algoritmayi iki gün sonra yazsaniz ayni kodu olusturamazken, LLM’lerden bunu bekliyor olmak garip degil mi? Nasil sizin bir algoritma icin yazdiginiz iki degisik kod ayni neticeyi verecekse (dogru programladiysaniz), LLM’lerin de ayni sorun icin degisik kodlar üretiyor olmasi bir zayiflik degil, zenginliktir.
Önemli olan kodun nasil yapilandirildigi degildir. Önemli olan sizin beklentilerinizdir, yani spesifikasyondur. Bu yerine geldigi sürece makina kodu bile olsa makbuldür, cünkü ben kodu okuyarak degil, onun calisir durumda ve bir uygulama davranisina dönüstügü yerde test ederek dogrulugunu saglayabilirim.
Bu arada refactoring nasil yapildigini hatirlayalim. Refactoring kodu dis davranisini degistirmeden, ic yapisini yeniden yapilandirma islemidir. Yani uygulamayi ben dis davranisini koruyarak, komple baska bir mimariye rafactor edebilirim. Burada kod %100 bile degismis olabilir, lakin dis davranisi hala aynidir. Yani refactoring öncesi e sonraki iki degisik kod mevcuttur, ama ikisi de ayni seyi yapiyordur. LLM’de bunu yapiyor sadece ve cok daha iyi yapiyor.
Programlama Dilleri Tarihe Karışıyor
Yüksek dillerin ortaya cikma nedeni ne? Assembly neden yetmedi?
Gelin simdi neden cok uzun zamandir kod yazmadigimiza bir göz atalim.
Kod derleyiciler icat edilmeden önce dogrudan makina icin yazilirdi. Yüksek dillerin ve onlarin derleyicileri icat edildikten sonra programcilar makina icin kod yazmayi biraktilar. Bütün gerekli kodu ve optimizasyonu derleyiciler yazmaya basladi. Programcilar sadece bir üst soyutluk seviyesinden makinadan ne beklediklerini ifade etmeye, yani deklaratif programlamaya basladilar.
Bu günümüze kadar böyle devam etti. Bugün kod olarak ifade edilen bir Java ya da C yapisi bellli bir syntax icinde kaleme alinmis bir programci niyetidir. Onu ve cok daha fazlasini makina icin anlasilabilir koda derleyiciler dönüstürür. O dönüsen kodu bugün akici bir sekilde okuyup, anlayabilecek insan sayisi cok az, o seviyede makina kodu kodlayacak insan da yoktur.
O halde söyle bir tespit yapalim. Yazilimcilar zaten kod yazmiyorlar, sadece niyetlerini kaleme aliyorlar.
Ikinci tespit su sekilde olsun: Yapay zeka ile yazilan promptlar da niyetten baska birsey degildir.
Ücüncü tespit: Artik kodu LLM’ler yaziyor, yani niyeti (prompt) koda dönüstüren LLM’ler.
Dördüncü tespit: Cagimizin derleyicileri LLM’lerdir.
O halde su sonucu cikarabiliriz: frontend ve backend’in LLM tarafindan hangi dilde yazildigi artik önem tasimamaktadir. LLM bugün promptlari dogrudan 1010101010 lardan olusan makina koduna dönüstürse, yeridir.
Cok kisa bir zaman sonra Java, C, Python gibi diller tarihe karisacak ve promptlarin belli bir syntax ile daha güclü ifade etmeyi mümkün kilacak programlama dilleri ortaya cikacak.
Video: Yazılımcılar Kod Yazıyor mu?
Video: Yazılımcı Mülakatları
Video: Pratikte Loop Engineering
Video: Yapay Zeka ve Testler
Video: Prompt Engineering
Tek Bir Tasla Iki Kus
Benim icin yeni calisma modeli loop engineering + jira kanban.
Su an aktiv iki döngü calisiyor, backend proje ve mobil proje icin.
Mobil kisminda yeni bir backend api’ye ihtiyac duyan yeni bir özellik olusturmak istedigimde, su sekilde ilerliyorum:
- Mobil kanban board icinde yeni uygulama özelligi icin bir ticket aciyorum. Orada detayli olarak ihtiyac duydugum uygulama özelligini ve backend api’yi de tanimliyorum.
- Bilgisayarimdaki mobil loop bir ticketi aldiktan sonra backend projesinde yeni api icin gerekli ticketi aciyor.
- Mobil loop yeni jira ticketi aliyor ve gerekli loop planini olusturuyor. Bu noktadan itibaren yeni uygulama özelligi implemente ediliyor.
- Backend loop board üzerinde yeni bir ticket var mi sorgusunu yapiyor ve yeni api icin gerekli ticketi buluyor. Bu ticketi indirip, backend icin yeni bir loop plani olusturuyor.
- Mobile paralel olarak diger döngü icinde backend api implementasyonu basliyor.
- Ikisi tamamlandiktan sonra ben iki kanban board icinde ticketlerin TEST kolonuna kaydirildigini görüyorum. Bu noktadan itibaren gerekli testleri yapmaya basliyorum.
Tek bir tasla iki kus vurma buna deniyor sanirim ;-)
Rate Limit Problemi
Loop engineering sayesinde rate limitler sorun olmaktan cikiyor.
Rate limit LLM’i saglayan sirketin size koydugu token kotalaridir. Bu kotalar genelde 5 saatlik ve haftalik zaman dilimlerinde resetlenir. Ne kadar SIK LLM ile interaksiyona girerseniz, o kadar cok token harcaniz ve o hizda da kotaniz dolar.
Dün ilk gpt 5.5 rate limitler gelmeye basladi, cünkü codex dakika basi jira’ya baglanip, yeni ticket var mi diye bakmaya baslamisti. Bu kullandigi contexti hizli bir sekilde sisirir hale getirdi.
Rate limit ne zaman sorun olmaya basliyor? LLM ile konsol araciligi ile interaksiyona giriyorsaniz, yani prompt engineering yapiyorsaniz, yani basina bekliyorsaniz.
Ama tam otonom calisan bir loop engineering setup bünyesinde artik saatlik ve haftalik kotalar problem olmaktan cikiyor, cünkü döngü icinde bir rate limit aldiginizda, o döngü while(true) semantiginde calistigi icin sürekli yapilmasi gereken son islemi tekrar ediyor. Er ya da gec rate limit kalkacagi icin, bir sonraki islem baslamak ve sonlanmak zorunda.
Benim örnegimde son rate limit örnegin sabah 04:00 civarinda gelmis. Bunun üzerinde codex 3 saat bekledikten sonra 07:00 de islemlere devam etmis ve aksam tanimladigim tüm jira ticketleri calismis ve test kolonuna göndermis.
Bu durrumda ben basinda beklemedigim icin gelen kota sinirlamalari beni artik baglamiyor, cünkü basinda beklemiyorum, codex ile interaksiyona girmiyorum.
Sadece bu sebepten dolayi bile loop engineering altyapisi kurmak mantikli, cünkü rate limit artik sistemin bir yan etkisi olmaktan cikti ve programci olarak bizim calisma tarzimizi sekillendirir oldu.
Zeki olan kim burada? Cikan sorunlari sürekli cözme egilimi olan programci mi yoksa yapay zeka mi? (not: zekiyim filan demedim, yanlis anlasilmasin :) )
Video: Vide Coding
Sadece Gereksinim Analizi Yapıyorum
Loop engineering tam otomasyon üzerine kurgulu degilse, yapay zeka ile yapacagi isler konusunda interaksiyon gerekiyor. Bir önceki yazimda tam otomasyon icin kuyruk yapilarinin nasil kullanildigindan bahsettim. Bu yazimla birlikte uygulama gelistirmeye yaklasim tarzimin nasil degistigini aktarayim.
Asagidaki resimde son yarim saat icinde irili, ufakli yaptirdigim isleri görüyorsunuz. Bu kanban boardda yer alan ticketleri ben ready kolonuna koydum ve gerisini loop yapan codex + opus ikilisi halletti.
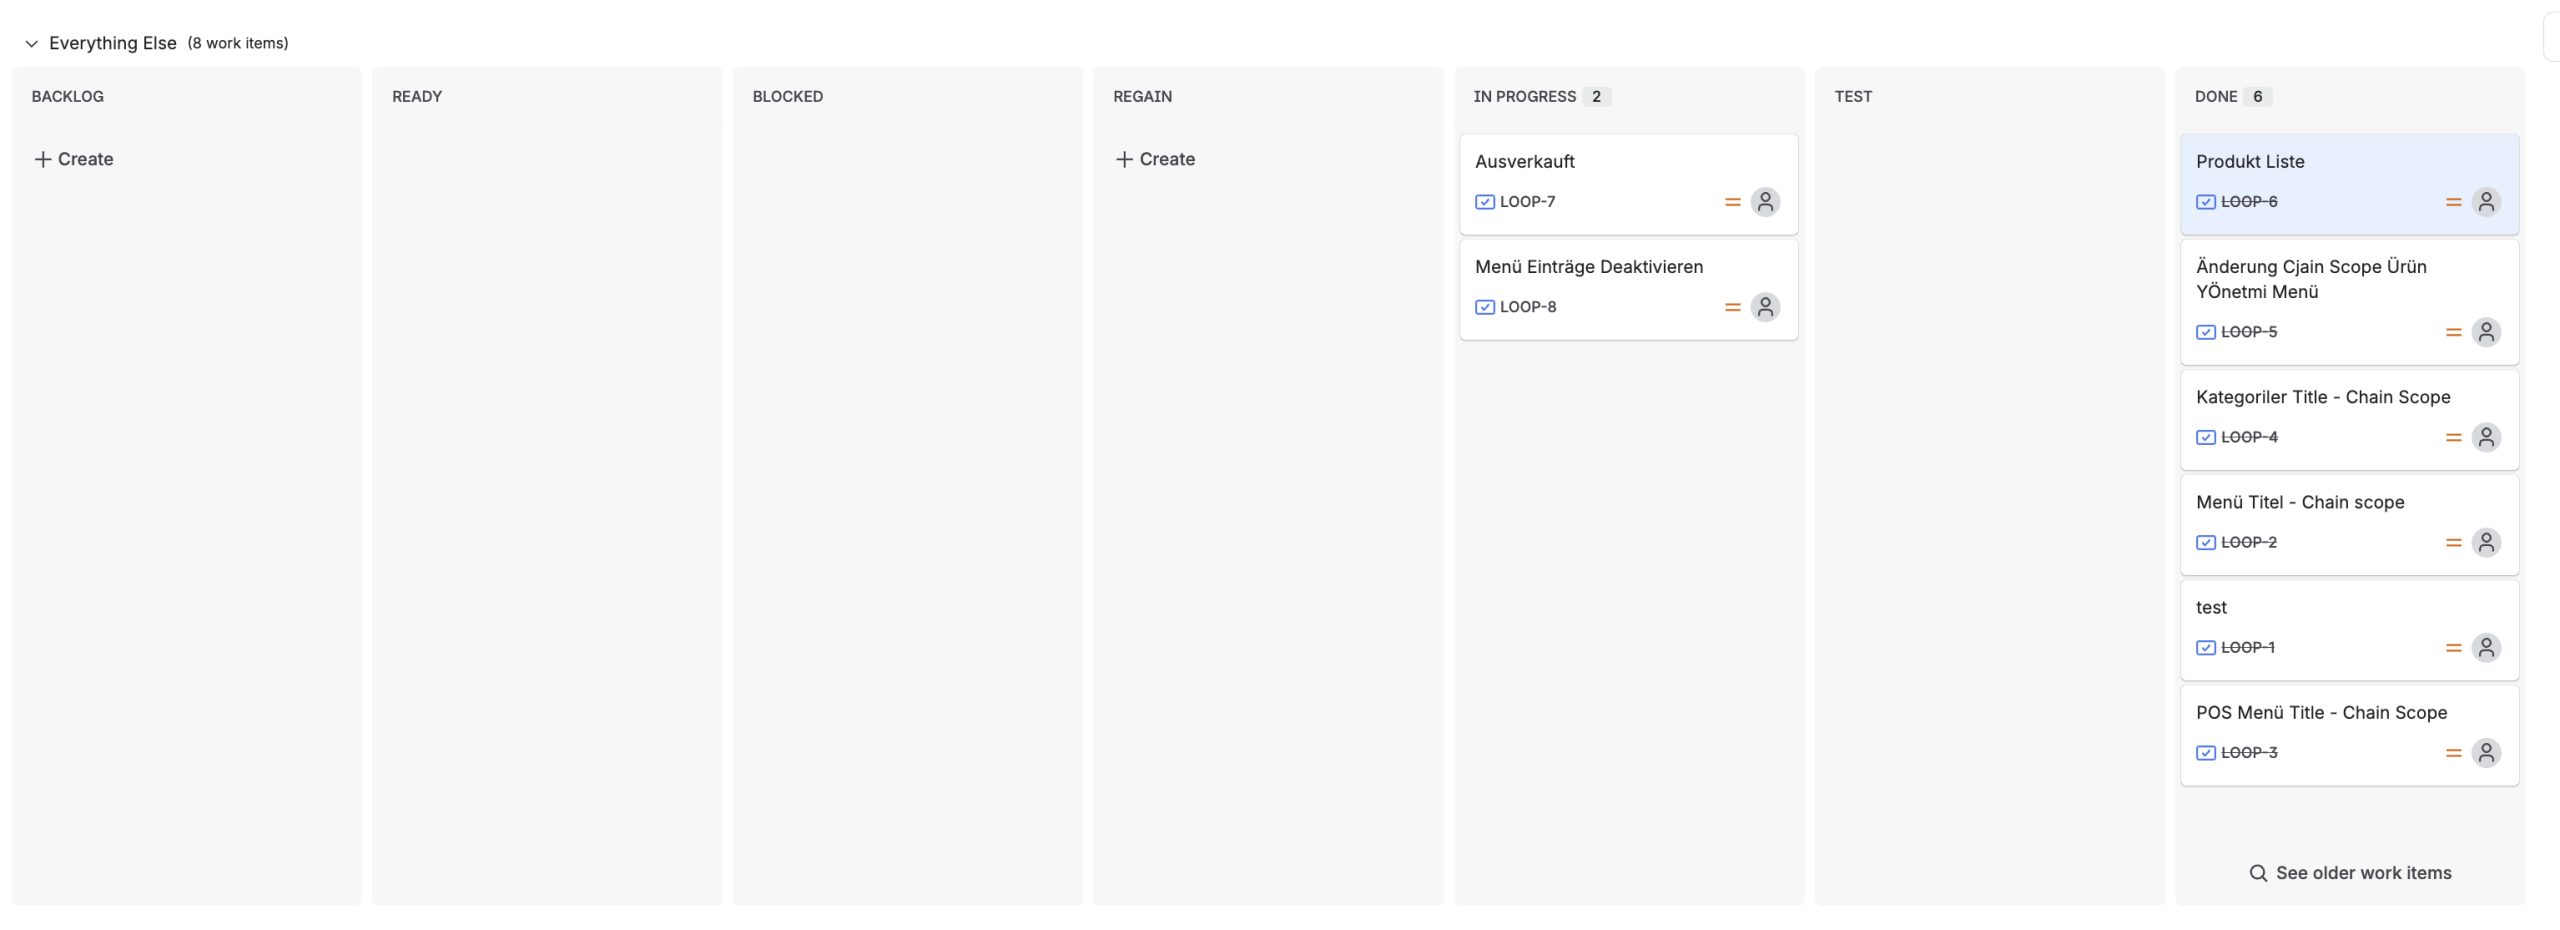
Bundan önceki sürümde ne durumda oldugumuzu anlamak ve neyin test edilmesi gerektigini ögrenmek icin codex’e en son ne yaptiklarini raporlamasini istiyordum. Konsol üzerinden gerceklesen bu interaksiyon ne yazik ki kaosa neden oluyordu. Bu kaosu düzenlemek icin asagida gördügünüz kanban boardu olusturdum.
Simdi yapmam gereken dört sey:
- yeni uygulama özellikleri icin bir ticket olusturma,
- onu ready kolonuna cekme,
- arada bir test kolonunda bitmis is var mi diye bakma,
- burayi bos birakiyorum, ne yapacagimi sonra düsünürüm ;-)
Bu kadar!
Opus ile günlerdir konusmadim bile. O artik codex icin calisan programci. Codex’de benim icin calisan proje yöneticisi. Bense artik hizli bir sekilde uygulamayi test edip, eksikleri görüp, onlar icin yeni ticket acan product owner.
Yani isler kebap!
Bundan sonraki adim: bu sistemi 10x calisacak sekilde replike etmek.
Tam Otonom Yazılım İçin Kuyruk Yönetimi
Eger hale bir yapay zeka araci ile interaksiyon halindeyseniz, loop engineering bile olsa tam otonom yazilim yaptirmiyorsunuz.
Tam otonom yazilim icin ne gerekli?
Bir kuyruk (queue) sistemi. Bunun en güzel örnegi Jira.
Benim örnegimde:
- Jira altinda bir Kanban board olusturdum.
- Tüm yeni gereksinim, degisiklik ve bugfix icin yeni bir ticket olusturuyorum. Bu ticket hazirlanis esnasinda Backlog kolonunda yer aliyor. Ticket hazir hale geldikten sonra onu Ready kolonuna aliyorum.
- Codex icinde bir cronjob calisiyor ve dakika basi Codex ready kolonunda yeni bir ticket olup, olmadigina bakiyor. Yeni bir ticket varsa, onu alarak yeni bir loop plani olusturuyor. Akabinde bu yeni planini LOOP-PLANS.md dosyasina ekliyor. Bu alt katmanda islerin takip edildigi kuyruk.
- Codex sirasi gelen loop planini LOOP-PLANS.md dosyasindan alip, LOOP.md dosyasina ekliyor ve statüsüne READY_FOR_OPUS olarak isaretliyor.
- Claude code bünyesinde de bir cronjob calisiyor ve opus dakika basi LOOP.md dosyasinda yapmasi gereken yeni bir is var mi diye bakiyor. Yeni bir is buldugunda statüyü IN_PROGRESS olarak degistiyor. Isi tamamladiginda bu statü READY ye geciyor. Sorun cikarsa ya da sorulari varsa REVIEW_FOR_CODEX olarak statüyü güncelliyor.
- Eger loop tamamlandi ise Codex Jira altindaki ticketi Test kolonuna aliyor. Bu sekilde ben test edilecek yeni özellikleri takip ediyorum. Eger test ederken bir sorun cikarsa, bu ticketi Regain kolonun aliyorum, gerekli yorumlari yapiyorum Codex bu kolondo olan ticketleri toplayarak, gerekli calismalari organize ediyor.
- Eger Codex bir sorunla karsilasirse, gerekli notu düserek ticketi blocked kolonuna aliyor. Bu sekilde bende yarim kalan seyleri tamamlayarak, ticketi tekrar regain kolonuna aliyorum.
Bu sekilde döngü kendisini tekrar ediyor. Ben artik tamamen uygulama özelliklerine odaklaniyorum, codex ise teknik implementasyona ve görev dagilimina. Bu bilgisayarim 7×24 acik kaldigi sürece calisan bir döngü.
Video: Yazılım Ürünlerinin Geleceği
Araç Kullanımı Değişiyor
Dünkü paylastigim videoda yazilim nereye evriliyor soruna cevap vermeye calismistim. Kullandigim araclarin nasil degistigine dair bugün gözlemledigim bir degisiklikten daha bahsetmek istiyorum.
Prompt engineering yaparken sürekli github copilo cli / claude code cli ile konsolde calisiyordum. Loop engineering yöntemine gectikten sonra bu son buldu. Artik claude arka planda headless calisiyor. Benim interaksiyona girdigim tek arac codex desktop.
Ben bir döngüyü baslattik sonra bir sonraki feature analizine basliyorum ve arka plana codex ve opus tam otonom mevcut uygulama özelligini hayata geciriyorlar.
Video: Yazılım Nereye Evriliyor?
Loop Engineering ve Manuel Testler
Yazilim yaparken tek darbogaz her zaman insanin kendisiydi.
Eskiden yazilimcilar kod yazmaya yetisemezken, simdilerde kod review yapmaya ve yapilan degisiklikleri takip etmeye yetisemiyorlar.
Kendimden somut bir örnek vereyim. Dünden beri codex + opus tam otonom iki büyük uygulama özelligini loop engineering yönetimi ile implemente ettiler. Test edilecek 30 dan fazla testcase olustu. Yüzlerce yeni sinif ekledi, binlarce satir kod olustu. Simdi kara kara “bunu da nasil otomatize edebilirim” diye düsünüyorum. Code review tarafi beni ilgilendirmiyor. Testcase’lere odaklanmam lazim.
Her test sonrasinda opus’a “su eksik, bu calismiyor, sunu tamamla” demek istemiyorum, cünkü onunla interaksiyona girdigim andan itibaren yine basinda oturmam gerekiyor. Bu artik yapmak istemedigim birsey. Bu yüzden yine loop engineering metodunu kullanarak, testleri birbir yapacagim ve buldugum hatalari codex’e yeni loop planlari olusturmak üzere bildirecegim. Testler tamamlandiktan sonra yine bu ikili benim yazdiklarim araciligi ile eksikleri giderecekler.
Yani loop engineering sadece otonom kod yazdirmak icin degil, cikan sonuclari da tekrar test ederek, iyilestirmek icin kullanilabilecek bir yöntem.